MiMo Code:把程式設計代理擴展到長時程任務 作者:小米 MiMo 團隊 · 2026-06-10
MiMo Code 是由小米 MiMo 團隊在 OpenCode 之上打造的終端機原生程式設計代理,並以 MIT 授權開源。它的設計目標是長時程自動化程式設計任務,核心關注的是:當執行步驟累積到數十甚至數百步時,該如何維持決策品質與狀態連續性。本文將從三個主題——運算(computation)、記憶(memory)、演化(evolution)——介紹 MiMo Code 的核心技術設計。
1. 設計動機
程式設計代理的基本結構,是把一個語言模型放進 runtime 裡反覆呼叫:模型負責推理與決策,runtime 負責管理工具、持久化狀態,並組裝每一輪的輸入。模型本身是無狀態的——每次呼叫都從空白開始,所有連續性都由 runtime 提供。
對於短任務(通常少於 10 輪)來說,這個結構運作得很好:把完整對話歷史直接餵給模型就夠了,因為歷史本身就是合格的工作記憶。但隨著任務輪數增加,兩個問題會逐漸浮現。
第一,context window 終究會耗盡。 不管 window 多大,數十輪的工具輸出、程式碼片段、錯誤紀錄,最終都會塞滿。這時就必須壓縮或丟棄部分歷史。常見做法是產生一段摘要來取代被丟棄的內容。但單純的壓縮會不斷強化鄰近資訊、弱化遠端資訊。這種做法會撞上類似 Mamba 這類循環模型的天生矛盾:有狀態,卻沒辦法按需回頭查看。我們真正需要的不是更好的壓縮,而是一套明確的「儲存—取回」機制,決定哪些資訊該寫入持久化結構、什麼時候該召回。
第二,就算 context window 夠大,模型的指令遵循能力也會隨著輸入長度增加而下降。 有用的限制與意圖會被大量工具輸出稀釋,模型愈來愈難抽取出「下一步該做什麼」。
我們觀察到,不同時間尺度上的瓶頸各不相同:單輪決策品質主要由「運算」決定;單一 session 內多輪任務的連續性主要由「狀態管理」決定;而跨 session 的進步則受限於「經驗蒸餾機制」。這三個時間尺度剛好對應到——運算、記憶、演化。MiMo Code 就是圍繞這三個主題設計的。
2. 運算:放大單輪推理
當任務成長到數十甚至數百步時,每一步的錯誤率會隨時間累積,而代理在長時程執行過程中往往缺乏外部校正訊號。直接的回應是:在不同粒度上投入更多運算,換取可靠性——降低單步決策錯誤的機率、避免任務層級的過早終止或方向漂移、減少執行層級的多餘往返。
2.1 平行取樣與篩選(Max Mode)
Max Mode 在每一輪平行生成 N 個候選解(預設 N=5)。每個候選各自獨立完成推理與工具呼叫規劃,但不會真的執行該計畫。接著用同一個模型擔任裁判,比較所有候選的推理過程與行動計畫,從中選出最優的一個來執行。
預設 temperature=1,因此五個獨立樣本幾乎不會產生完全相同的結果。如果多個候選意外收斂,那本身就是「對該方向高度信心」的訊號;當候選之間差異明顯時,由低溫裁判挑選最穩健的方案,會比依賴單一樣本更可靠。
在 SWE-Bench Pro 上,Max Mode 比單次取樣提升了 10–20% 的表現,代價是大約 4–5 倍的 token 消耗。
註:Max Mode 目前是實驗性功能,需要手動透過設定開啟。
2.2 獨立完成驗證(Goal)
Max Mode 解決的是「做對」;Goal 解決的是「做完」。
長任務中常見的一種失敗模式是:在後面幾輪看到已有進度後,代理傾向於過早宣告「完成」或丟出問題。這在自動化執行中特別危險——因為現場沒有真人即時糾正或回饋。
Goal 機制的運作方式如下:使用者用自然語言定義一個停止條件,例如「所有測試通過且程式碼已 commit」。每當代理嘗試終止時,系統會自動啟動一次獨立的模型呼叫,檢視完整對話歷史,判斷該條件是否真的滿足。如果沒有,就把具體落差回饋給代理讓它繼續;如果確認任務無法達成,則標記為 impossible。
這個驗證者不參與實際工作,因此不會對代理已完成的部份產生對齊偏見。每次它接收的 context 都和代理完全一致,包括實際的工具輸出。
實務上「誤擋」——條件其實已滿足、但驗證者判斷為未滿足——比「誤放行」更常見,主要發生在測試因環境問題而失敗時。整體而言,無限迴圈的機率低於 0.5%,且系統到達上限後會自動結束。
Max Mode 與 Goal 代表 test-time compute 的兩個正交方向:Max Mode 是平行的,把 N 倍的運算花在同一步上以選出最佳選項;Goal 是序列的,在同一任務上花更多時間自我檢查與繼續執行。兩者可以同時開啟。
2.3 工具呼叫語法
模型發出工具呼叫的格式,會直接影響準確率與 token 效率。某些模型(特別是 GPT-5.5 系列)在輸出結構化 JSON 時,格式錯誤率偏高,而 XML 的表現稍微好一些。我們最終發現:一種受限的命令列語法,在表達相同的工具呼叫意圖時,需要的 token 更少,產生的格式錯誤也更少,因為大多數模型都已在大量 shell 環境資料上訓練過。這個語法是有意受限的:不支援管線、重新導向、變數展開。目標是借用 shell 的簡潔,而不是給模型一個不受控的執行環境。
MiMo Code 目前還沒把工具呼叫遷移到這個格式。替換作業可能會在未來版本逐步完成。
2.4 大規模平行編排(Dynamic Workflow)
前面幾個機制處理的是「單輪、單一代理」層級的品質問題。當任務規模大到一定程度——例如把整個專案從某個程式語言遷移到另一個——需要同時協調數十甚至數百個平行工作單元時,逐輪工具呼叫就不再夠用。
傳統做法是把流程寫進 SKILL.md,用自然語言告訴模型:「先做 A,再做 B,若發生 C 就做 D。」在簡單情境下這套行得通,但在複雜 workflow 上會系統性地失敗:context 壓縮可能吞掉步驟、模型可能跳過某些階段、分支與重試邏輯只能靠模型判斷而無法由程式碼保證、同樣的 workflow 跑兩次可能走不同路徑。根本問題在於:編排邏輯存在於自然語言中,而自然語言是模糊的、會被遺忘、且無法驗證。
Dynamic Workflow 把編排邏輯從 prompt 搬進程式碼。主要代理會生成一段 JavaScript 腳本,在隔離沙盒中確定性地執行。腳本透過 agent() 分派子代理、用 parallel() / pipeline() 控制並行——if 不會忘記某個分支、for 不會提前退出、barrier 不會漏接子代理。模型的判斷只用在該用的地方,例如理解與生成程式碼,而不是浪費在流程控制上。
我們的實作相容於 Anthropic Dynamic Workflow 的核心語意,並做了幾項延伸。workflow() primitive 允許腳本呼叫其他腳本,因此編排邏輯可以組織成可重用、可組合的積木。每次 agent() 呼叫的結果都會同步寫入磁碟,允許程序在中斷後從紀錄恢復,而不必從頭重跑。沙盒內也可以直接讀寫檔案。我們相信,許多目前以 prompt 形式定義的 skill,將會逐步演化成程式碼形式的 workflow 腳本。當流程的每一步都必須被執行、分支條件必須精準、重試邏輯必須可靠時,就該由程式碼——而不是自然語言——來擔保。
3. 記憶:維持多輪任務的狀態連續性
放大單輪運算可以降低每一步的錯誤率,卻無法解決多輪任務的核心問題:context 終究會用完。本節討論如何讓一個邏輯 session 無限延伸,同時讓每個實體 window 維持在有限範圍內。
3.1 Cycle:無界 session 的基本單位
想像一個 session 是由左到右排列的一連串輪次。Window 有上限,輪次不斷累積,window 終究會被填滿。若不介入,session 要麼在到達上限時結束,要麼悄悄地降級。
在到達上限之前,runtime 會在幾個固定位置介入。我們稱這些位置為 checkpoint。在每個 checkpoint,runtime 會分派一個獨立的 writer 子代理:它讀取目前為止的對話,並把一份結構化狀態檔寫入磁碟。主要代理在 writer 平行運行的同時繼續工作,兩者互不干擾。
當 window 逼近真正的上限時,runtime 會執行一次 rebuild:它切斷當前 window、開啟一個新 window,並用持久化檔案作為種子重建 context。主要代理在新 window 醒來時,狀態已經攤在它面前,接著繼續工作。從模型的角度看,對話從未中斷;從 runtime 的角度看,一個新的實體 window 已經開始。
一段被 checkpoint、最終以 rebuild 作結的輪次序列,稱為 cycle。Cycle 的數量沒有上限——每個 cycle 受限於實體 window 的大小,但邏輯 session 是一串 cycle 的鏈,那條鏈沒有最大長度。
3.2 為什麼要提早抽取
直覺上會以為:等到 window 將近全滿時再抽取就好。我們發現這恰好搞反了。
第一,模型在高 context 使用率下能力會下降。 文獻稱之為「lost in the middle」:隨著輸入變長,模型對中間段的注意力下降,結構化抽取的可靠性也明顯降低。在模型壓縮能力正在衰退的那個當下,要求它執行最關鍵的壓縮,是筆很差的交易。
第二,抽取本身需要空間。 Writer 必須讀取歷史、維持自己的詮釋、產出結構化輸出——全都在同一個 window 內完成。在 95% 使用率時,沒有剩餘空間思考;在 30% 使用率時,空間綽綽有餘。
因此,checkpoint 會在遠低於上限時觸發——大約在設定預算的 20%、45%、70%。每次觸發都是對前一次的增量更新,沒有一發不可收拾的「一次摘要」。在接近上限時的最後一次 rebuild,不是慌張的壓縮,而是把沿途累積的結構化紀錄轉化成工作 context 的時刻。
3.3 Writer:與主要代理獨立的抽取者
最直覺的做法是讓主要代理自己維護筆記。我們發現這在長任務中撐不住:要求一個正在 debug 棘手問題的模型,同時還要維護結構化日誌,往往讓兩件事都做不好。
因此我們加了一條限制:主要代理不維護自己的記憶。抽取完全搬出主迴圈,由 runtime 觸發、由獨立的 writer 子代理執行——它不共享主要代理的注意力,也不共用 token 預算。
Writer 寫出的 checkpoint 檔案有固定結構(11 個欄位:當前意圖、下一個動作、工作限制、任務樹、目前工作、涉及檔案、跨任務發現、錯誤與修復、runtime 狀態、設計決策、雜項筆記),並在需要時更新專案層級的記憶。對每個結構化檔案,僅允許單一寫入者——單寫入是防止並發寫入造成狀態不一致的最簡單不變量。
3.4 四層記憶
Writer 不只寫一份檔案。它維護一套分層記憶系統,每一層有不同的生命週期:
- Session memory(checkpoint.md):只活在當前邏輯 session 內,記錄該 session 完整的工作狀態。
- Project memory(MEMORY.md):跨 session 持久的專案層級知識——架構決策、使用者規則、被反覆驗證過的技術事實。當某項觀察在多次 session checkpoint 中穩定下來,writer 就會把它從 session 層晉升到這一層。
- Global memory:跨專案生效的使用者偏好。
- History:每個 session 的完整 SQLite 軌跡——每則訊息、每次工具呼叫的原始文字,不建立索引。當結構化記憶找不到某個細節時,代理就用 history 工具回溯原始紀錄。
四層之間的關係是:上層更精煉、更持久、更小;下層更完整、較大、較慢。Writer 負責向上蒸餾,History 作為下層的退路。
主要代理對結構化檔案只有讀取權限,唯一例外是 notes.md——一份 session 層級的自由格式暫存板。主要代理可以隨時把零散發現附加進去;在每次 checkpoint 時,writer 讀取它、把內容路由到對應的結構化欄位,然後清空。這是主要代理唯一可用的寫入通道。
3.5 Rebuild 注入
當 runtime 執行 rebuild 時,它會把持久化檔案組合成一份分層 prompt 注入新 window,每個段落有獨立的 token 上限。粗略順序為:任務清單(代理首先得知道要做什麼)→ session checkpoint → 最近使用者訊息的逐字切片(防止 writer 改寫後偏離使用者原意)→ project memory → global memory → notes → 可按需讀取的記憶檔案路徑索引 → 告訴代理下一步該做什麼的尾部提醒。
即使每個段落都到上限,注入的總內容也控制在約 65K tokens 內——任何合理 context window 都能輕鬆容納。代理從這份資訊中恢復狀態後,會直接接續工作,不需要重新確認目標或重讀已處理過的檔案。
4. 演化:從經驗中持續改進
前兩節處理的是「如何在單輪與單一 session 中把工作做好」。但在真實開發中,使用者可能會跟同一個專案互動數十甚至數百次。如果每次 session 結束後所有經驗都流失,代理永遠無法從過去的工作中累積——它得每次重新摸索相同的專案限制、重蹈相同錯誤。
4.1 專案記憶
MiMo Code 維護一份專案層級的記憶檔(Markdown 格式),跨 session 持久儲存以下知識:專案背景、使用者明確指定的規則、架構決策及其理由、被反覆驗證過的技術事實。
之所以選擇檔案而非純向量資料庫,核心原因是可審查性:一旦記憶影響代理後續行為,使用者需要能夠看到系統記住了什麼、刪掉錯誤條目、修改過時的知識。檔案可以由標準讀寫工具直接操作,不需要為每個維運操作都做專屬介面。檔案之上再加一層全文索引以提供快速取回。
Checkpoint writer 每次觸發時只更新當前 session 的 checkpoint,寫入權限在程式碼層級強制。後台 writer 只能寫入指定檔案路徑,任何越界寫入會被直接拒絕。
4.2 記憶維護(Dream 與 Distill)
專案記憶檔會隨時間成長。若不維護,過時條目、重複紀錄、無效的檔案引用會逐漸堆積,讓訊號雜訊比下降。
Dream 每 7 天自動觸發一次。一個獨立代理會讀取歷史 session 對話與現有記憶檔,然後執行合併、去重、路徑有效性驗證與壓縮——把分散的記憶收斂成當前狀態的緊湊表示,並更新 global memory。
Distill 每 30 天自動觸發一次。它同樣由獨立代理讀取歷史 session,但關注的不是知識,而是流程。它會辨識反覆出現的工作模式,把它們固化成可重用的 skill、CLI 命令、自訂代理、SOP 文件等產物。
5. 評測
5.1 離線基準
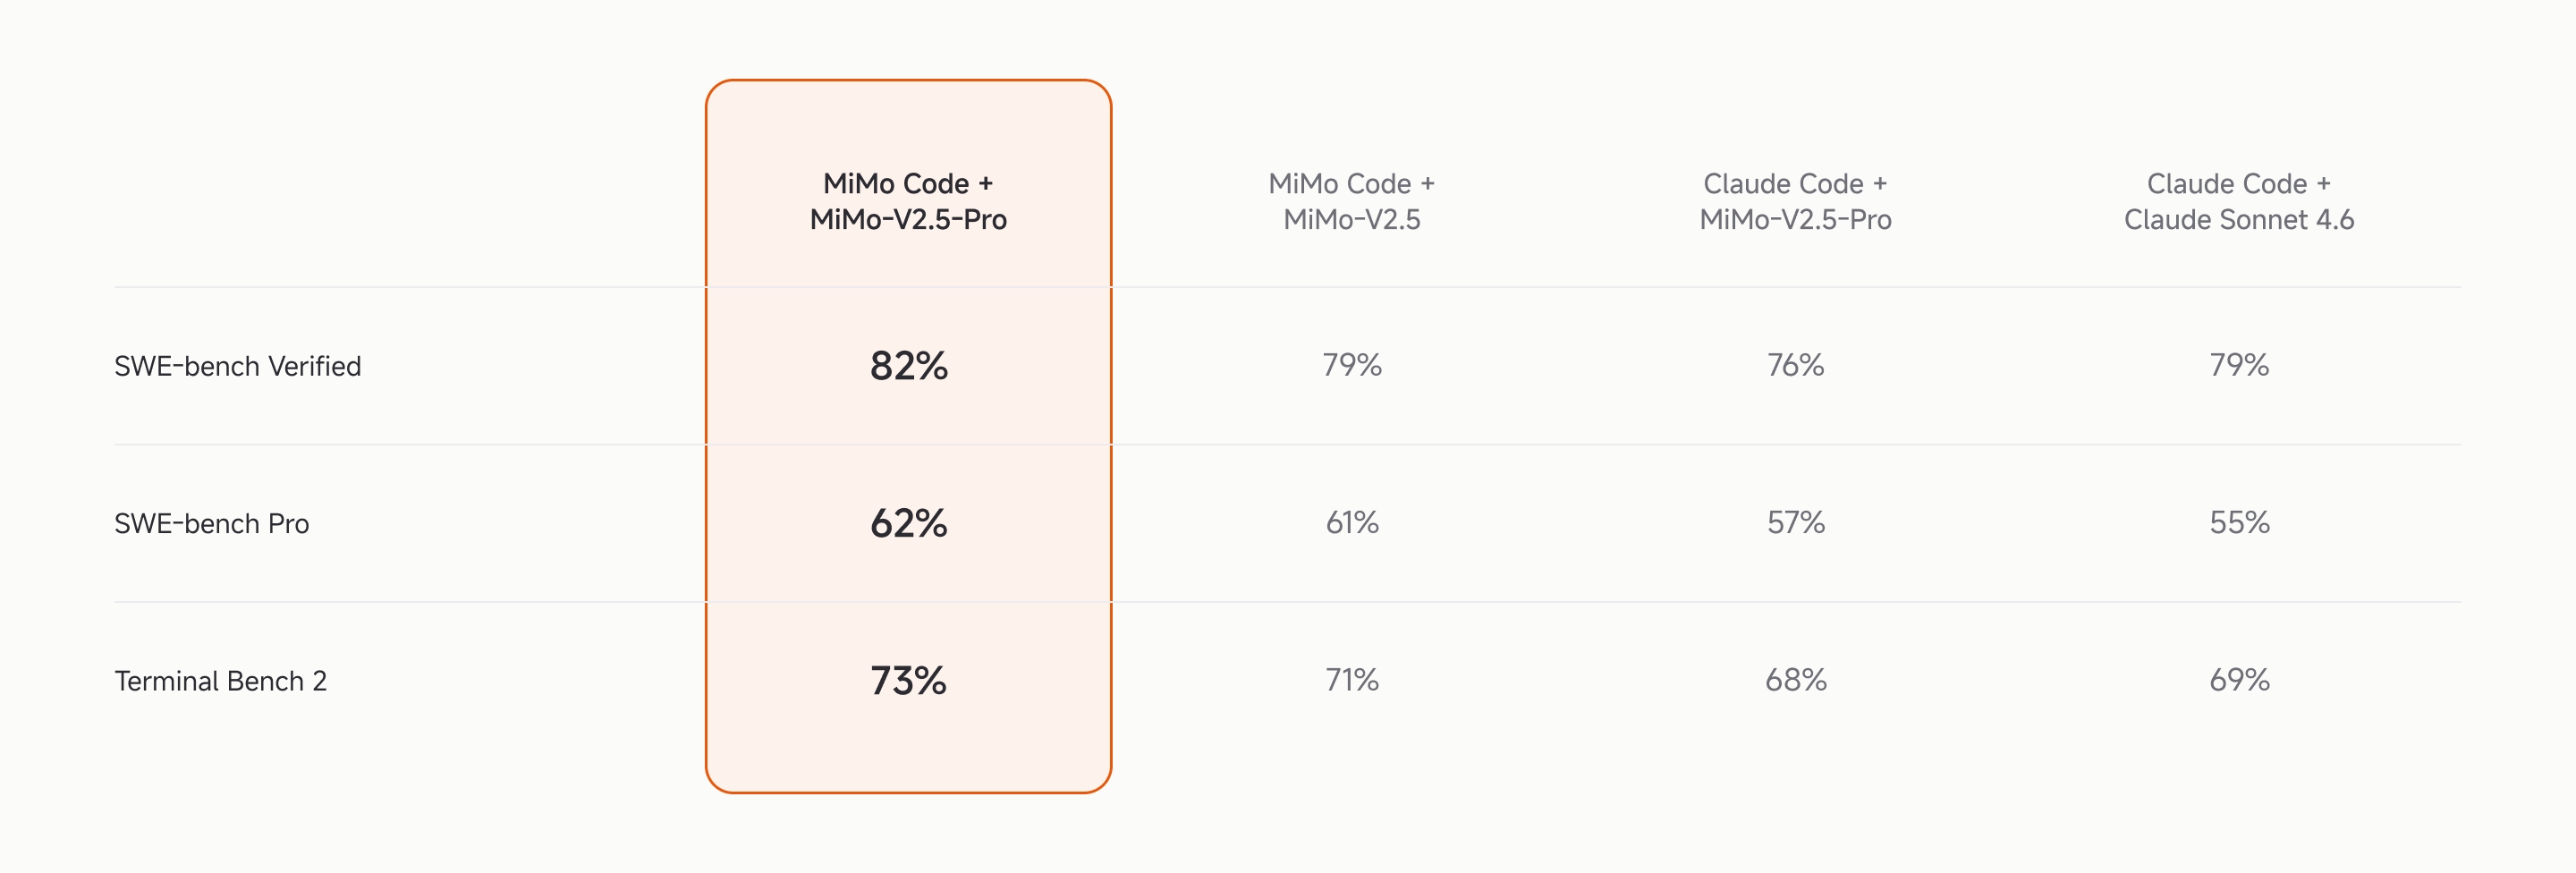
下表顯示 MiMo Code 與 Claude Code 搭配不同模型時,在三項主流基準測試上的表現。
MiMo Code 搭配 MiMo-V2.5-Pro,在三項評測中皆優於 Claude Code 搭配 Claude Sonnet 4.6。但必須說明,這些基準測試仍是在單一 repository 級別議題上量測「一次性解題能力」。MiMo Code 多數設計目標——多輪記憶、後台狀態維護、完成驗證、跨 session 演化——主要價值要等到延續數十輪的真實開發場景中才會展現。這些優勢只有實際使用過才看得出來。
5.2 真人雙盲 A/B 測試
為了解決離線基準的限制,我們建了一套「人-in-the-loop」雙盲 A/B 評測:在開發者自己的真實專案中,針對同一任務平行啟動兩個匿名程式設計代理。兩者各自獨立完成任務後,由開發者評分,並以自動軌跡評分與 diff 量化做三角校驗。
報告期內,內部 beta 涵蓋 576 名開發者、474 個真實私有 repository,產出 1,213 對具明確勝負結果的 A/B 配對,比較的是「同一目標模型下」MiMo Code 與 Claude Code 端到端的真實開發體驗。
評測中我們發現:MiMo Code 的優勢會隨任務複雜度提升而擴大——當執行步數在 200 以內時,兩套系統勝率接近 50%;當步數超過 200(含多輪使用者互動)時,MiMo Code 勝率上升到 65% 以上。
6. 使用方式
首次啟動時,MiMo Code 會引導使用者選擇模型存取方式:MiMo Auto(限時免費,基於 MiMo-V2.5,支援 1M token context)、登入小米 MiMo 平台、從 Claude Code 設定匯入,或使用自訂模型。
GitHub:https://github.com/XiaomiMiMo/MiMo-Code 官方技術部落格:https://mimo.xiaomi.com/blog/mimo-code-long-horizon 授權:MIT
相關多媒體
 MiMo Code 終端介面(小米官方)
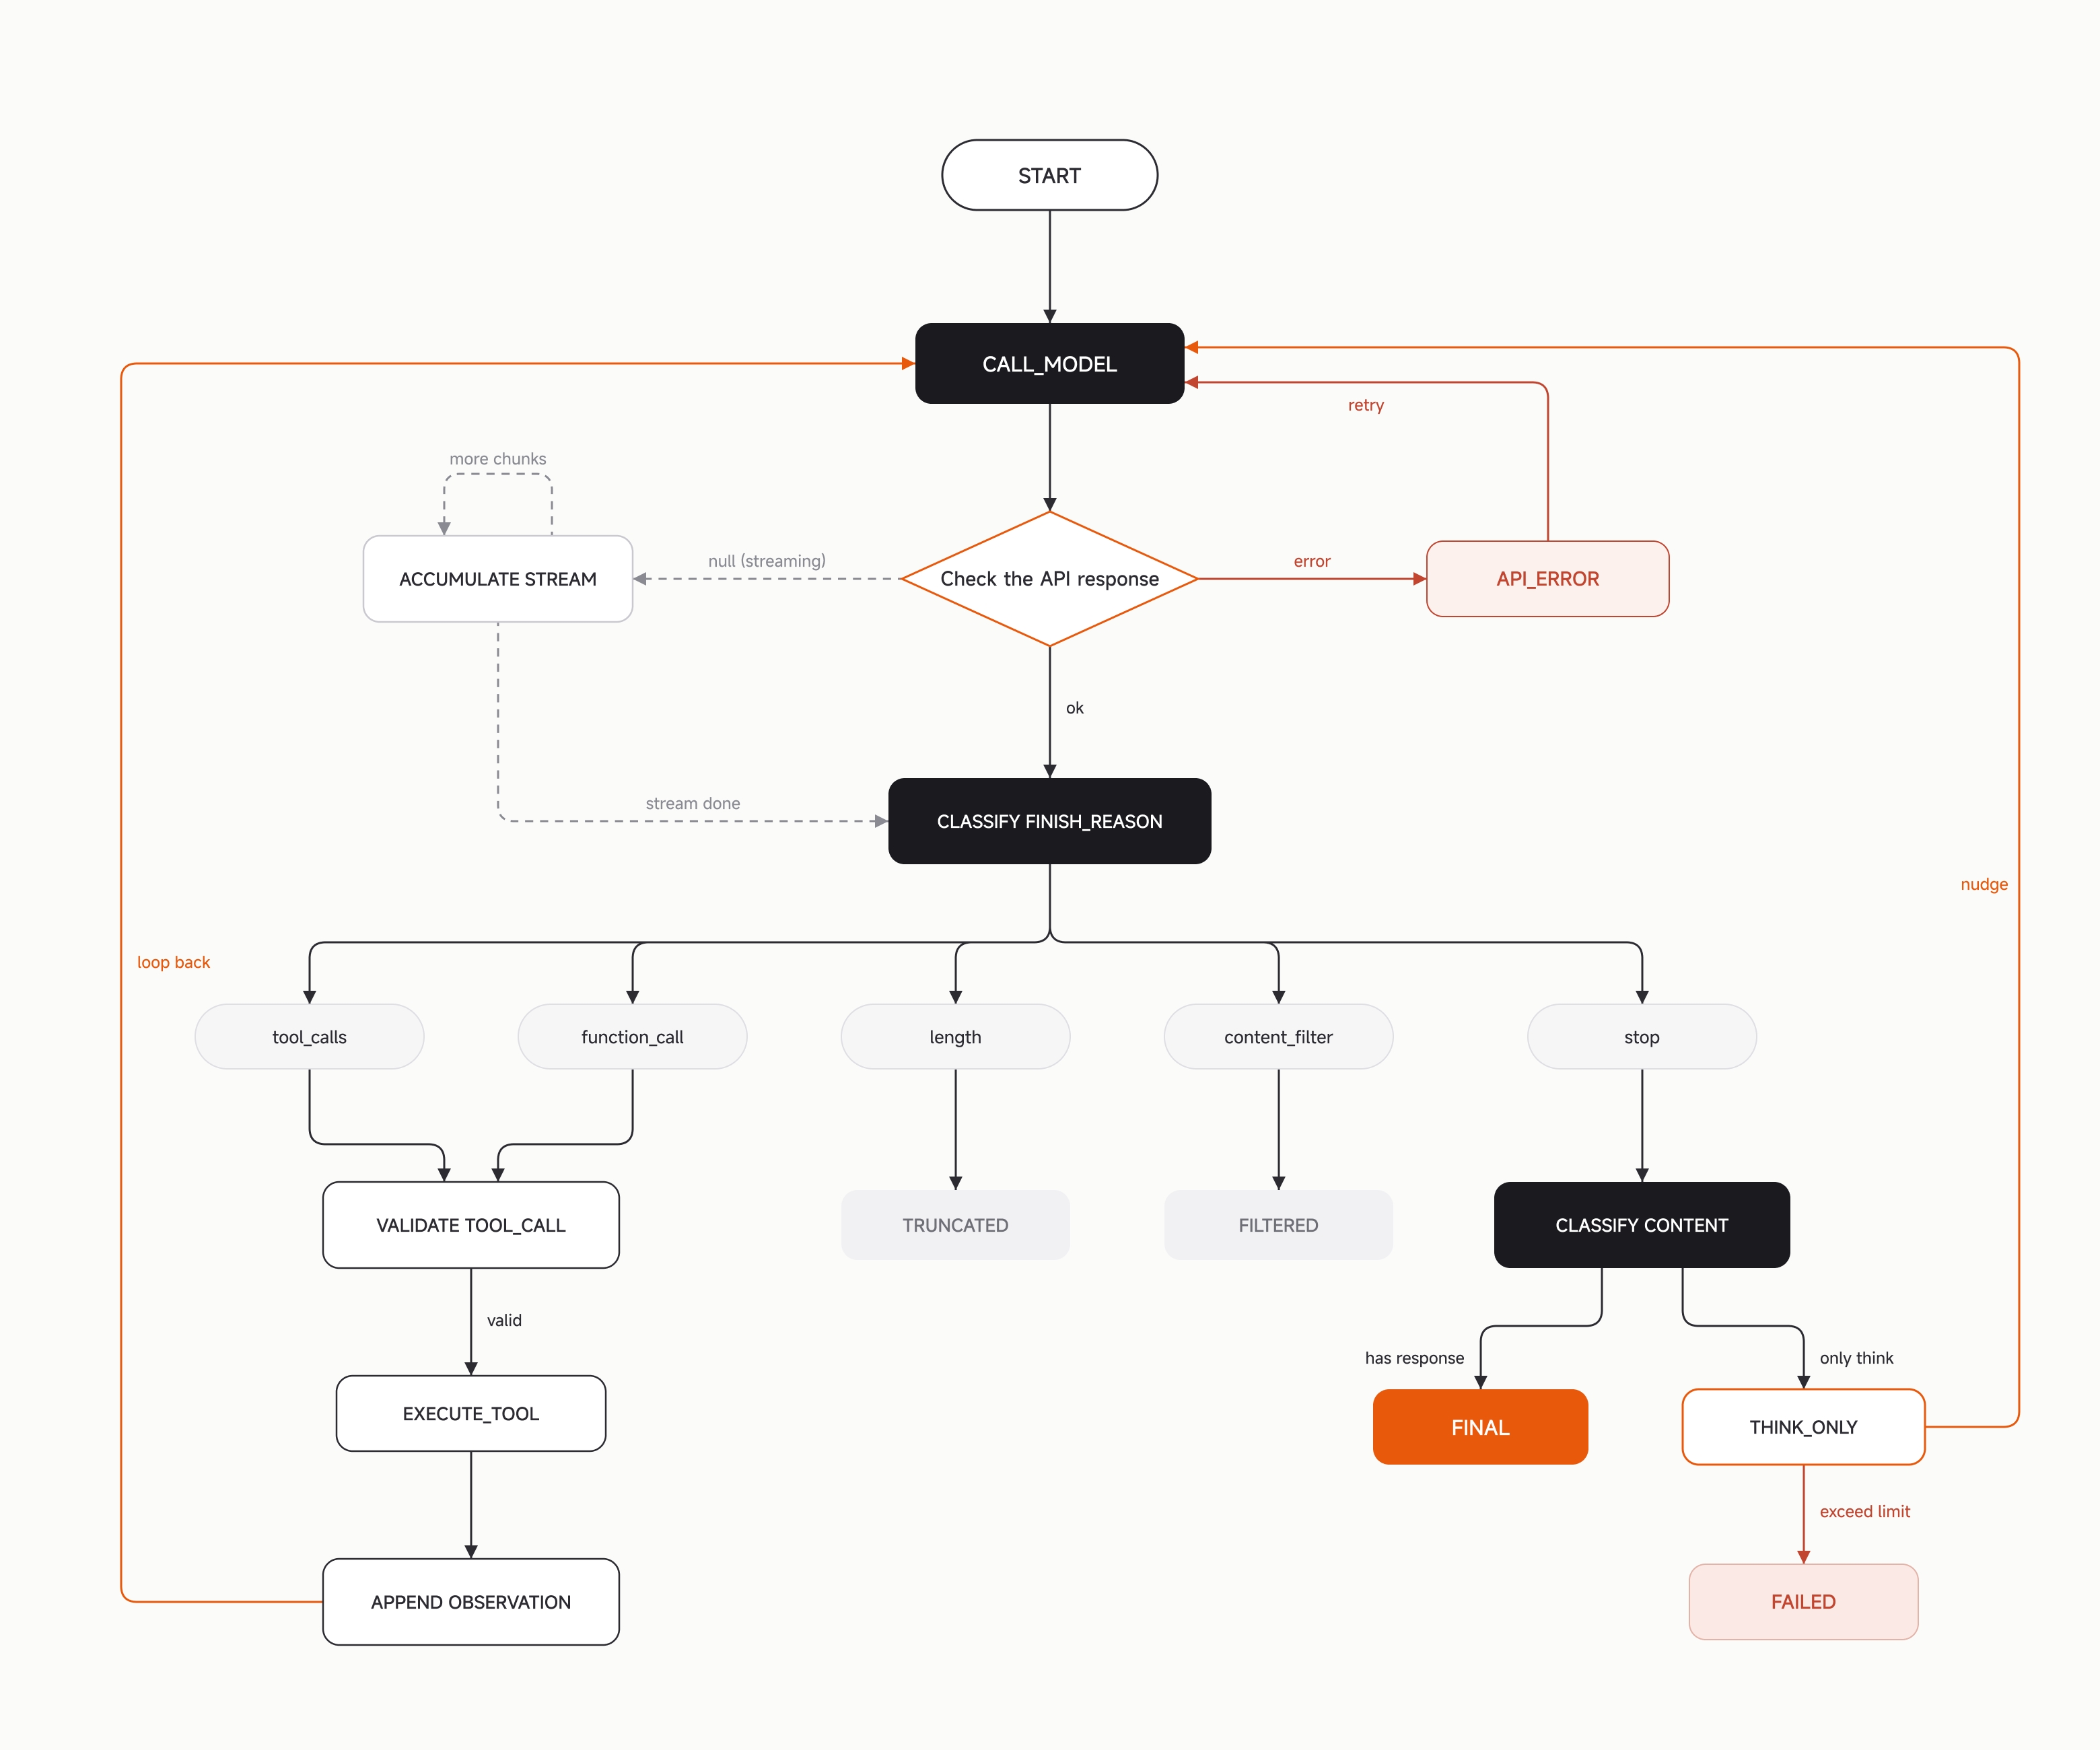 圖一:MiMo Code 主迴圈狀態機(小米官方)
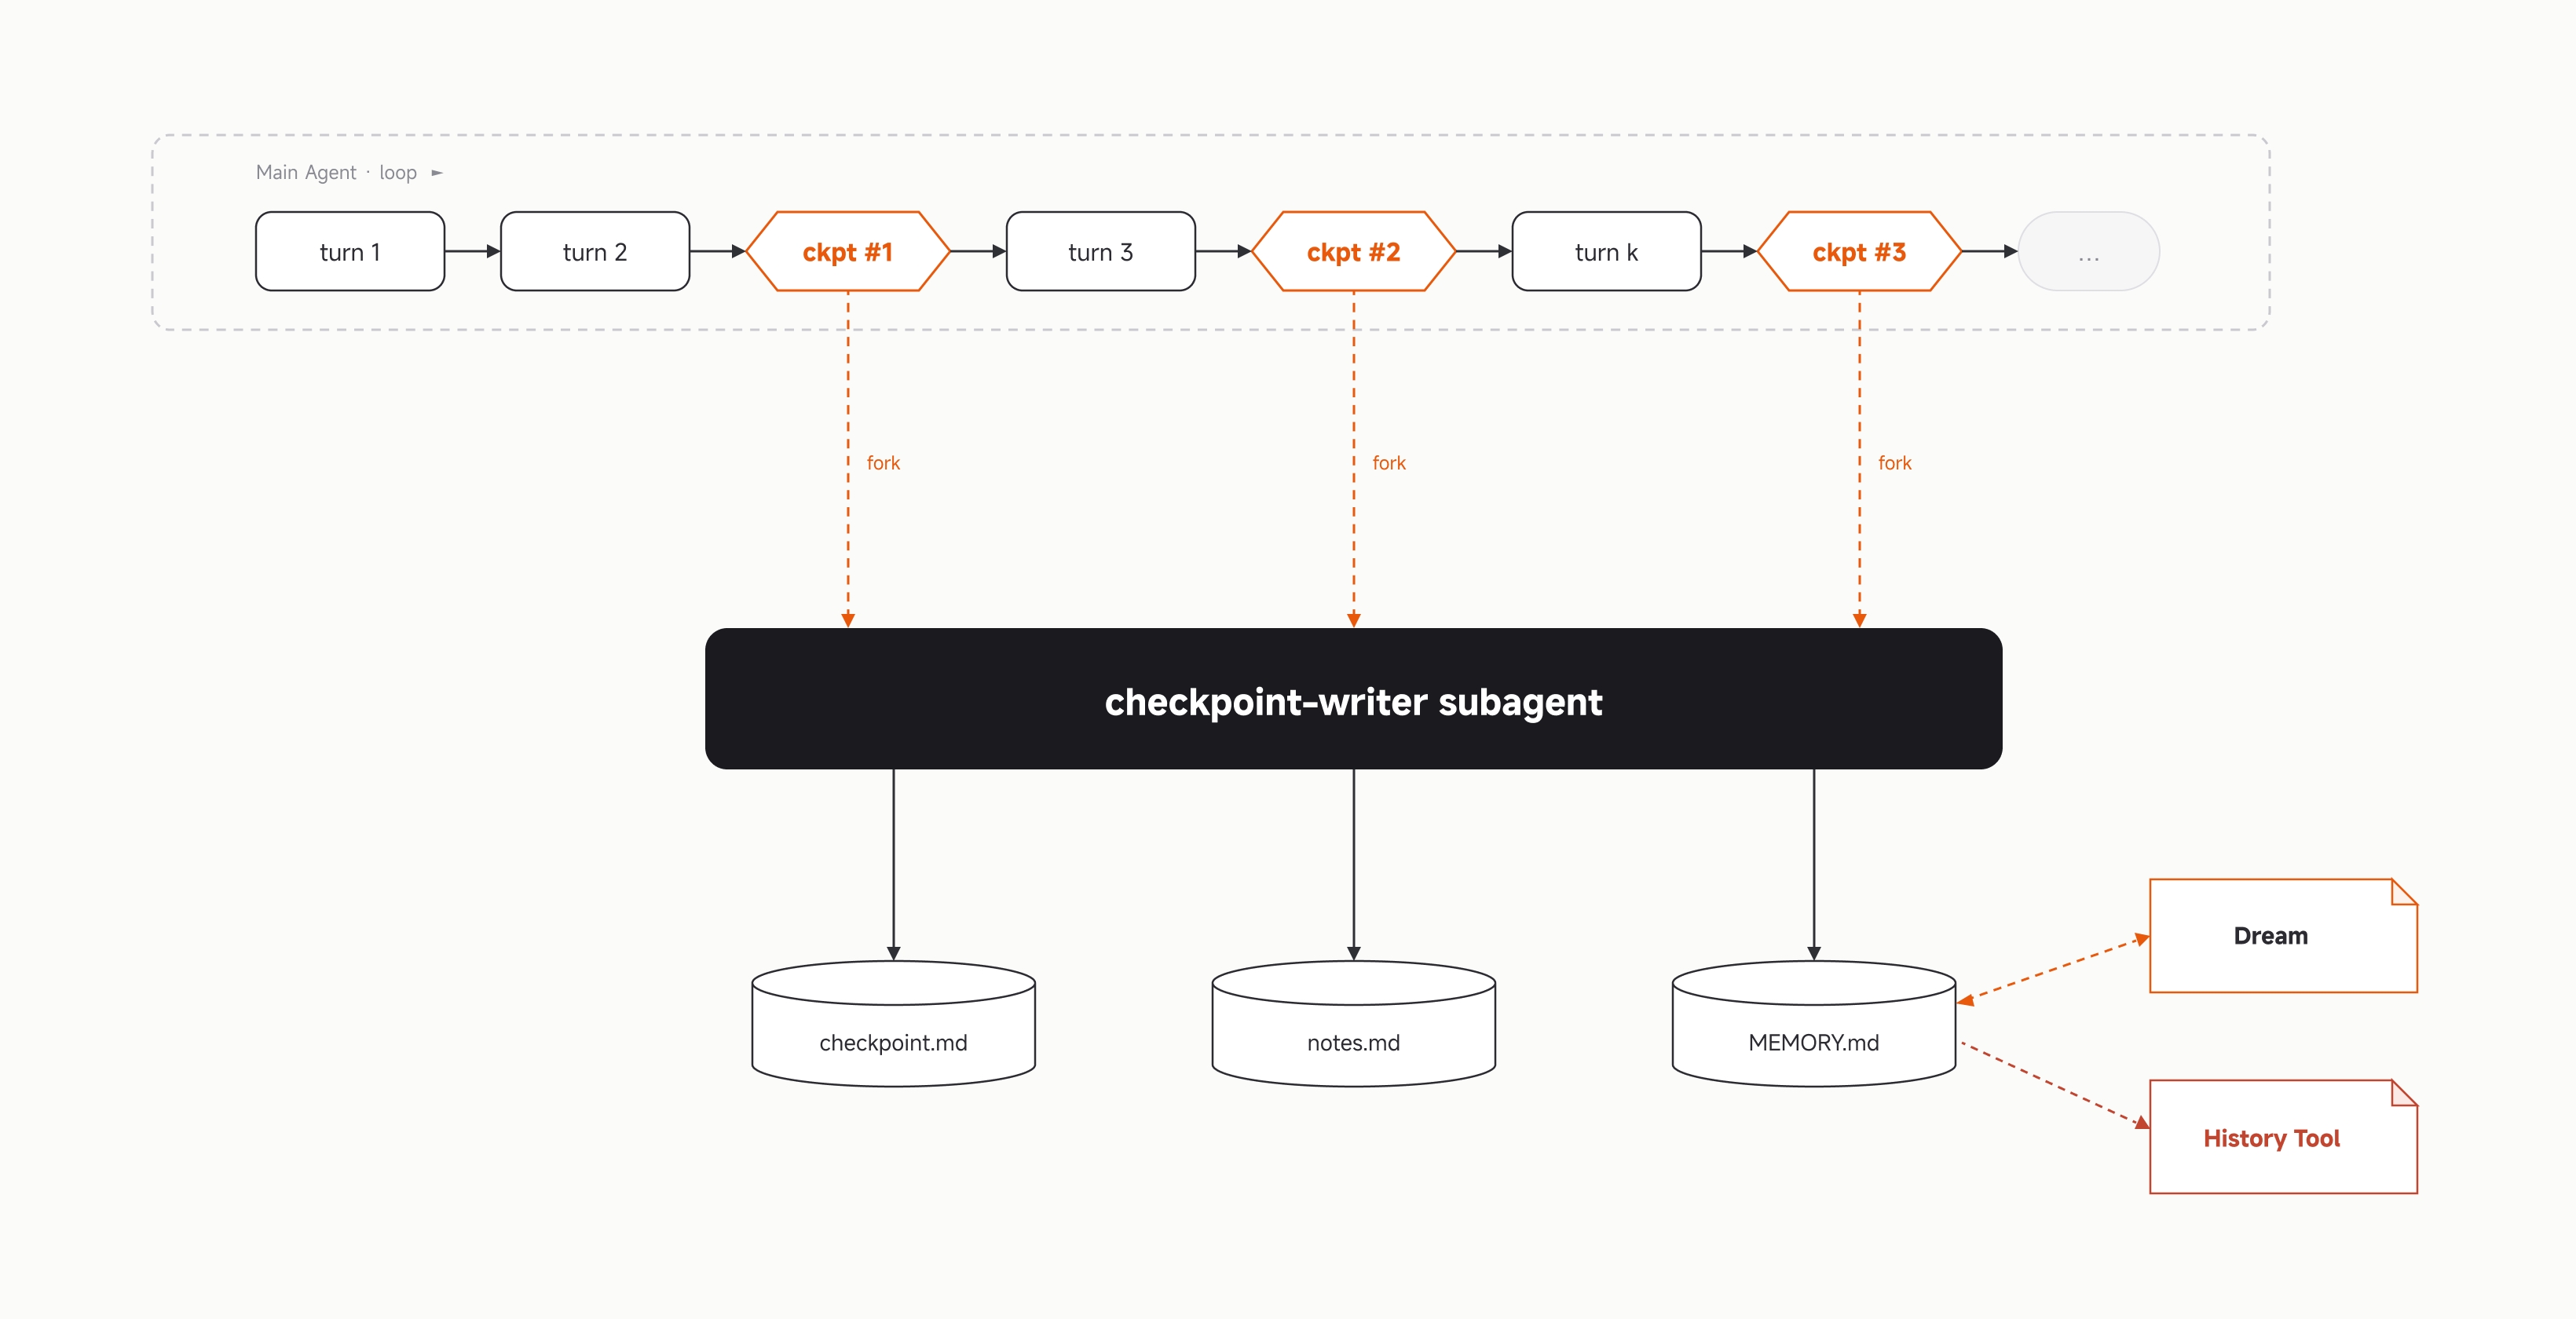 圖二:主代理與 checkpoint-writer 子代理協作機制(小米官方)
 圖三:MiMo Code 與 Claude Code 在三項基準測試的比較(小米官方)
📺 【深度分析】Xiaomi MiMo-Code:會記得你專案的程式設計代理(Prism Labs)
網路回應
- tdesilva(▲187):很好,程式設計代理的執行環境(harness)本來就應該開源,而 LLM 應該被視為大宗商品。降低消費者轉換成本,讓人們了解他們是如何與 context 和 LLM 輸出互動的。產業界一直在朝錯誤的方向走——Claude Code 一直保持閉源(雖然原始碼外洩過好幾次!),而開源的 Gemini CLI 卻被棄用了。
- ComputerGuru(▲142):因為連結是中文的,補充一下:MiMo Code 是小米的 AI 代理式程式設計工具。「MiMoCode 是一個終端原生 AI 程式設計助理,可以讀寫程式碼、執行命令、管理 Git,並透過持久化記憶系統在跨 session 中持續深入理解你的專案,同時不斷自我改進。」GitHub 連結(英文):https://github.com/XiaomiMiMo/MiMo-Code
- adi2907(▲98):小米這些年的轉變真是驚人——他們幾乎做出了 frontier 等級的模型。五年我還在資料科學團隊時,他們根本不在乎 AI 模型,底層都是用百度的 NLP 跟視覺 API。
- GodelNumbering(▲64):MiMoCode 是從 OpenCode fork 出來的。它保留了 OpenCode 所有的核心能力(多 provider、TUI、LSP、MCP、外掛),並加入了持久化記憶、智慧型 context 管理、子代理編排、目標驅動的自主迴圈、compose workflow,以及透過 dream/distill 進行自我改進。
- ricardobeat(▲51):它們自家 API 的授權流程有問題……網頁上的『授權』按鈕會拒絕、但過一會兒又放行,然後你在 App 裡卡在『等待授權』。網頁說『把這段貼到 MiMo Code 裡』,但根本沒地方貼。Token 方案倒是能用。
網友熱門留言 (5)