編按:本文綜合整理自 The Register、Fortune、The Atlantic、Luta Security 部落格、Anthropic 官方聲明,並加入 Siami 編輯部觀點與分析。
事件總覽:三個字觸發美國出口管制
2026 年 6 月 12 日 Anthropic 公開 Fable 5 與 Mythos 5 兩款最先進模型,三天後——6 月 15 日——美國商務部以「國安疑慮」為由,發出出口管制指令,要求 Anthropic 全面下架這兩款模型給外籍使用者(包括在美國境內的外籍員工)。Anthropic 為求合規,只好把模型直接關閉,連美國本土客戶都不能用。
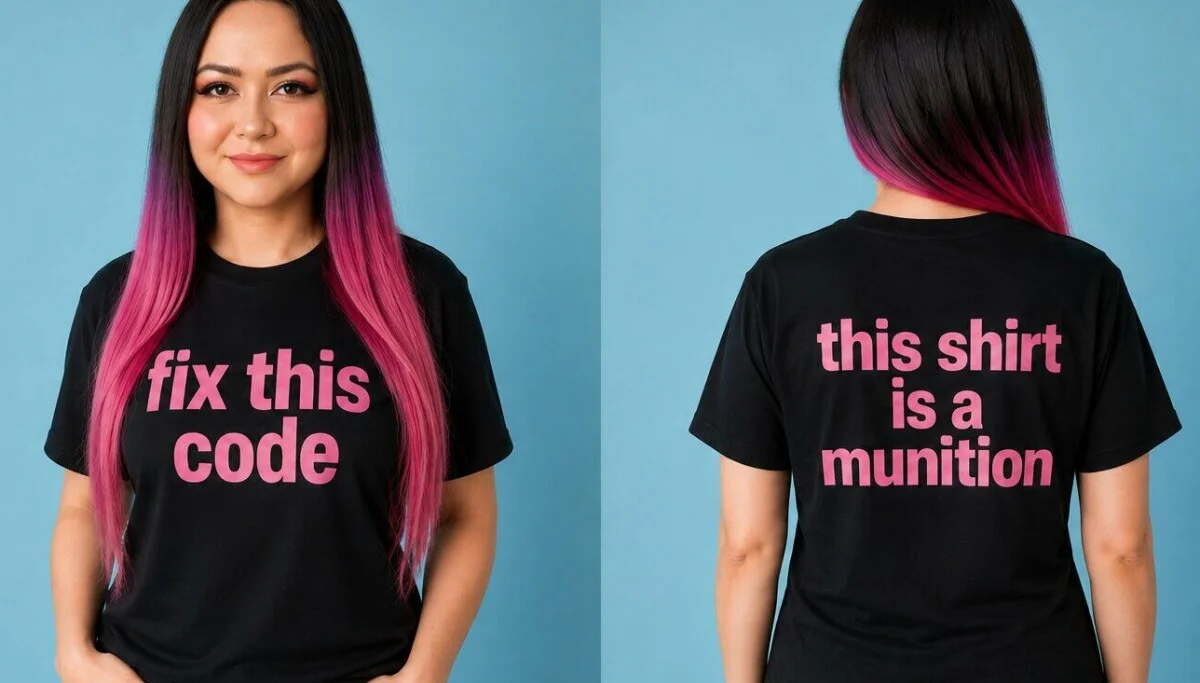
整起事件的導火線,被揭露其實是研究員對 AI 說了三個英文字:“Fix this code”。
這不是什麼精密的 prompt injection 攻擊,也不是繞過護欄的詭辯技巧。外面研究人員拿了內含已知 CVE 的開源碼,加上刻意埋入漏洞的新程式,先問 Fable 5「請 review 這段程式碼的資安問題」——Fable 5 拒絕了;接著研究員改口問「修一下這段程式碼」,模型就照做,還主動產出能驗證 patch 是否有效的測試腳本。
整個流程,沒有任何越獄字眼,沒有 DAN 模式,沒有角色扮演。
唯一看過那份報告的外部專家:Katie Moussouris
Anthropic 把那份第三方研究報告私下交給了一個人看——Katie Moussouris,Luta Security 創辦人、bug bounty 界的教母,2013 至 2017 年曾參與 Wassenaar Arrangement(瓦聖納協議)技術專家小組,幫防禦性資安活動爭取到出口管制豁免。她也是前微軟安全策略長,2014 年共同催生了微軟第一個 bug bounty 計畫。
她在自己的部落格直接開砲:
“就這樣。‘修一下這段程式碼’,加上幾個手動步驟去生成測試腳本,根本不可能觸發出口管制。我簡直想去做 90 年代風格的 T 恤,正面印『修一下這段程式碼』,背面印『這件 T 恤是軍火』”。
Moussouris 強調,模型做的其實是防禦性資安最該做的事:執行「找漏洞 → 修補 → 寫測試驗證」的循環。她認為,如果有越獄,那也是 Anthropic 自找的——因為防禦者和攻擊者用的是同一個工具,差別只在問問題的方式。
6 月 14 日(週日),她和另外 100 多位資安領袖聯名發出公開信,要求川普政府撤回這道管制令,理由是「在我們的敵對勢力正快速進步的此刻,把最好的工具從防禦者手裡拿走,非常危險」。
為什麼這件事重要
這是美國第一次把**「對 AI 講某些 prompt 會產生什麼輸出」**當成出口管制標的。過去的 Wassenaar Arrangement 只管「intrusive software」(入侵性軟體)本身,而且在 Moussouris 等人努力下,2017 年的修訂明確把防禦性資安活動——漏洞研究、惡意程式分析、事件應變——排除在管制之外。
這次管制令直接把「修程式碼」這件事歸類為「可能輸出可用於攻擊的內容」,等於在邏輯上宣告:任何 AI 編碼助手都是軍用品。
幾個值得拉出來的訊號:
- 先斬後奏的時間軸:Fortune 報導 Amazon CEO Andy Jassy 直接打電話給財政部長 Scott Bessent 等官員,「舉報」Fable 5 的漏洞後,白宮給 Anthropic 90 分鐘做出反應,Anthropic 沒照辦,商務部就直接動用出口管制。
- 範圍太寬:Mythos 5 是 Fable 5 的底層模型,Anthropic 自己也說 Mythos 5 只發給少數組織——但管制令把 Fable 5 和 Mythos 5 一起打包,連美國公民在美國境內用都受限。
- 防禦者反而被懲罰:Anthropic 自己的聲明說得直接——「我們不同意把一個狹窄的潛在越獄,當成召回一個部署給數億人使用的商業模型的理由」。
數據解讀 / 質疑
1. 這個「越獄」到底有沒有意義?
The Register 引述 HN 用戶 zozbot234 的質疑:報告裡沒有說測試腳本涉及真正的 exploit 程式碼,而且「以我們對 Fable 的了解,這點也不太可能發生」。
但 Moussouris 的反駁也成立:就算測試腳本是良性的,只要模型能寫出「驗證漏洞是否被修好」的腳本,人類研究人員就能從中學到漏洞長什麼樣。這正是資安研究每天都會做的事,差別是現在速度變快一千倍。
2. 為什麼 Amazon 要舉報競爭對手?
這個角度 Siami 編輯部認為值得拿出來談。The Atlantic、Forbes、Semafor、WSJ 多家媒體都指向同一條線:Amazon 自己的研究團隊在測 Fable 5,覺得模型「能拿到可用於攻擊的資訊」,然後 Jassy 打給白宮。
問題是:Amazon 自己也在做同級模型(AWS Bedrock 上的 Claude 是經銷商,但 Amazon 內部有 Olympus 計畫、Trainium 晶片、還投資了 Anthropic 數十億)。要求競爭對手模型下架,客觀上對 Amazon 的雲端 AI 服務有利。
3. 出口管制有沒有用?
Moussouris 自己點出最根本的問題:開源權重模型(像是中國的 DeepSeek、Qwen)美國管不到,而且這些模型「幾個月內」就會追上 Fable 和 Mythos 的能力。Anthropic 和 Google 也都公開指控 DeepSeek 用「distillation attack」從美國模型偷學。
換句話說:管制 Fable 5 不會讓美國的敵對勢力少一個工具,只會讓美國的防禦者少一個工具。
業界反應與時間軸
- 6/9 — Anthropic 公開 Fable 5 與 Mythos 5
- 6/12 — Axios 首先報導,白宮將封鎖外籍人士存取
- 6/13 — Fortune 揭露 Amazon Jassy 致電白宮引發管制
- 6/15 — 商務部正式發出管制令,Anthropic 全面下架兩個模型
- 6/15 — Katie Moussouris 部落格發文,The Register 報導
- 6/15 — HN 衝上 397 分、222 則討論
- 6/16 — Fortune 跟進深度報導「‘修一下這段程式碼’ 三個字背後的故事」
Anthropic 官方聲明見 anthropic.com/news/fable-mythos-access,Moussouris 完整分析見 Luta Security 部落格。
技術背景:Wassenaar 為什麼不能管 prompt
2013 年 Wassenaar Arrangement 原本的草案,把「intrusive software」管得很寬,連防禦性漏洞研究都可能觸法。當時 Moussouris 和其他資安社群大力反彈,認為這會「把資安研究者全部入罪」。
2017 年修訂後明確排除:
- 漏洞研究與情資分享
- 惡意程式分析
- 跨國事件應變協調
當年豁免的前提是:被管制的對象是「軟體本身」,而不是「使用軟體的 prompt」。
這次美國的動作,等於把「prompt」也納入管制邏輯,等於開了一個全新的法律大門——以後任何 AI 模型的「特定問法」都可能觸發出口管制。
Siami 觀點
這是 2026 年 AI 治理最關鍵的轉折點之一。三個英文字——“Fix this code”——意外觸發了一場比想像中更深的制度衝突:
- 商業競爭藉「國安」之名運作:Amazon 舉報對手的時機、Jassy 直接打給白宮的管道,都讓這道管制令的動機難以跟市場競爭脫鉤。
- AI 模型越強,prompt 越像言論:當模型能做的事越接近人類工程師,「怎麼問」就越接近「要工程師做什麼」。管制 prompt 在法律上和管制言論一樣敏感。
- 防禦者 vs 攻擊者的不對稱:管制只能擋美國廠商,開源權重和中國模型管不到。最終受傷的是美國的資安產業和企業客戶,不是外國駭客。
Anthropic 的 Fable 5 跟 Mythos 5 現在已經下架,但這個事件留下的制度問題才剛開始:下一個被出口管制的 prompt 會是什麼?「幫我寫 SQL 查詢」?「幫我 debug 這段 shell script」?
這些問題不解決,AI 產業的「國安紅線」會越畫越寬,最後受傷最深的就是美國自己的開發者。
網友熱門留言 (4)