編按:本文綜合整理自 Vicki Boykis 部落格原文、Hacker News 討論串(1481 分、555 則留言)、Google Gemma 官方公告,並加入 Siami 編輯部觀點與分析。
資深機器學習工程師 Vicki Boykis 上週在個人部落格發了一篇震撼文:「Running local models is good now」。她用 2022 年買的 M2 Mac(64GB RAM、1TB 儲存),搭配 Google Gemma 4 + LM Studio + Pi agent harness 的本地端組合,跑出 「接近雲端前沿模型 75% 表現」 的可程式化 agentic coding 迴圈。這篇文在 Hacker News 拿下 1481 分、555 則留言,是近期本地 LLM 議題最熱門的討論之一。
為什麼這件事重要
這篇看似只是工程師個人實測的部落格文,實際上是 「本地端 LLM 成熟度」 這個長期議題的重要分水嶺。Siami 編輯部認為有三個層面值得放大來看:
第一,這是「個人 vibe metric」第一次系統化地打敗「論文 benchmark」。Vicki 不是用 MMLU 或 SWE-Bench 評分說服你,而是用「我是不是還要 double-check 雲端 API 模型」這個日常判斷當作指標。她說 GPT-OSS 是第一個讓她「不用一直比對雲端」的本地模型,Gemma 4 更是第一個能跑 agentic loop 的。這個轉變的訊號是:本地 LLM 已經從「學術展品」變成「生產力工具」。
第二,硬體門檻被壓到「中高階消費級」可達的範圍。Vicki 用的是 2022 年的 M2 Mac、64GB RAM——這台機器當年售價約 4,500 美元,現在二手市場大概 2,000 美元上下。不是「人人買得起」,但已經是「獨立開發者、研究員、小公司工程師」可以負擔的範圍。配合量化技術(Q4_K_XL、QAT)後,27B 等級的模型已經能跑進 64GB RAM 內。
第三,「agentic loop」這件事過去是雲端模型的專利。能在本地端跑 agentic coding(讀檔、編輯、執行、修正、重複),代表你不再需要把程式碼、商業邏輯、客戶資料送到 Anthropic 或 OpenAI 的 server。這對 金融、醫療、法律、國防 這些高度監管產業的 AI 落地,是個結構性突破。
Vicki 的本地端設定
她公開的 stack 非常具體,工程師可以直接照抄:
- 硬體:2022 M2 Mac,64GB RAM、1TB 儲存
- 模型:
google/gemma-4-26b-a4b(LM Studio 量化版本)為主,gemma-4-12b-qat 為輔 - 推論引擎:LM Studio(GUI 介面,底層是 llama.cpp)
- Agent harness:Pi(GitHub:
earendil-works/pi) - 沙盒:Docker container(限制 Pi 對實體硬碟的存取)
整個設定用 Docker Compose 起一個 Pi 容器,把 LM Studio 的 OpenAI-compatible endpoint(http://host.docker.internal:1234/v1)注入到容器內。OPENAI_API_BASE 環境變數把 Pi 的所有 LLM call 導到本地端,真正的 OpenAI / Anthropic / Gemini key 留空也沒關係。
她實際做了哪些事
Vicki 在文中列了一串她用這個本地設定完成的「personal Google 級」任務:
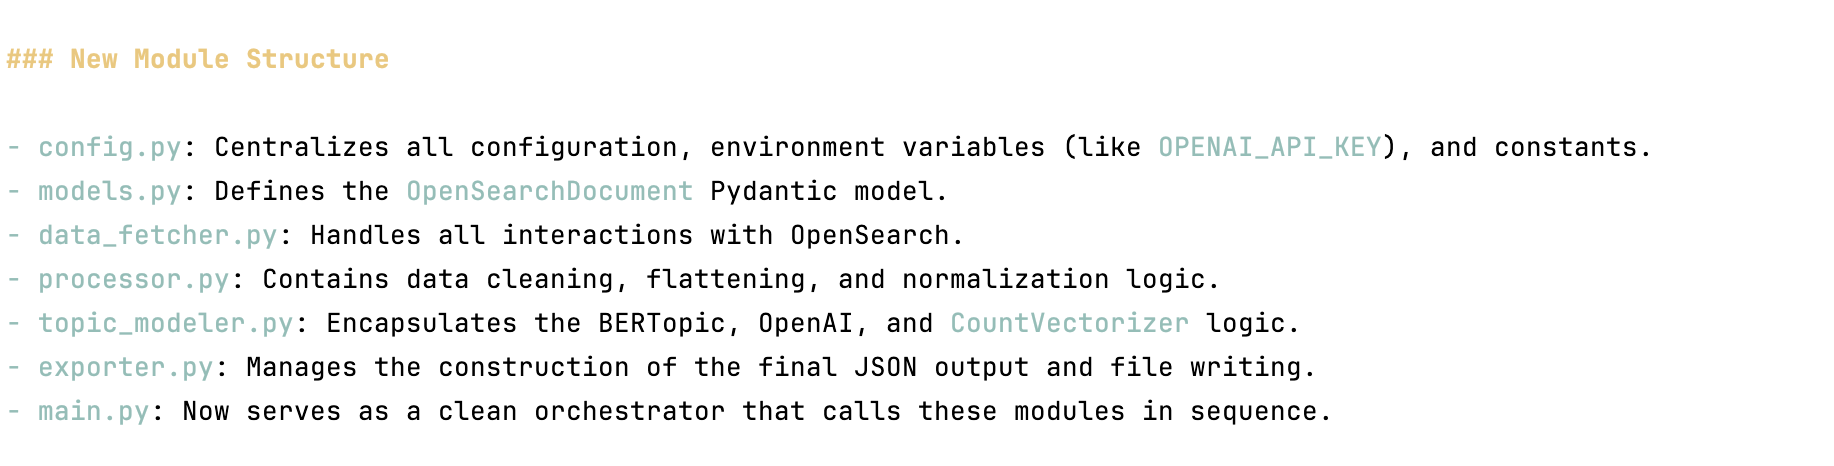
- 把一個 Python notebook 重構成 5-6 個 modules 的 repo
- 幫 module 加上正確的泛型 type hints(她說「大部分前沿模型現在會自動做這件事,但不是每次都會」)
- 校稿部落格文章
- 寫 unit tests
- 從零生成一個 two-tower 推薦模型的 repo 雛形(她說「基本但去年我還會覺得不可能」)
她還做了一個有趣的 side experiment:叫 Pi 爬她過去的 LM Studio session log,自動分析她都用本地模型做了什麼——結論大部分是「查文件、查錯誤訊息、查 API 用法」這些「個人化 Google」等級的工作。
數據解讀
這篇文的訊號意義遠大於 Vicki 本人的「個人觀察」。我們從 Siami 編輯部角度拆三個量化指標:
- HN 1481 分、555 則留言 —— 這個分數在 2026 年 Hacker News 是 top 5% 等級,留言熱度比 SpaceX-Cursor 600 億美元併購案還高。通常意味著「開發者社群真的在乎這件事」而不是「新聞本身很聳動」。
- 「本地模型可用度」社群共識分水嶺 —— 留言區普遍認為 GPT-OSS(2025 年 5 月)跟 Gemma 4(2026 年 5 月)是兩個關鍵節點。6 個月前本地 agentic coding 還是不可能任務,這是非常具體的技術進展。
- 「工具鏈完整度」實戰驗證 —— 從 LM Studio(GUI 推論)→ Pi(agent 框架)→ Docker(沙盒)→ llama.cpp(底層 C++)四層工具鏈,每一層都有官方文件、Discord / GitHub Issues 社群支援,這是 2024 年本地 LLM 完全沒有的生態系。
質疑
Vicki 的結論樂觀,但留言區的工程師提出了至少三個 真正的反方論點,值得一起看:
第一,「75% 雲端表現」這個說法太軟。留言區 @c0rruptbytes 直接開嗆:「dense 模型(Qwen 27B、Gemma 31B)聰明但慢到爆,MoE 模型(Gemma 26B、Qwen 35B)快但常常出包」——也就是說 Vicki 選的 Gemma 4-26B 剛好是個甜蜜點,但這不代表所有本地模型都「能用了」。MoE 模型在 production 的失敗率是個沒人公開討論的黑盒子。
第二,硬體門檻對「全球 50% 開發者」依然過高。留言區 @psychoslave 做了「全球可負擔性估算」:全球前 10% 收入者(約 8 億人)能「無痛」負擔 2,000 美元設備;前 25%(約 20 億人)需要調整預算;後 50%(約 40 億人)根本買不起。也就是說,本地 LLM 的「民主化」目前只到「已開發國家中高階開發者」這個層級。
第三,「離線」不代表「私密」。Vicki 用的是 LM Studio + 本地端推論沒錯,但如果 Pi 容器本身有任何對外 API 呼叫(更新檢查、模型下載、遙測),資料還是會出去。「真的完全離線」需要 air-gapped 環境、定期 model 離線 mirror、HTTPS 出口全封——這些都不是 Vicki 提的預設設定。
給開發者的實戰建議
如果看完這篇想自己試,Siami 編輯部整理一份 checklist:
- 硬體最低門檻:Apple Silicon Mac(M1 以上)64GB RAM、或者 NVIDIA RTX 4090(24GB VRAM)+ 至少 64GB system RAM
- 模型起點:
google/gemma-4-12b-qat(小、快、夠用)、gemma-4-26b-a4b(甜點)、Qwen3.6-27B-UD-Q4_K_XL-MTP(極快但 prompt template 容易踩雷) - 推論引擎:LM Studio(GUI 友善)、Ollama(CLI 友善)、llama.cpp(最快但要自己編)
- Agent 框架:Pi(Vicki 推薦)、Aider、Continue、Cursor(雖然 Cursor 是 SaaS 但能切到本地 backend)
- 第一步建議:先在 Docker container 裡跑
gemma-4-12b-qat,寫個 50 行的 Python 改寫任務,親自體驗「不用 double-check 雲端」的瞬間
後續觀察清單
- Google 是否會在 I/O 2026 後釋出 Gemma 4 70B+ 等級(直接挑戰 Llama 4 Behemoth)
- Apple M4 / M5 系列 unified memory 是否能把 128GB 推成 MacBook Pro 標配(NVIDIA DGX Spark 已經 128GB 起跳)
- DeepSeek V4、Qwen 3.7、GLM-5.2 這些開源巨頭的下一代能不能在 27B 級距跑出「95% 雲端表現」
- 企業級本地 LLM 託管服務(Hetzner、OVH、RunPod 這類)會不會把 unit economics 壓到「比 Claude 訂閱便宜 10 倍」
延伸閱讀:
網友熱門留言 (5)