編按:本文綜合整理自 TechCrunch、Reuters、OpenAI 官方公告、Bloomberg、Constellation Research,並加入 Siami 編輯部觀點與分析。
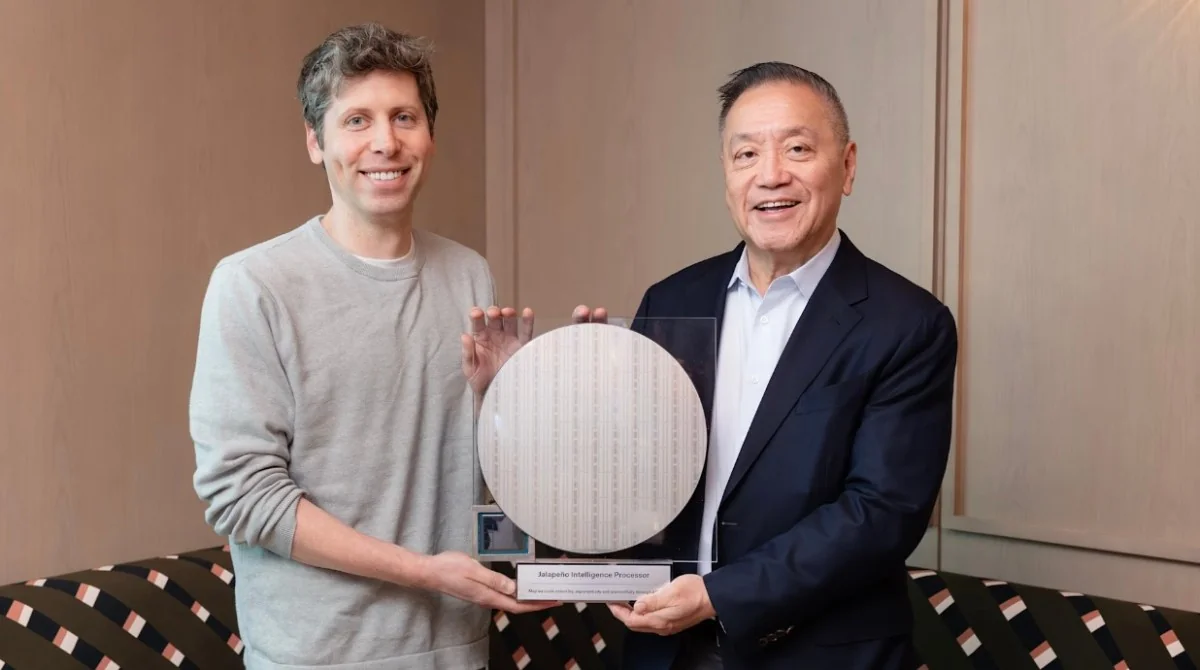
OpenAI 揭曉 Jalapeño:九個月從設計到量產的推論專用加速器
週三,OpenAI 正式公開旗下首款自研推論處理器(inference processor),由該公司與 Broadcom 共同設計與製造。這顆命名為「Jalapeño」(墨西哥辣椒)的新處理器,是專為 OpenAI 推論系統的特殊需求量身打造。OpenAI 表示,自家研發的 AI 模型也實際參與了這顆晶片的設計與優化流程。
雖然目前仍在測試階段,但 OpenAI 指出早期實測結果顯示,Jalapeño 在「每瓦效能」(performance-per-watt)上,明顯優於市面上現有的最先進方案。根據 Bloomberg 報導,該晶片可將成本削減約 50%;OpenAI、Broadcom 與 Celestica 三方合作,從設計到 tape-out 只花了 9 個月,在高效能 ASIC 領域被視為破紀錄的速度。
這樁合作案早在去年十月便已正式公開,但 OpenAI 的自研晶片計畫長期以來一直被視為該公司「降低對 Nvidia GPU 依賴」的重要戰略之一。事實上,Google(TPU)與 Amazon(Trainium / Inferentia)早已為了類似目的打造自家客製晶片,這類專門加速機器學習工作負載的處理器,一般被稱為「AI 加速器」(AI accelerators)。
為什麼這件事重要:垂直整合已是 AI 大廠的標配
OpenAI 總裁 Greg Brockman 在官方聲明中直言:「Jalapeño 是我們長期全端基礎設施策略的一環,目的是讓算力變得更充裕,進而讓 AI 變得更快、更可靠、更便宜,並能用來解決更重要的問題。」
這段話點出了 AI 產業正在發生的結構性轉變:當模型本身逐漸商品化,真正的護城河已經從「誰的模型最聰明」轉移到「誰能用最低成本運行這些模型」。OpenAI、Broadcom、Celestica 三方的合作模式(OpenAI 出工作負載洞察、Broadcom 出 Tomahawk 網路晶片與矽智財、Celestica 出機板與系統整合),幾乎複製了 Google 過去十年用 Broadcom 打造 TPU 的成功方程式。
值得關注的是,Jalapeño 內建 Broadcom Tomahawk 網路矽,這意味著 OpenAI 不只在做「單顆加速器」,而是直接打造可用於 gigawatt 等級資料中心 的多代運算平台。Broadcom 執行長 Hock Tan 形容這是「為未來十年的 AI 擴展實體基礎設施的根本承諾」,並預計 2026 年底前在 Microsoft 與其他夥伴的資料中心展開部署。
數據解讀與質疑:50% 成本下降是真的嗎?
OpenAI 與 Broadcom 對外釋出的關鍵數字有三個:
- 每瓦效能「substantially better than current state-of-the-art」(官方用語,未提供具體倍數)
- 推論成本可降約 50%(Bloomberg 引述)
- 設計到 tape-out 只花 9 個月(業界紀錄)
讀者需要保留三個合理的質疑空間:
- 「substantially better」目前沒有對標基準。相較於 Nvidia 哪一代 GPU?是 H100、H200、還是 Blackwell B200?這直接決定了「突破程度」的真實分量。
- 50% 成本下降的口徑未明。這 50% 是只算電費、還是涵蓋整體 TCO(伺服器機板、網路交換器、散熱、機房空間)?在 ASIC 領域,TCO 才是真正的比較基準。
- 前訓練任務仍依賴 Nvidia。OpenAI 自己坦承,更吃效能的前訓練階段還是會用 Nvidia 硬體,這代表 Jalapeño 是「補位推論」而非「取代 GPU」。要說「OpenAI 拋棄 Nvidia」是過度延伸的解讀。
不過從戰略面來看,即使 Jalapeño 只接手推論這一段,由於推論在 OpenAI 整體算力支出中佔比越來越高(Codex、即時對話、API 流量全數都屬於推論),光是把推論單位成本壓到一半,對 OpenAI 的損益表就會產生實質級的影響。
業界反應:Bloomberg、Constellation Research、Yahoo Finance 同聲指出 Nvidia 壓力
外媒與分析師的反應高度一致,把這顆晶片定位為「對 Nvidia 的明確一擊」:
- Bloomberg 與 Yahoo Finance 同時強調:雖然 OpenAI 仍是 Nvidia 最大客戶之一,但當所有 AI 巨頭(Google、Meta、Amazon、微軟、OpenAI)都在開發自家加速器,「高效能 GPU = 唯一解」的時代正在快速結束。
- Constellation Research 分析師指出:「LLM 業者必須壓低 AI 成本,而最佳的合作對象就是協助 Google(AI 成本領導者)的 Broadcom」——這個說法點出了 Broadcom 真正可怕之處:它不是單純的代工,而是已經把所有想要「自研加速器」的 AI 客戶都綁進自己的 Tomahawk 網路生態系。
- Investing.com 引述數據指出 Broadcom 當前市值已達 1.81 兆美元,過去 12 個月營收成長 32%,AI 相關營收正朝向 2027 年 300 億美元、年複合成長率逼近 70% 的方向移動。
X 平台上,@TheRundownAI 把這顆晶片的意義濃縮為一句話:「Jalapeño 是 OpenAI 第一代從零打造的 LLM 加速器,宣稱每瓦效能大幅超越現有最先進方案;只花 9 個月就做出來,並且是 AI 用 AI 做硬體設計的里程碑案例。」
接下來值得追蹤的三件事
對長期關注 AI 產業的讀者,這顆晶片接下來有三個觀察重點:
- 部署時程:OpenAI 與 Broadcom 都說 2026 年底前首批 Jalapeño 將在 Microsoft 與其他夥伴的資料中心上線。第一批實際效能數字(與 Nvidia 對標)將決定市場重新評價 OpenAI 估值的天花板。
- 第二代晶片:OpenAI 已明示這是「多代平台」的第一顆,第二代是否有機會涵蓋前訓練?如果成真,Nvidia 在 OpenAI 的份額才會真正面臨結構性壓力。
- 對 Nvidia 股價的傳導:當年 Google 開始大量使用自家 TPU 時,市場並未立即反應;現在 OpenAI 進入相同的「自研晶片」軌道,Nvidia 的本益比壓力是否會在 Jalapeño 量產時同步顯現,將是接下來半年最值得追蹤的金融訊號。
主題標籤:AI、Broadcom、OpenAI、半導體、自研晶片、推論加速器、Nvidia 替代方案
網友熱門留言 (5)