編按:本文綜合整理自 Aditya Patadia 原文、HN 討論串、GpuNex 推論經濟分析、Spheron Cerebras vs H100 基準、OpenRouter GLM-5.2 頁面,並加入 Siami 編輯部觀點與分析。
事件:Patadia 的「AI 成本撐不住」論點,五大力量同時夾擊
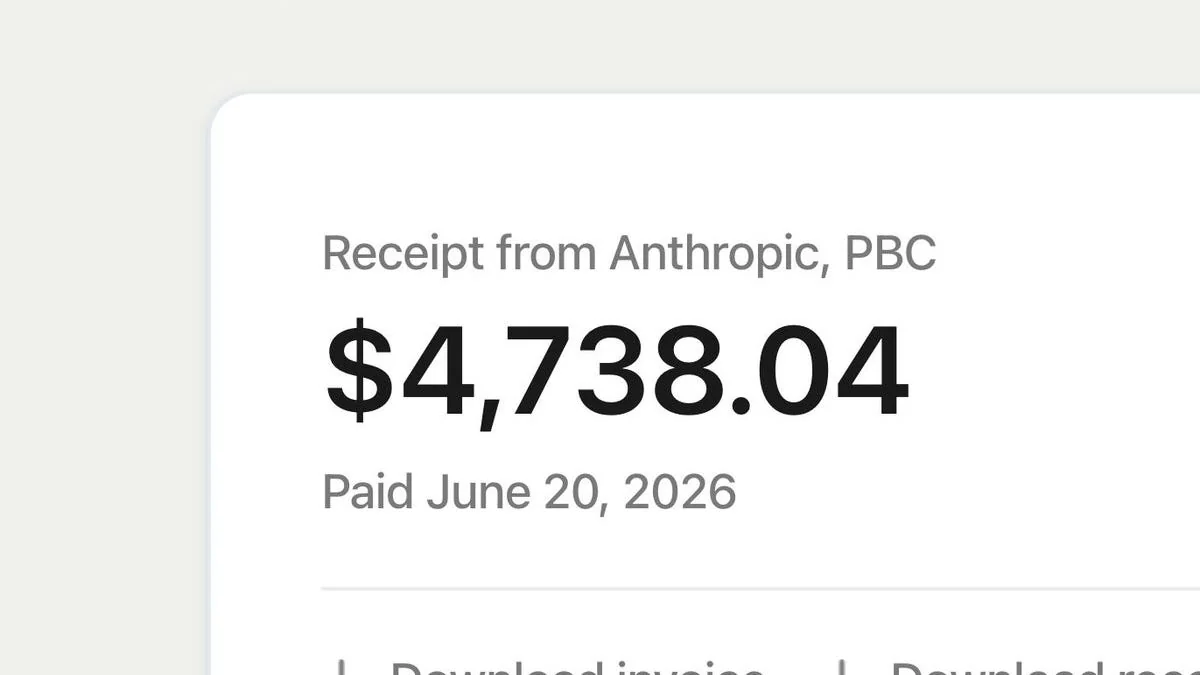
產品設計師 Aditya Patadia 6 月 25 日在個人部落格發表〈AI and Cloud Costs〉,直接點出他用 GPT-5.5 修 50 個 TypeScript 檔案型別,一個下午就燒掉 54 美元的事實,並整理出五股正在把 LLM 高價打下來的力量。文章在 Hacker News 短時間內衝上前頁,HN 原文標題為〈Why current LLM costs are not sustainable〉。
Patadia 列出的五大力量分別是:
- 模型表現高原期(model performance plateau)
- 開源權重模型追上來(open weight model releases)
- 晶片與模型架構持續改進
- 零切換成本(zero switching costs)
- 本地模型即將成熟
這五股力量同時發生的結果是:frontier AI 實驗室(OpenAI、Anthropic、Google、xAI)目前敢喊的單價,在 12-24 個月內都會被壓到接近邊際成本。唯一不確定的,是這個過程會有多快完成。
第一股力量:模型進步幅度正在縮水
Patadia 第一個論點是「模型改進幅度遞減」。他的具體觀察是:除非出現全新架構突破,單純靠 scaling law 與訓練資料擴充的紅利已經到頂。絕大多數數位與印刷資料都已被各家 AI 實驗室抓取殆盡,再要擴大訓練集的成本越來越高、效果越來越有限。
這個觀察有實證:Claude Opus 4.8 的 API 訂價幾乎與上一代 Opus 4.7 相同,這在過去兩年是很罕見的——frontier 模型通常會用「更強 = 更貴」來區隔產品線。當旗艦級模型不再能理所當然地漲價,代表定價已經碰到市場天花板。
對 Siami 讀者的意義:未來 1-2 年內,「買最貴的模型 = 拿到最好的品質」的線性關係會越來越弱。你買 GPT-5.5 跟買 GPT-5.3,可能體感差距小到不值得那個價差。
第二股力量:開源權重把 frontier 定價打成 1/10
Patadia 第二個論點最關鍵:開源權重模型已經追上 frontier 表現,但成本只有 1/10。
最具代表性的案例是 GLM-5.2(智譜 AI):
- 定價:每百萬 input tokens 1.20 美元、output 4.40 美元
- 表現:在 SWE-bench 編碼基準上擊敗 GPT 與 Claude Opus
- 權重:完全開源,任何雲端或本地都能跑
- 成本差:作者原文舉例,做同樣的 TypeScript 型別修正任務,GPT-5.5 燒 54 美元,GLM-5.2 只需 5 美元上下
OpenAI 與 Anthropic 的 frontier 模型要支付的不只是推論電費,還要涵蓋:
- 模型架構研發
- 訓練資料蒐集與清理
- 動輒上億美元的模型訓練成本
- 員工薪資與行銷費用
開源權重一旦釋出,推論商(如 OpenRouter、Fireworks、Together AI)只要加一點 margin 就能賣給終端客戶,整個成本曲線被徹底打平。這就是 Patadia 說的「定價撐不住」的核心結構性原因。
第三股力量:AI 專用晶片正在把 GPU 擠出定價模型
Patadia 提到的第三個力量是「晶片與模型架構的同步改進」。這點的具體證據比前兩股還多:
| 晶片 | 推論特性 | 相對 H100 成本 |
|---|---|---|
| Cerebras WSE-3 | 44GB on-die SRAM、21 PB/s 頻寬、Llama 3.1 70B 達 2100 tokens/秒 | 推論成本下降 30-70% |
| Google TPU v6/v7 | 內建低精度矩陣單元、推論 throughput 為 H100 的 2-3× | 推論成本下降 30-70% |
| Groq LPU | 確定性低延遲、per-request 計價模式 | 適合 latency-sensitive 工作負載 |
| Nvidia H100 | 目前主流 baseline | — |
GpuNex 的一份分析直接點出:2022 年底跑 GPT-4 等級模型約 20 美元/百萬 tokens,2026 年初等效效能成本已跌到 0.40 美元/百萬 tokens — 3 年內降了 1000 倍。這是運算史上最快的成本下降速度之一。
同時,模型架構本身也在進步:
- MoE(Mixture of Experts) 模型如 DeepSeek V3、GLM-5.2,每次只啟動部分參數,等效算力成本降 3-5 倍
- 快取 token 機制讓重複 prompt 的 input 成本砍半
- 小型化蒸餾模型保留 90% 能力、只跑 30% 算力
換句話說,硬體與軟體兩條路線都在雙重通膨壓縮 frontier 模型的單價空間。
第四股力量:零切換成本 = 永遠有壓價對手
Patadia 第四個論點是 AI 模型的「零切換成本」。傳統軟體(Windows、Office、Adobe、SaaS)有很重的轉換摩擦:你不可能一個下午就把 CRM 從 Salesforce 換到 HubSpot,背後要資料遷移、流程重整、員工再訓練。
AI 模型完全相反:
- OpenRouter 這類 gateway 提供一鍵切換 API
- 模型在同一個對話視窗裡可以用程式自動切換(prompt A 用 GPT,效果不好自動 fallback 到 GLM)
- 開發者甚至可以寫程式根據 cost/quality 動態路由
這個機制讓定價變成「永遠有競爭對手等著搶客戶」。任何 frontier 實驗室想要維持高毛利,就必須持續提供比其他家明顯更好的表現——而這在開源模型快速追上的今天,越來越難。
第五股力量:本地模型才是真正的地板
Patadia 認為五股力量中最關鍵的是本地模型。他的預測是:
- 4-5 年內,新型筆電、手機、桌機將直接內建可跑 7B-13B 等級模型的 NPU
- RAM 價格會崩跌(DDR5、DDR6、HBM),讓本地部署門檻降到一般消費者都能負擔
- 作業系統(Windows、macOS、Android)會原生提供 LLM 介面給 app 呼叫
- 簡單任務(程式碼 tab completion、校稿、查事實)會完全在本地完成
- 雲端 API 只剩處理最複雜的任務
這條路線一旦走通,月費 20 美元或 200 美元的 AI 訂閱會失去大部分價值——消費者買硬體的錢一次付清,後續推論邊際成本趨近於零。
本地模型的關鍵硬體紅利:
- Apple M4 Ultra 已能本地跑 70B 等級模型(量化後)
- AMD MI325X、Nvidia RTX 5090 消費級 GPU 都已內建 FP8 推論加速
- Intel Core Ultra 200V 把 NPU 算力拉到 48 TOPS,本地 LLM 即時推論已經可行
為什麼這件事重要
這篇文章的真正意義不是「LLM 會變便宜」——這點所有從業者都同意。真正的重點是 frontier 實驗室的營收與估值模型會被改寫。
OpenAI、Anthropic、Google、xAI 目前都還在燒錢養用戶、訓練下一代模型、簽下 Nvidia GPU 與電力長約。如果未來 2-3 年內推論單價如 Patadia 預期跌到現在的 1/5 到 1/10,這些公司的損益平衡點(breakeven)會被推得極遠。
對台灣與亞洲的讀者,這代表三件事:
- Nvidia 的 AI 護城河正在被分食:當 Cerebras、Groq、TPU 都能用 30-70% 更便宜的成本提供同級推論,Nvidia 的高毛利會被結構性壓縮。Patadia 沒明講但這是「AI 晶片版圖」可能大洗牌的訊號。
- 開源模型的贏家很可能是中國:GLM-5.2(智譜)、DeepSeek、Kimi K2 全部以 1/10 價格提供 frontier 級表現。當全球開發者都湧向這些模型,中國 AI 產業的營收會爆炸、而美國 frontier 實驗室會失血。
- 個人用戶的 AI 訂閱可能會降價或消失:如果本地模型 4-5 年成熟,OpenAI ChatGPT Pro(月 200 美元)這類高階訂閱的目標客戶(需要頂級模型的工程師)會被本地 + 開源組合取代。OpenAI 必須找到新的營收支柱。
數據解讀與質疑
Patadia 的論點有兩個值得保留質疑的點:
-
「模型表現高原期」是過度解讀:DeepMind 的 Gemini 3.1 Pro 在抽象推理(ARC-AGI-2)拿到破紀錄成績、GPT-5.4 在 computer use 拿 75% OSWorld 分數(超越人類專家 baseline)。這些都不是「高原」,而是特定維度的大幅突破。模型全面性的高原,跟特定能力的突破,是兩件事。Patadia 把兩者混為一談。
-
「本地模型取代雲端」忽略了 context 規模差異:本地跑 7B-13B 模型在簡單任務沒問題,但碰上需要 1M token context 的場景(整個 codebase 分析、長篇合約審閱、跨文件推理)就完全不夠用。雲端 API 會轉型到「大 context + 複雜任務」這個利基,本地模型吃的是「即時小任務」——兩者未必直接競爭。
但即使有這兩個質疑,Patadia 對「推論成本持續下滑、frontier 實驗室毛利被壓縮」的整體趨勢判斷,幾乎所有獨立分析(GpuNex、Spheron、iternal.ai LLM 選擇指南、aimagicx 定價比較)都同意。方向正確、量級待觀察。
重點整理
- 核心論點:GPT-5.5 等 frontier 模型的高單價撐不住,五股力量同時壓縮
- 關鍵數字:2022→2026 推論成本降 1000 倍、GLM-5.2 為 GPT-5.5 的 1/10 價格、Cerebras 推論成本低 H100 30-70%
- 時間軸:本地模型成熟預期 4-5 年(2030-2031)
- 影響範圍:frontier 實驗室營收模型、Nvidia 護城河、開源 vs 閉源競爭、本地 vs 雲端分工
- OpenRouter 數據:2026 上半年 GLM-5.2 與 DeepSeek 系列已成開發者首選
網友熱門留言 (5)