編按:本文綜合整理自 Semgrep 官方部落格、Z.ai GLM-5.2 官方公告、Vals AI 模型評測 及 Hacker News 討論串,並加入 Siami 編輯部觀點與分析。
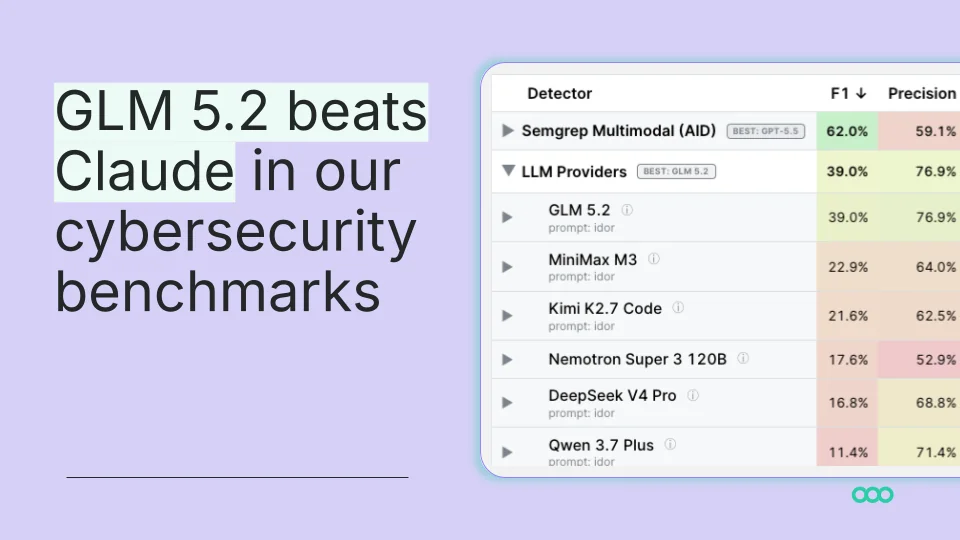
Semgrep 的資安研究團隊最近做了一件對開源社群意義重大的事:他們把自家內部用來評估資安模型的「IDOR(Insecure Direct Object Reference,不安全直接物件參照)漏洞偵測基準」端上檯面,拿給八款主流大語言模型直接對決。結果讓他們自己都嚇一跳——中國智譜 AI(Z.ai)最新發表的開源權重模型 GLM 5.2,只用一個簡單的提示詞(Pydantic AI 框架),就在這項需要推理的資安任務上以 39% F1 分數擊敗 Anthropic 的 Claude Code(32% F1),且每找到一個真實漏洞的成本只要 0.17 美元,大約是閉源旗艦模型的六分之一。
這場對決到底在測什麼
Semgrep 研究的初衷其實不是要評比模型。他們真正想回答的問題更工程、更無聊:**在漏洞偵測這種任務上,表現究竟有多少來自模型本身,又有多少來自圍繞模型的「harness(執行框架)」?**harness 就像鷹架——它負責餵給模型程式碼、決定模型看到什麼、解析模型輸出,再把結果回送。Semgrep 自家的多模態管線就有一套量身打造的鷹架,會先列舉應用程式的 endpoints、再把模型指向重要段落。
但這次測試為了公平,他們剝掉了所有鷹架。八款模型全部跑在同一個簡單的 Pydantic AI 框架裡,拿到同一段 IDOR 提示詞——只比模型本身的實力。
鷹架比模型更關鍵。整張表裡最大的表現差距不是發生在模型之間,而是發生在「有 endpoint 探索」與「沒有」的設定之間。
那 IDOR 是什麼?簡單說就是「存取控制漏洞」:你打開一個 URL、那個 URL 帶著某個使用者 ID,伺服器沒檢查「你是不是本人」就直接把對方的資料吐給你。在實務上,這類漏洞每年都會在大型網站被找出來,是新手與老手都會犯的錯。
排行榜與關鍵數字
Semgrep 把結果整理成一張表,依 F1 分數排序。F1 是精確率(precision)與召回率(recall)的調和平均數,專門用來處理科學偵測——你可以狂報漏洞衝高召回率(但一堆假警報),或者只報你最確定的(精確率超高但漏掉一堆);F1 獎勵兩者兼顧。
| 排名 | 設定 | 鷹架 | F1 |
|---|---|---|---|
| 1 | Semgrep Multimodal(GPT 5.5) | Semgrep Multimodal | 61% |
| 2 | Semgrep Multimodal(Opus 4.8) | Semgrep Multimodal | 53% |
| 3 | GLM 5.2 | 純提示詞(Pydantic AI) | 39% |
| 4 | Claude Code(Opus 4.6) | Claude Code SDK | 37% |
| 5 | Claude Code(Opus 4.8/4.7) | Claude Code SDK | 28% |
| 6 | MiniMax M3 | 純提示詞 | 23% |
| 7 | Kimi K2.7 Code | 純提示詞 | 22% |
| 8 | GPT-5.5 | Codex | 20% |
| 9 | Nemotron Super 3 120B | 純提示詞 | 18% |
| 10 | DeepSeek V4 | 純提示詞 | 17% |
兩個關鍵發現:
- 前三名裡,兩個是 Semgrep 自家鷹架拿下的,證明鷹架確實有效。
- 第三名是真正的重點:GLM 5.2 用零鷹架贏過 Claude Code 的全套 SDK 7 個百分點。
更驚人的是成本。以 GLM 5.2 的 API 報價(輸入 1.40 美元、輸出 4.40 美元每百萬 tokens)計算,這場實測裡每找到一個真實漏洞只要 0.17 美元。當你要掃幾千個 endpoints 時,這種「每個 bug 多少錢」的經濟學往往決定了這套方法能不能大規模落地。
GLM 5.2 是什麼來頭
GLM 5.2 由中國 AI 公司 Z.ai(前身為 Zhipu AI / 智譜) 推出,2026 年 6 月 13 日先提供給 GLM Coding Plan 訂閱用戶,三天後(6 月 16 日)才公開發布模型權重與技術報告。三個關鍵特性讓它在資安圈引起注意:
- 開源權重(Open Weight):採用 MIT 授權。你可以下載參數、在自家硬體上執行、微調、甚至審計模型行為。對企業資安團隊來說,「資料不外流」這件事在閉源 API 上很難保證,本地開源模型是少數乾淨的解方。
- 744B 參數 MoE 架構:稀疏專家模型設計,推理時只啟動部分參數,在效能與成本間取平衡。
- 1M token 上下文視窗:這意味著你可以把整個中型專案的程式碼丟進去而不必切割,是 Semgrep 這類需要全域推理的工作的關鍵。
- 官方報價:1.40 美元 / 百萬 input tokens、4.40 美元 / 百萬 output tokens。
獨立的 Artificial Analysis 評測 把 GLM 5.2 排在開源模型第一、整體第四。前 Meta 與 Google DeepMind 副總裁 Matt Velloso 公開表示他已「整天」使用 GLM 5.2,並稱其為「第一個達到日常 coding driver 標準的開源模型」。
為什麼這件事重要
資安領域一直是閉源模型的堡壘,因為企業客戶不願意把程式碼送到外部 API。但這個假設在 GLM 5.2 這類模型出現後開始鬆動:
- 合規與資料落地:本地開源模型讓金融、醫療、政府機構可以兼顧 AI 效率與資料不出門的要求。
- 成本結構改變:每漏洞 0.17 美元讓「千人團隊全面掃描」這件事第一次有了合理的商業模型。
- 不再被單一供應商綁架:當開源選項在資安這個高敏感任務上接近閉源旗艦,企業就有了議價籌碼與備援。
但 Semgrep 也留了一個重要的但書:這是單一任務、單一資料集、單次執行。IDOR 偵測是非確定的,資料集也是有限的。他們明確說,對 SSRF 偵測的結果可能完全不同——這一點他們會接著測。
數據解讀與質疑
把這份結果照單全收之前,有幾個細節值得放大檢視:
- 不是同類比較:GLM 5.2 用裸提示詞、Claude Code 卻用了自家全套 SDK。換句話說,Claude Code 在這個實驗裡其實是被「綁手綁腳」比較的。
- 第一名仍是閉源:Semgrep Multimodal(GPT 5.5)拿下 61% F1,是 GLM 5.2 的 1.5 倍以上。鷹架的威力遠超模型本身。
- 同溫層效應:GLM 5.2 與下一個開源模型(M3 的 23%)相差 16 分,比它跟 Claude Code 的差距還大。所以結論不是「開源追上來了」,而是「GLM 5.2 自己追上來了」。
- 基於單一任務:IDOR 只是漏洞類型的冰山一角。SSRF、XSS、Race Condition、邏輯漏洞等場景都還沒測過。
- Hacker News 上有人質疑「讀起來像業配」:留言認為這是 Semgrep 在用開源話題推銷自家 Multimodal 產品線;也有人反駁說 Semgrep 的方法論揭露得很完整,且他們的鷹架本來就是賣點。
Semgrep 的結論是:別把雞蛋放在同一個 LLM 籃子裡——即便用最貴的閉源旗艦加最好的鷹架,也別忽略開源模型在成本與可控性上的優勢。
業界反應
Hacker News 上這篇拿下 227 分、82 則留言的熱度,反映出社群對「開源模型在資安任務上擊敗閉源旗艦」這件事的興奮與警覺。留言區大致分三派:
- 務實派:「我週末實測過 GLM 5.2,寫了一個加密 Matrix bot 和一個 Rust 工具 agent,兩天 20 美元搞定。日常 coding 工作馬」——這呼應了 Z.ai Coding Plan 的訂閱熱潮。
- 硬體派:「753B 參數,本地跑要 8 張 RTX6000、8-10 萬美元。與其這樣不如 OpenRouter 訂閱跑十年還有剩。」——這凸顯了「開源 ≠ 免費」的事實。
- 政治派:「在歐洲,Mythos 那種閉源旗艦可能今天還在、明天就因政治因素消失。知道開源模型在哪裡很重要。」——這把技術問題拉到了地緣政治與數位主權的層次。
Semgrep 自己也留了一段有趣的免責:「我們不知道 SSRF 的排行榜會不會翻盤——但我們一定會找出來。」
接下來可以觀察什麼
- Z.ai 是否會端出 SSRF、XSS、Race Condition 的對照實驗? 這會決定 GLM 5.2 在資安圈是真的穩贏,還是只在 IDOR 這個特定任務上強。
- 開源模型是否開始打進企業資安採購名單? 目前 OpenAI、Anthropic 的閉源 API 在這個市場仍是主流,但本地開源的合規優勢不容小覷。
- 744B 規模的本地推理硬體成本曲線:摩爾定律加上專用加速器(H100、B200、國產 AI 晶片)會把「本地跑 744B」這件事從 10 萬美元壓到 1 萬美元的時間點,就是企業真正轉向的時刻。
Siami 編輯部短評:GLM 5.2 在 Semgrep 這場「鷹架歸零」的實驗中勝出,不代表開源已經全面追上閉源——榜單前兩名仍是閉源旗艦加自家鷹架拿下。但它確實證明了至少在一個需要推理的高敏感任務上,開源權重模型已經具備生產可用性,且成本只有閉源的六分之一。對企業資安團隊而言,這代表「必須用閉源 API」這個長期假設,第一次有了被認真檢視的空間。
網友熱門留言 (5)