編按:本文綜合整理自 Dan Unparsed 原稿(danunparsed.com/p/hackerrank-open-source-ats)、HackerRank 官方 GitHub Repo(interviewstreet/hiring-agent)、Hacker News 討論串(439 分、158 則留言),並加入 Siami 編輯部觀點與分析。工程師求職市場最近被一枚深水炸彈炸開——HackerRank 把他們用來評分所有求職者的內部 AI 履歷評分系統完整開源,放在 GitHub 的
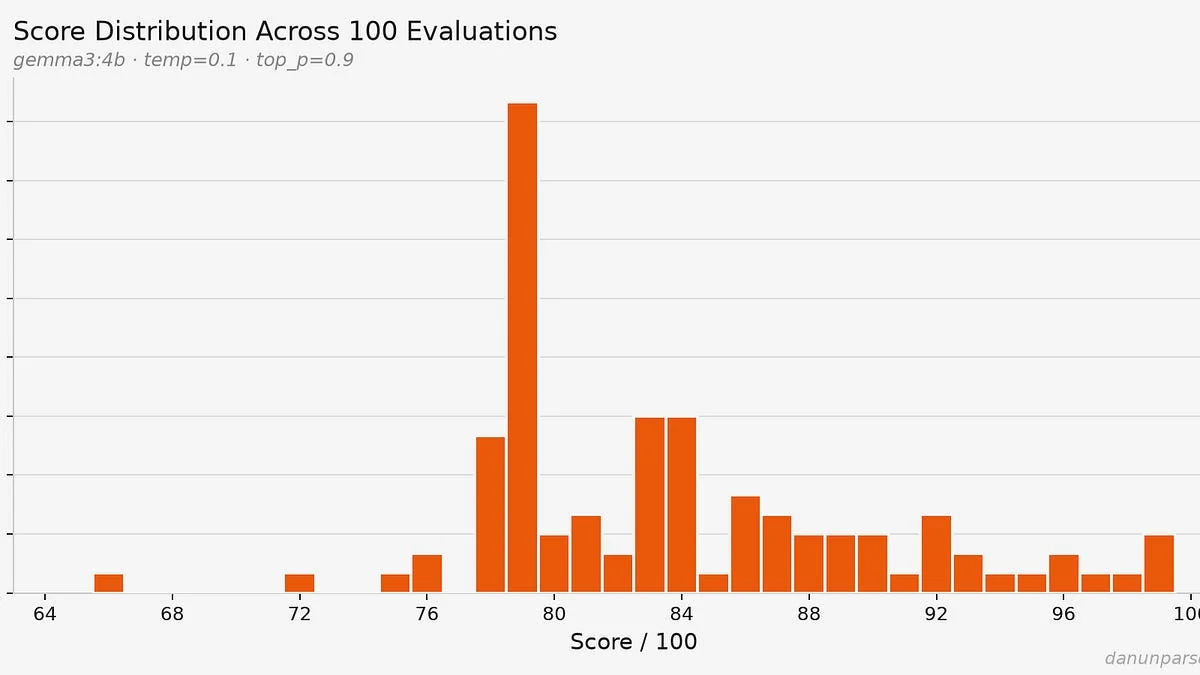
interviewstreet/hiring-agent倉庫。開源不到一週,LinkedIn 與 Reddit 湧入上萬讚數,Hacker News 主頁衝到 439 分。真正引爆社群的不是「HackerRank 居然開源」這件事,而是任何人都能本地跑這套工具以後,赫然發現:同一份履歷跑 100 次,分數會從 66 跳到 99。
開了什麼:HackerRank 的履歷評分管線
interviewstreet/hiring-agent 是一條「履歷 → 分數」的完整管線。預設模型是本地跑的 gemma3:4b,同樣支援 Google Gemini。流程如下:
-
第一步:解析 PDF。 使用
pymupdf_rag.py把履歷每一頁轉成 Markdown 風格的純文字。 -
第二步:分塊抽取結構化資訊。 透過
pdf.py與prompts/templates底下的 Jinja 模板,分六次呼叫 LLM,依序抽出基本資料、工作經歷、學歷、技能、專案、獎項。 -
第三步:補上 GitHub 訊號。
github.py抓取候選人的 GitHub 個人頁、掃前幾個 repo,叫 LLM 從中挑出 7 個代表作。 -
第四步:整合評分。 上面所有資料一次餵給 LLM,輸出包含類別分數、證據、額外加分與扣分的完整評估。整套評分滿分 100 分,另外最多加 20 分獎勵:
-
開源貢獻 35 分
-
個人專案 30 分
-
工作經歷 25 分
-
技術技能 10 分
-
額外加分(創業經歷、作品集網站、技術部落格等)最多 20 分
實測結果:骰子比評審還準工程師 Dan Kinsky 把這套系統下載到本地後跑了一百次同樣的履歷,前三次分數分別是 90、74、88,後續又跑出 83 分。關掉 DEVELOPMENT_MODE、進入正式評分模式後,100 次結果的分佈區間是 66 到 99。如果一家公司的錄取切線設在 85,這份履歷會有 65% 的機率被刷掉——而且每次刷掉的理由都一模一樣:「履歷條件未達標」。
把溫度(temperature)從預設的 0.1 降到 0 並沒有解決問題。2025 年 10 月就有人在 GitHub issue 貼出連續六次跑出 27、34、32、34、34、30 的分數序列,這不是模型 bug,是管線設計的根本缺陷。換成 Gemini 之後分數比較集中,落在 48 到 64 之間——但如果切線是 60,候選人仍然有 28% 的機率被冤枉刷掉。
各維度的崩壞程度不一樣把四個維度拆開來看,「技術技能」幾乎每次都是 8/10。原因很直白:技術技能是 checklist,會 React 就勾,不會就不勾,五歲小孩都能對答案。但換到「專案」這個維度就崩盤——LLM 對「這個專案有沒有展示架構複雜度」「是否真有上線部署」這類判斷完全不一致,同一份專案一會兒被說「缺乏架構深度」,一會兒被說「展現真實世界部署經驗」,全看 LLM 當下心情。「工作經歷」維度更令人傻眼。每次都跑出 25/25,滿分。一份只有一段實習經歷的舊履歷拿來跑,也是 25/25。原因是 prompt 裡頭這段只有兩行:
Production (0-25 points) — Analyze the ‘work’ and ‘volunteer’ sections for real-world, internship, or production experience. SPECIAL CONSIDERATION: Give extra points for founder roles, co-founder positions, or early-stage engineer roles (first 10-20 employees) at startups.
沒有 rubric、沒有 example、沒有 15 分跟 25 分的對應錨點。一個有一年實習的 junior engineer 拿 25 分,一個有十年分散式系統經驗的 principal engineer 也拿 25 分。分數穩定,但完全無用。
為什麼這件事重要
HackerRank 過去是企業徵才端常見的 ATS 之一。他們自家的招募流程——也就是大量科技公司用來做第一輪篩選的那條管線——現在被證明在核心判斷項目上幾乎等於擲硬幣。問題不只是 HackerRank,這是整個 LLM-as-screener 產業的通病:把一個本質上機率的工具,當成確定性的篩子用。更關鍵的是加權方式。整套評分把 65% 比重壓在「開源 + 個人專案」兩個項目。這意味著大量把精力花在工作上、沒有空經營 GitHub 與 side project 的工程師——也就是業界最主流的那群人——會在第一輪就被 AI 刷掉一半。這對整個招募市場的扭曲效應,不會只停留在 HackerRank 自己。
這是 2025 年 BBC 報導「AI 招募工具正在篩掉最優秀求職者」的具體實現版:不再是抽象的擔憂,而是可以本地重現、量化分析的失敗模式。作者在文末點出一個尖銳的矛盾:寧願選那位「有 30 年經驗、打造過 S3 服務的工程師」,但這套工具會選那兩個只有實習經歷、外加一份開源專案的候選人。招募端最在意的「業界口碑」與「內部推薦」,在這條管線裡完全沒被評分。
數據解讀與質疑這份開源揭露了 AI 招募工具三個結構性問題:
- 非確定性是設計缺陷,不是參數 bug。 把溫度調到 0、換模型,都無法解決。LLM 在判斷類任務上的機率本質,跟 checklist 解析任務的確定性,差距是結構性的。
- Rubric 不完整比模型錯誤更致命。 工作經歷維度沒有錨點,導致所有候選人在這個項目都拿 25 分——表面「穩定」,實際上什麼都沒在篩選。
- 加權設計暴露商業偏見。 65% 壓在開源 + 個人專案,與「公司想找的工程師類型」沒有強相關——更接近「HackerRank 想推廣自家開源社群文化」。需要質疑的是:HackerRank 把這套工具開源,是出於透明度善意,還是行銷操作?從 commit history 來看,repo 早在 2025 年 10 月就已經公開,只是這週才在社群爆紅。社群爆紅與「開源」這件事,未必同步發生。
後續發展與社群反應
Hacker News 主頁討論串衝到 439 分、158 則留言,工程師圈主流意見分兩派。一派認為「至少 HR 不用親自讀 1,000 份履歷了,這是進步」;另一派則認為,「與其用這種東西,不如真的擲硬幣,至少成本更低、邏輯更透明」。
GitHub Issues 區已經累積多個針對性的 bug 報告:本地 Ollama 模型無法穩定抽取特定欄位、安全性漏洞(隱藏的 PDF 文字會汙染抽取結果、灌水分數)、錯誤訊息設計不良(找不到模型時丟出 404 而不是警告)。這些 issue 顯示,工具本身還在非常早期的階段,但已經被拿來當作「徵才決策依據」使用。
如果工程師在公司招募流程有任何決策權,請謹慎對待 AI 履歷篩選工具。一個無法分辨實力高低的工具,不是品質篩選器,只是運氣篩選器。最諷刺的是,這整套系統連「自己內部定義的招募維度」都無法穩定打分,卻被拿來給真人的職涯下重大決定。開源是好事,但「可以公開重現」與「可以拿來用」是兩回事。
網友熱門留言 (5)