編按:本文綜合整理自 Quesma Blog — Piotr Migdał、Qwen 官方 Qwen3.6-27B 文章、Hacker News 討論串,並加入 Siami 編輯部觀點與分析。
工程師社群最近有個反覆出現的話題:Qwen 3.6 27B 是不是第一個「真的能用」的本地大語言模型?
來自波蘭的資料科學家、同時也是資料可觀察性公司 Quesma 共同創辦人 Piotr Migdał,6 月 29 日在自家部落格發了一篇文章,標題直接下:「Qwen 3.6 27B is the sweet spot for local development」。他直言,這是他第一次覺得本機跑的模型真的能當成「通用智慧」在工作流中使用。文章當天衝上 Hacker News 首頁,累積 467 分、412 則留言,是本週 AI 開源圈最熱的話題之一。
對中文圈的讀者來說,Qwen(通義千問)不陌生,背後是阿里巴巴達摩院。但這次不一樣的是:27B 是 dense 模型(非 MoE 混合專家架構),而且原生支援 256K context、用 llama.cpp 加上 Multi-Token Prediction (MTP) 之後速度翻倍。它意味著你不必依賴雲端 API、也不必花大錢買多卡 GPU——一台 128GB 的 Macbook Max M5,或一張 RTX 5090,就能跑出逼近 Claude Sonnet 4.5 等級的程式碼品質。
下面整理 Migdał 的實測數據、Qwen 官方技術細節,以及 Siami 編輯部的解讀。
為什麼這件事重要
過去兩年,open-weight 模型(如 Llama、Mistral、早期 Qwen)一直有個明顯的「實力天花板」:能聊天、寫簡單信,但碰到稍微複雜的推理、長文脈、agentic workflow 就破功。要做到接近 GPT-4 等級的工作,大家只能回頭訂閱 OpenAI、Anthropic 的 API。
Qwen 3.6 27B 的特殊性在於,它打破了這個天花板:
- 品質分界線突破:在 Artificial Analysis 的獨立評測中,Qwen 3.6 27B 拿下 37 分,等級對標 2025 年中的 GPT-5 與 Claude Sonnet 4.5——這是 dense 模型(非 MoE)第一次在「中等參數量」(27B)衝到這個層級。
- 硬體門檻大幅降低:Q4–Q8 的 8-bit 量化版本只要約 28GB RAM 就能跑。對照 DeepSeek V4 Flash(DwarfStar4 量化版)同樣分數要 103GB RAM,27B 版本的「瓦數/性能比」明顯勝出。
- MTP 加持速度翻倍:內建 Multi-Token Prediction 推論頭,配合 llama.cpp 的
draft-mtp模式,可達 2.7× 推論加速。在 5090 上能跑到 50 tokens/s,長 context(123K)依然穩定。
「For me it’s the first local model that actually makes sense as a general intelligence.」— Piotr Migdał
這對開發者、隱私敏感產業(醫療、法律、國防)、企業內部 AI 部署來說,Qwen 3.6 27B 是 2026 年第一個真正「可交付」的開源選項。
硬體實測:Macbook、RTX 5090 都能跑
Migdał 在 Macbook Max M5 128GB 上做了詳細 benchmark,並與 DeepSeek V4 Flash(DwarfStar4 量化)對照:
| 模型 | 量化 | 後端 | 速度 | 記憶體 |
|---|---|---|---|---|
| Qwen 3.6 35B A3B | 8-bit | MLX | 85 tok/s | 37 GB |
| Qwen 3.6 35B A3B | 8-bit | llama.cpp | 93 tok/s | 44 GB |
| Qwen 3.6 35B A3B + MTP | 8-bit | llama.cpp | 105 tok/s | 45 GB |
| Qwen 3.6 27B | 8-bit | MLX | 17 tok/s | 28 GB |
| Qwen 3.6 27B | 8-bit | llama.cpp | 18 tok/s | 41 GB |
| Qwen 3.6 27B + MTP | 8-bit | llama.cpp | 32 tok/s | 42 GB |
| DeepSeek V4 Flash | Q2–Q4 | llama.cpp | 33 tok/s | 103 GB |
幾個重點觀察:
- 27B 配 MTP = 32 tok/s,已經在主流 frontier API(如 GPT-5、Claude Sonnet)的速度範圍內。
- 35B A3B 速度是 27B 的 3 倍,但 Migdał 個人偏好 27B:「我寧可少寫 1/3 的程式碼,但品質好一點。」
- HN 網友
gfosco在 5090 上的實測:Q6_K 量化、Q4_0 KV cache、123K context,穩定 50 tok/s,用 28/32GB VRAM——比 Macbook 更便宜、跑更快。 - llama.cpp 在 Macbook 上比 MLX 略快(95% GPU 使用率),跟一般社群「Apple Silicon 用 MLX」的建議相反,Migdał 認為是因為 MTP 整合度。
怎麼自己跑起來
1. 用 llama.cpp(推薦)
直接抓 Hugging Face 上的量化版本:
llama-server -hf unsloth/Qwen3.6-27B-MTP-GGUF:Q8_0 \
    --spec-type draft-mtp -ngl 999 -fa on -c 65536 --port 8080
參數解釋:
--spec-type draft-mtp:啟用 Multi-Token Prediction,速度翻倍-ngl 999:把全部 layer 卸到 GPU-fa on:啟用 Flash Attention-c 65536:context 設 64K(原生支援到 256K,可調高)
啟動後打開 http://127.0.0.1:8080 就能直接對話。
2. 接到 vibe coding 工具
把 llama.cpp 當 OpenAI 相容 API server,配 OpenCode / Pi / Hermes 都行。OpenCode 設定範例:
{
  "provider": {
    "llama": {
      "name": "llama.cpp (local)",
      "npm": "@ai-sdk/openai-compatible",
      "options": {
        "baseURL": "http://127.0.0.1:8080/v1",
        "apiKey": "local"
      },
      "models": {
        "qwen3.6-27b": { "name": "Qwen3.6-27B Q8 +MTP" }
      }
    }
  },
  "model": "llama/qwen3.6-27b"
}
Migdał 特別註明:不推薦 Ollama。他在文章中基於「道德理由」反對 Ollama 的部分封閉策略(具體細節他未在文中展開,但這是他在開源圈的長期立場)。對想完全掌控底層的使用者,llama.cpp + 直接從 Hugging Face 抓 GGUF 是最乾淨的路徑。
Benchmark 對照:Qwen 3.6 27B 到底多強?
| 模型 | Artificial Analysis 分數 | 大約對標 |
|---|---|---|
| Gemma 4 31B | 29 | 2024 末 o1 / Claude 3.5 Sonnet |
| Qwen 3.6 35B A3B | 32 | 2025 初 o3 / Claude 4 Sonnet |
| Qwen 3.6 27B | 37 | 2025 中 GPT-5 / Claude Sonnet 4.5 |
| DeepSeek V4 Flash | 40 | 2025 末 GPT-5.2 / Claude Opus 4.5 |
37 分的意義:
- 在 8-bit 量化下,Qwen 3.6 27B 跟 Qwen 3.5-27B 進步不大(HN 用戶
nunodonato留言指出)。 - 但對照 DeepSeek V4 Flash 必須用 Q2–Q4 量化(精度犧牲大),Qwen 3.6 27B 用 8-bit 就能達到接近水準——代表它的「真實可用度」更高,長 context(256K)也才撐得住。
- Gemma 4 31B 仍是很多本地開發者的預設選擇,但根據 Migdał 的實測與社群共識,Qwen 3.6 27B 已大幅超越 Gemma 4 31B。
數據解讀:開源 vs 閉源的界線正在模糊
這篇文章的核心訊息不只是「Qwen 3.6 27B 很強」,而是開源 LLM 的「品質價格比」已經追上閉源前沿:
- 2025 年中的 frontier 品質,現在 27B 開源就能跑到。這是 dense 模型第一次做到。
- 本地推論成本大幅下降。一台 5 萬元的 Macbook Max M5 128GB + Qwen 3.6 27B + MTP 推論頭,產出可以等於每月花 100 美元訂閱 Claude Pro 的工作品質。
- fine-tuning 路徑打開。27B dense 模型對企業來說是最舒服的尺寸:可以在一張 A100/H100 上 fine-tune(搭配 LoRA),不必動用 multi-node 叢集。
- 供應鏈風險降低。Claude Fable 5 被下架的事件還歷歷在目,企業越來越不敢把核心 workflow 綁在單一閉源模型上。
Migdał 在文末提到:「我相信未來會有比現有 SOTA 更聰明、又能跑在手機上的模型」。他推測下一代模型會把「事實知識」與「推論能力」分開,把事實知識交給 tool calling(RAG、瀏覽器、API),模型本身只負責「怎麼想」——這會讓模型參數量可以再壓低、推論速度再提升。
質疑與未驗證點
雖然 Migdał 的實測數據很有說服力,但有幾點 Siami 編輯部認為需要保留:
- 8-bit 量化對 benchmark 影響的官方數據不明。DeepSeek V4 Flash 用 Q2–Q4 量化,分數被嚴重低估。Qwen 3.6 27B 用 8-bit 量化拿 37 分,但若跑全精度(BF16)可能更高——也可能只是持平。
- 「punches above its weight」這類社群說法偏主觀。Artificial Analysis 的單一綜合分數無法呈現長 context 推理、agentic workflow、多輪對話的細節表現。
- 作者強烈推薦 llama.cpp、反對 Ollama是個人立場。對一般使用者來說,Ollama 的 DX 仍遠比 llama.cpp CLI 友善。Siami 建議:如果你是 Mac/Windows 桌面用戶,Ollama + LM Studio 仍是低摩擦首選;如果你是 Linux 工程師、想完全掌控底層,再選 llama.cpp。
- 「真實工作」章節的 demo 都是較短任務。Migdał 自己承認:hex 踩地雷、單頁小工具「對前沿模型來說不算什麼」。長程、跨檔案 refactor 的能力還沒看到嚴格測試。
- Qwen 3.6 27B 雖開源,但商用授權仍須確認。Apache 2.0(GitHub 主倉庫)是寬鬆的,但企業用於自家產品前仍應諮詢法務。
結論:2026 是「本地 LLM 年」的起點
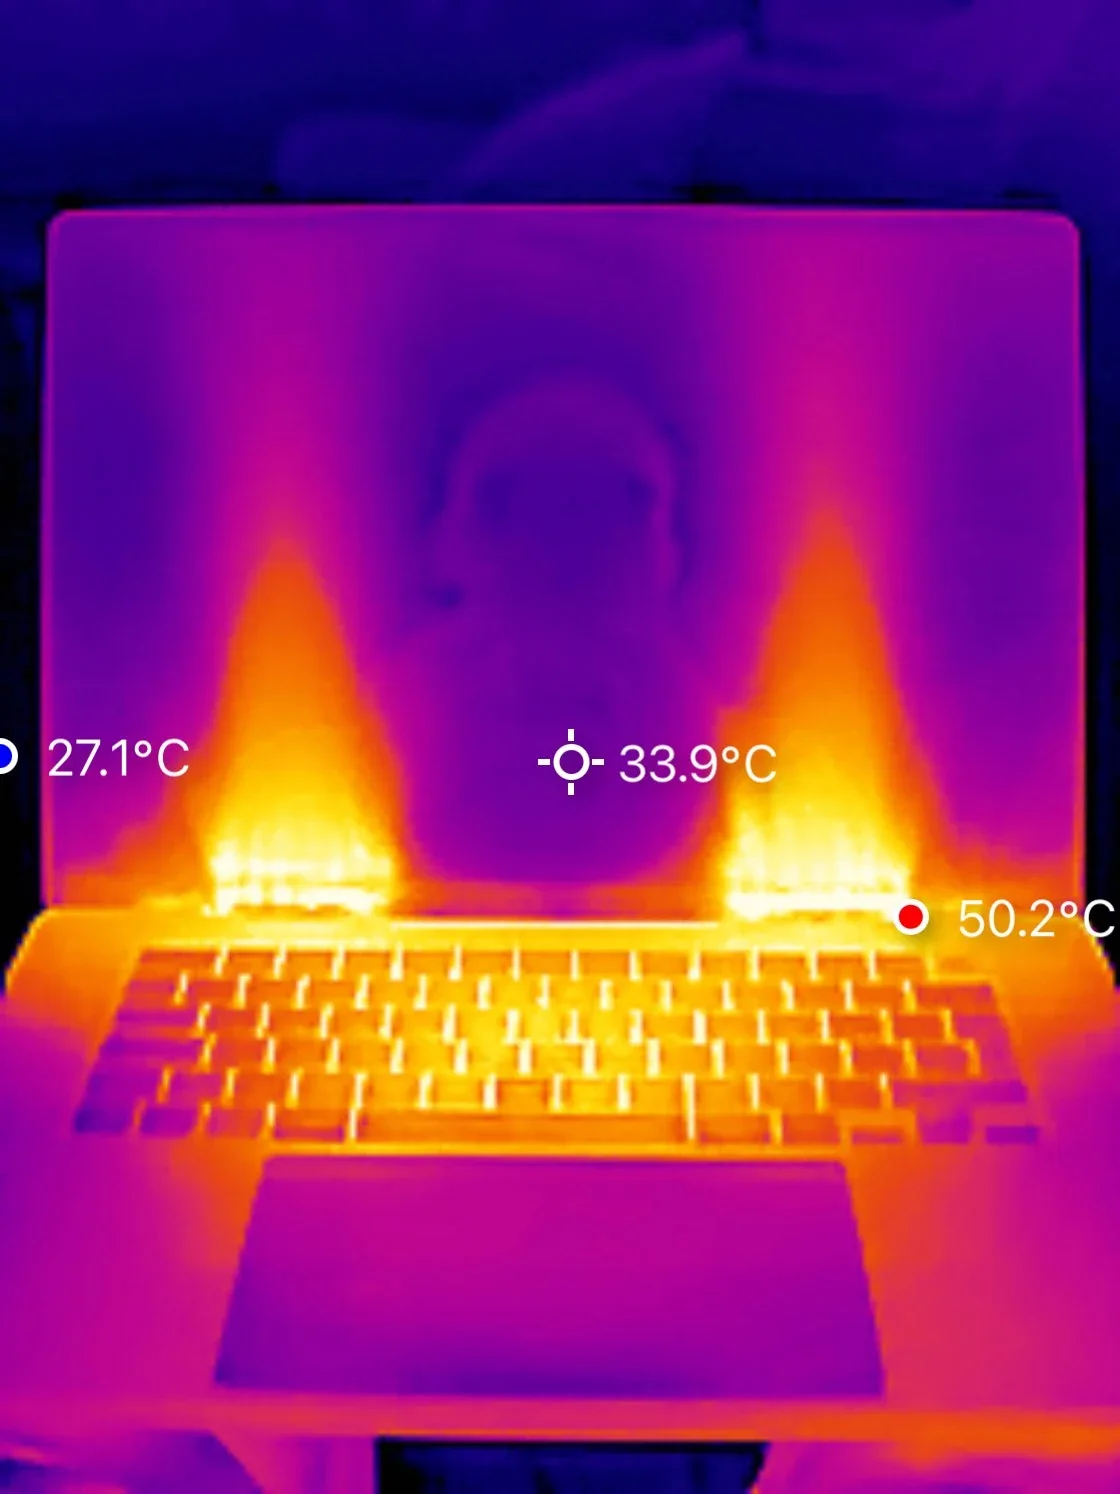
Qwen 3.6 27B 不是完美的——它跑起來會讓你的 Macbook 燙到「膝蓋融化」、速度仍比 35B A3B 慢 3 倍、在 256K 長 context 下會吃大量 RAM。但它標誌了一個技術分水嶺:
2026 年中,第一個「真的能在本機取代閉源 API」的 open-weight dense 模型問世了。
對台灣與中文圈的開發者,這代表:
- 隱私敏感的產業(醫療、法律、金融)可以部署企業內部 AI 而不依賴境外 API
- 個人開發者可以用中階硬體跑出接近 GPT-5 品質的 vibe coding 助手
- 開源社群從「追趕閉源」進入「選擇性超越」的階段
下一步關注 Qwen 3.7-Max(已於 5 月 19 日 API-only 發布,開源權重尚未釋出)、GLM 5.2(frontier 級開源)、以及 Apple Intelligence / Qualcomm 本地推論的整合進度。
參考資料
- Quesma Blog — Qwen 3.6 27B is the sweet spot for local development(本文主要來源,作者 Piotr Migdał)
- Qwen 官方部落格 — Qwen3.6-27B: Flagship-Level Coding in a 27B Dense Model
- QwenLM GitHub — Qwen3.6
- Hacker News 討論串(48721903)
- froggeric/Qwen3.6-27B-MTP-GGUF(Hugging Face 上的 MTP 強化版本)
- Yotta Labs 比較文 — Qwen 3.7 vs Qwen 3.6
- Codersera 比較文 — Qwen 3.7 vs Qwen 3.6