編按:本文綜合整理自 Moondream 官方工程部落格、HyperAI 獨立報導、Digg 聚合報導,並加入 Siami 編輯部觀點與分析。Moondream 為當事公司原始稿,符合白名單。
問題:GPU 不是算太慢,而是空轉太久
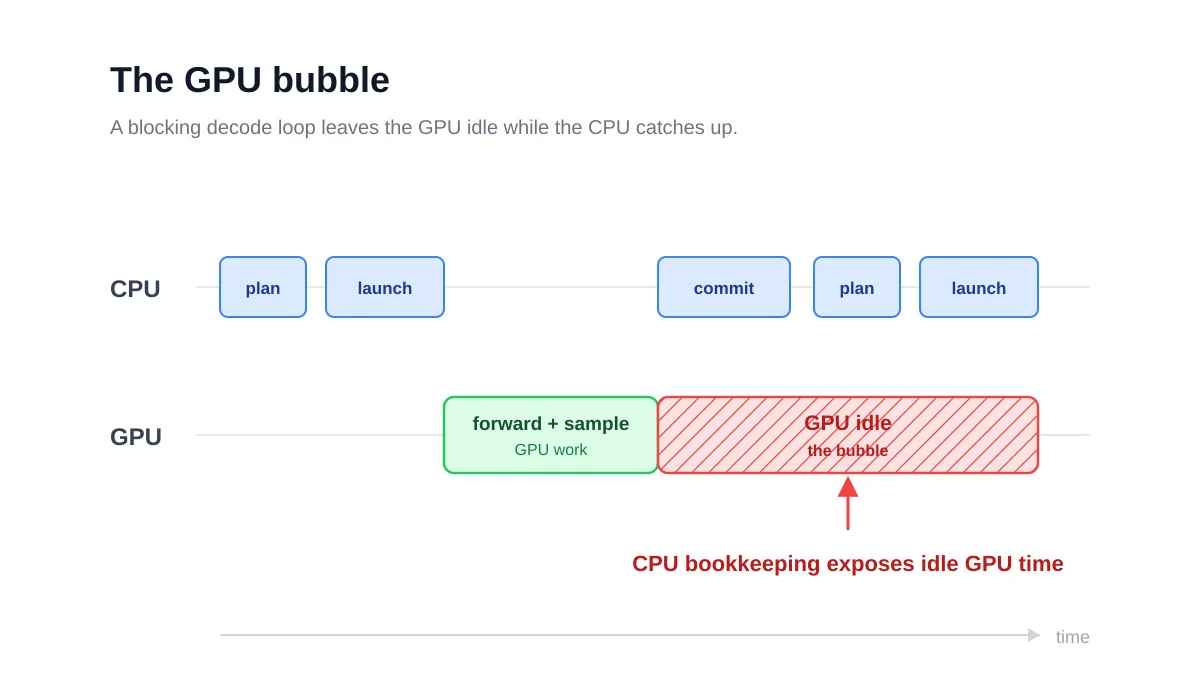
Moondream 在 2026 年 6 月 4 日發表技術長文《Popping the GPU Bubble》,揭露自家 Photon 推論引擎如何解決一個被低估的效能瓶頸:不是 GPU 算得不夠快,而是 GPU 經常在空轉等 CPU 安排工作。
這個現象他們命名為「GPU bubble」。當一個典型的自迴歸(autoregressive)語言模型生成文字時,每一次只產出一個 token,而每個 token 都依賴前面所有 token。這種序列依賴讓 GPU 必須等 CPU 完成「選 request、準備 metadata、取 token、寫回結果」等一連串瑣事後,才能開始下一輪運算。如果一個 token 的 GPU 工作量很小,CPU 的 housekeeping 就是每輪的固定成本——GPU 等到這些做完才動,於是產生大量空檔。
Moondream 在 NVIDIA B200 上實測達到 33ms VLM 推論(即時等級),相較於傳統 blocking decode loop 解碼吞吐量提升最高 35%。在 H100 上則是 46ms 端到端推論、60+ fps。
解法:Pipelined Decoding 三件套
Photon 的核心技術是「pipeline 解碼」,概念很直覺:不要等這一個 token 完全結束才開始下一個 token。把 CPU housekeeping 推到背景跑,同時讓 GPU 已經在算下一輪 forward。三個關鍵機制互相搭配:
- Ping-pong buffer slots:用兩個 buffer slot 交替,防止資料碰撞的同時讓執行可以重疊。這是經典的 double buffering 概念,從 GPU 渲染時代就在用,但在 LLM 推論裡因為 KV cache 與中間狀態變得很複雜。
- Forward-now-sample-later:把 token 生成與 constrained decoding mask 解耦。原本每輪都要先 sample 完才知道下一輪的合法 token 集合,現在改成先做 forward 把 logits 算出來,sample 留到背景跑,下一輪的 mask 可以依賴「承諾中的 token」而非「已 sample 完成的 token」。
- Reference counting for zombie sequences:用 reference count 管理已經完成但還沒清掉的 request,避免中途取消的 overhead。這對 real-time streaming 很重要。
把 token 非同步傳回 host memory 時,下一輪 forward 已經在跑了——同步瓶頸被消掉。Moondream 強調 pipeline 解碼只是整套優化的一部分。他們的完整 stack 還包含 dynamic image tiling、自訂 inference kernels、排程器順序優化等,加乘效果才讓 Photon 能撐住高頻短 request 的工作負載。
Moondream 同步確認 Photon 2.0 正在開發中,會是「重大架構進展」,但未透露細節。
為什麼這件事重要
這篇文章表面上在講一個小模型推論引擎的工程最佳化,實際上反映了 AI 基礎建設的兩個更深層的轉變:
第一,GPU 摩爾定律敘事正在被打破。過去五年業界把「更快模型」等同於「更大 GPU」,但 B200、H200、Blackwell Ultra 每代的成本/效能邊際遞減越來越明顯。當 NVIDIA 自家也在推「context window 拉到百萬 token」「推論成本砍 90%」這類話術時,真正能拉開差距的已經不是買更多卡,而是把每張卡的每個 cycle 榨乾。Moondream 揭露的 35% 提升是 free lunch——同樣硬體、同樣模型、同樣電力,多跑三成五的 throughput。這才是企業 AI 部署真正在乎的事。
第二,小型模型 + 即時推論是下一個戰場。從 Moondream 的選擇(VLM 小模型、edge deployment 優先)到 HN 評論 rjzzleep 點出的「實際有用的 AI 應用大多不是 LLM」,可以看出:出口管制逼大家思考如何用更少算力做更多事。Moondream 自家 Jetson 支援、Mac 支援都指向同一個方向——端到端即時推論讓 VLM 跑在邊緣設備上,這個市場比 hyperscaler GPU 採購大得多。
Siami 觀點:這篇文章是 AI 推論領域少數公開談論「GPU idle time」的公司之一。絕大多數 inference engine(vLLM、TGI、SGLang)的開發者雖然心知肚明,但很少有像 Moondream 這樣把 bubble 概念、forward-now-sample-later 解耦、reference counting 三件事寫成完整技術敘事的。對正在自建推論堆疊的工程團隊,這篇文章值得讀三遍。
數據解讀與質疑
把 Moondream 的 benchmark 拆開來看:
- 35% 提升是上限,不是平均。HyperAI 報導指出實際範圍是 6% 到 35%,取決於硬體世代與 batch size。B200 跑 32 個並行 stream 才能到 35%,3090 上只有 +12%。在 batch size 1、即時互動的場景下,這個數字會縮水不少。
- 33ms 是 VLM,不是純 LLM。Moondream 是視覺語言模型,整個 forward pass 包括 image preprocessing。如果只算 LLM decoder,數字會更漂亮,但對終端使用者沒意義——他們看到的是 E2E latency。
- HN 用戶 augment_me 質疑有 CODEX 指紋。這個批評指的是文章風格暗示了 GPT-5-Codex 的影子(偏好 CUDA streams 敘事)。這代表文章雖然是 Moondream 工程師署名,但段落潤飾可能經過 AI 協作。技術內容仍可信,但行文不代表人類工程師的純手寫。
- gardnr 點出和 Speculative Pipeline Decoding 是不同東西。arXiv 2605.30852 講的是用 draft model 加速的 speculative decoding,跟 Moondream 的 pipeline 解碼是不同的最佳化路徑。Moondream 的方法是純排程最佳化,不需 draft model,適用範圍更廣但理論加速比低於 speculative decoding。
- VLM 推論最佳化難以直接套用到 LLM。Photon 的 dynamic image tiling 是 VLM 特有,但 pipeline 解碼本身對純文字 LLM 也有效。Moondream 把通用部分寫出來,等於給整個 LLM 推論社群一個可借鏡的藍圖。
結論:Moondream 揭露的 35% 提升是「在自家 benchmark 條件下」的真實數字,但讀者要意識到這是上限值、且前提是 VLM 小模型 + B200 + 高並行 stream。對於 batch size 1、純文字、單卡部署的場景,預期提升幅度會小得多。
後續發展
Moondream 在 2026 年 6 月 28 日又發布了 Photon 1.3.0,把支援擴展到 Apple Silicon、Windows 和 Jetson Thor,並修復舊 GPU 精度問題。Photon 2.0 預期會在 2026 下半年釋出,定位為「重大架構進展」。Moondream 同時把 Moondream 本地推論的部署從收費改為完全免費,明確要把社區使用量衝起來。
對開發者社群來說,這篇文章最直接的價值是把「GPU bubble」這個概念從封閉的 ML systems 工程師圈子裡拉出來——HN 評論 radq 也感謝說這類知識「通常鎖在從業者腦袋裡」。Siami 認為這是 2026 年 AI 基礎建設最重要的轉變之一:從「買更多卡」轉向「榨乾每張卡」。
研究分類(引用來源)
| 來源 | 類型 | 用途 |
|---|---|---|
| Moondream 工程部落格原文 | 當事公司原始稿 | 一手技術細節 |
| HyperAI 獨立報導 | 外部獨立媒體 | benchmark 數據與方法學 |
| Digg 聚合報導 | 科技聚合站 | 社群討論脈絡 |
| Photon 產品頁 | 當事公司 | 部署架構與硬體支援 |
| @vikhyatk X 推文 | 作者原始推文 | 公開宣告與後續討論 |
| @moondreamai X 推文 | 公司官方帳號 | Photon 首次發表時的效能數據 |
| HN 討論串 | 技術社群 | 從業人員質疑與延伸 |
Siami 編輯部結論
Moondream Photon 的 pipeline 解碼不是什麼石破天驚的新演算法——double buffering、speculative execution 的概念在作業系統和編譯器領域已經用了幾十年。但 Moondream 把它們精心組合起來,套到 VLM 推論這種現代 workload 上,並且願意把工程細節公開,這件事本身就是對 AI 基礎建設社群的一份禮物。
2026 年下半年值得追蹤的是:Photon 2.0 是否能突破 50% 提升?Moondream 能否吸引到 hyperscaler 級別的客戶把工作負載從 vLLM 搬到 Photon?以及這波「GPU bubble」概念會不會被 NVIDIA 自己吸收進 TensorRT-LLM?
這些問題的答案,會決定 2027 年 AI 推論成本曲線的走向。
網友熱門留言 (5)