Ploy AI 於 2026 年 7 月 9 日將其生產環境的 AI 代理從 Anthropic 的 Claude Opus 4.8 遷移到 OpenAI 當天發布的旗艦模型 GPT-5.6 Sol。這是首批公開揭露「在真實生產負載下跑滿四個月 Opus、最後被 GPT-5.6 Sol 取代」的工程紀錄之一。內部評估顯示:建置任務完成時間縮短到原本不到一半,總成本下降 27%,輸出 token 數量減少約一半,且評分與既有 incumbent 持平或更佳。
Ploy 的代理負責建構與編輯實際上線的行銷網站:規劃頁面結構、讀取既有程式碼、生成元件、產出圖片、自行截圖檢查、判斷任務結束時機。團隊每當有新前沿模型釋出,便會拿同樣的工作負載做 head-to-head 評估。在長達四個月的 Opus(先後為 4.7 與 4.8)擔任預設模型的期間,所有參測模型都未能超越。直到 GPT-5.6 Sol 出現。
編按:本文綜合整理自 Ploy AI 官方部落格、OpenAI 官方發表、Artificial Analysis 評測、The Decoder 與 The New Stack,並加入 Siami 編輯部觀點與分析。
遷移前必須先修評估框架
Ploy 團隊使用 Vercel 的 AI SDK 串接 Claude 與 OpenAI。即便如此,從 Opus 4.8 切換到 GPT-5.6 Sol 時,整個技術棧還是暴露了大量「以 Claude 行為為預設」的假設——兩家供應商在「如何填入工具參數」、「如何快取 prompt」、「如何在多輪對話間重播推理」這些層面的實作完全不同。他們的第一步不是「信任模型比較數字」,而是先修評估框架(eval harness)。他們的評估套件涵蓋數百個情境,從「從零建構首頁」到「這個 clone 請求是否安全執行」都有。對於建構任務,視覺判官會對照參考設計跑十項二元檢查,例如「hero 區塊是否為全幅圖片場景」、「主要 CTA 是否為圓角矩形而非藥丸形」;同時搭配內容檢查、工具軌跡檢查與檔案斷言。第一次跨模型跑評估時,框架本身的設計缺陷就先被掀了出來:
- Tool-call 預算不符行為:他們原本把工具呼叫預算設計成「符合 Opus 的循序呼叫風格」,但 GPT-5.6 傾向平行呼叫、會在實際解對的情境下撞預算上限。評估執行器也缺乏批次讀檔支援,而這正是 GPT-5.6 經常使用、Opus 很少用的功能。原始失敗中約三分之一來自框架假設、而非模型能力,且分布極不平均。
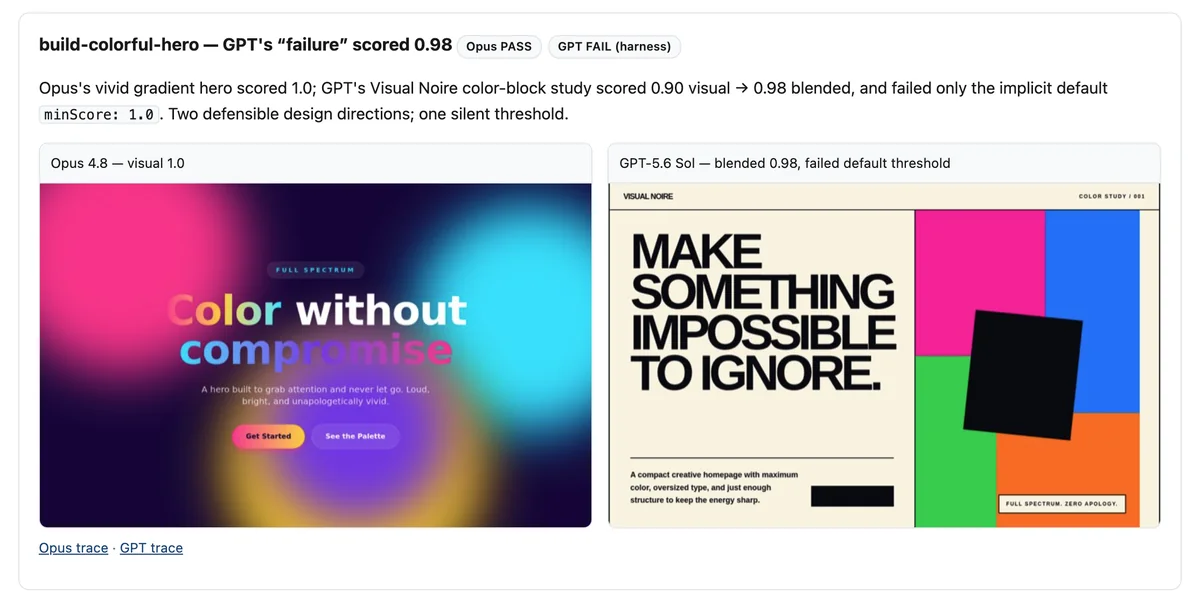
- 隱式門檻失效:有個資料集忘了設定
minScore門檻,因此繼承了 1.0 的預設值。GPT-5.6 因而被判為在一個 0.98 分的 hero 上「失敗」,Opus 則在每項檢查都通過的情境下被判為「失敗」。兩種結果都站得住腳,但預設門檻讓兩邊都翻車。
Ploy 工程團隊因此提醒:「在挑戰者對上 incumbent 時,先對 traces 做分流處理,再相信通過率;否則你的評估只是在獎勵『表現得像舊模型的新模型』。」
修完框架後的真實戰績修正評估框架後,Ploy 重跑了「重建品牌首頁」的設計重做套件。GPT-5.6 Sol 的表現如下:
- 頁面建置時間縮短到 2.2×(也就是「少於一半的 wall-clock time」)
- 總成本下降 27%
- 輸出 token 數量約為 Opus 的一半
- 產出程式碼量更少
在一組配對測試中,Opus 產出了 17,957 字元的 globals.css,包含 174 個 CSS 變數(其中多數是沒用到的色階);GPT-5.6 只用 2,508 字元與 45 個變數,最終渲染結果相當、有時甚至更好。不過 GPT-5.6 也有明顯傾向:它擅長乾淨、嚴格柵格化的佈局,但若沒有強而有力的風格引導,會自動收斂到那種「乾淨但平庸」的版型。在為 Opus 4.8 設計的舊框架下,GPT-5.6 Sol 經常忽略既有設計系統、產出乾淨但普通的結果。為此,Ploy 的設計與工程團隊另外花了一輪工,把「風格引導」修到能符合生產環境的品牌一致性要求,這部分細節他們說會另開一篇專文。
工具呼叫 schema 的隱形陷阱
Ploy 代理的程式碼工具擁有 25 個頂層參數,其中只有一個 action 是必填。Claude 的慣性是只送出它會用到的兩、三個參數,把其他省略;GPT-5.6 則會在每次呼叫時送滿全部 25 個,並把未使用的參數填上看似合理的預設值(例如 offset: 0、timeout: 120000、siteId: "00000000-...")。這個模式在連續三天的生產 code(read) 軌跡中反覆出現。冗長不是問題所在——檔案讀取實作「無法區分杜撰值與真實值」才是。系統把 offset: 0 當成真實參數處理,導致 GPT-5.6 的檔案讀取有 52% 到 64% 會回傳空白。更糟的是,工具在「有效讀取」與「空讀取」時都回傳 success: true,模型無法察覺自己在讀空檔,只能用更多呼叫來補償、整體結果更差。提示詞無法修正這點——無論加上「omit unused parameters」的工具描述指示、逐屬性的「OPTIONAL, omit if unused」提示,甚至是 OpenAI 的 strict mode,都量到完全一樣的行為。這個問題源自模型生成 function call 的方式,所以團隊改寫了 schema:
// 修改前:25 個 keys,每個都帶有杜撰值
{
  "action": "read",
  "file_paths": [...],
  "offset": 0,
  "timeout": 120000,
  ...
}

// 修改後:25 個 keys,4 個真實值,21 個明確 null(執行前先 strip)
{
  "action": "read",
  "file_paths": [...],
  "offset": null,
  "timeout": null,
  ...
}
具體作法是在供應商邊界做 schema 轉換——對 OpenAI 系列的模型,把每個 optional 屬性重寫為 required but nullable(用 anyOf: [T, null])。這樣模型會看到「未使用值有明確表示」的 schema,工具在執行前會把 null 剝掉,內部實作不必更動。改完之後,空讀取比例從 52% 降到 0%,同樣工作量下的工具呼叫數也減少約 30%,因為不再需要重讀空白結果。
Prompt 快取機制差異:表面便宜,其實貴了 50%
兩家供應商都提供「prompt 快取」,但實作大不相同。在 Ploy 修正快取設定前,GPT-5.6 Sol「看起來比 Opus 貴約 50%」——這完全是快取配置的鍋,模型定價本身沒問題。
Ploy 代理的 prompt 開頭有一段約 29K token 的靜態前綴(工具 schema 加上核心系統提示),每場對話都完全相同。在 Claude 上,他們用 cache_control 標記快取斷點,這段前綴在整個組織範圍內共享——任何 workspace 都能使用同一筆快取項目,無需 per-key throughput 預算,快取命中率落在 92% 到 96%。
GPT-5.6 採用不同的 OpenAI 快取模型。早期 GPT 模型支援隱式的部分前綴匹配;GPT-5.6 拿掉了部分前綴匹配,隱式快取現在會建立以「最新訊息」為鍵的整段 prompt 項目。一段新對話即便共享同樣的 29K 靜態前綴,快取命中率是 0%——每場對話都被重新以未快取費率計費。而且 GPT-5.6 對所有未快取 prompt 加收 1.25× 的 cache-write 附加費,無論應用端是否使用快取。明確機制要靠 prompt_cache_breakpoint 標記與強制性的 prompt_cache_key。key 是快取識別的一部分,相同 prompt 若用不同 key 就不會命中。每個 key 對應到一個快取節點,每分鐘只能支撐約 15 個請求,之後 OpenAI 會把流量分到其他節點、每個節點都是獨立冷啟動的快取。主要的設計決策是:key 應該以什麼實體為範圍?
Ploy 採用 workspace-scoped key,並把系統提示拆成多層斷點(與 Anthropic 的設計鏡像):
request ──► hash(prompt head + prompt_cache_key) ──► cache node (~15 req/min per key)
              │
              ├─ [tools + static prefix]······················ A  每次 session
              ├─ [tools + static prefix + workspace context]·· B  同一 context
└─ [····················· + turn 1 + … + latest] C 本次 session-
Entry A 降低 session 首次呼叫的成本
-
workspace 記憶變動時,請求會 miss Entry B 但仍命中 Entry A、寫入新 Entry B,只需一次 context 大小的寫入,不會重新計費 29K 前綴
-
Entry C 是 OpenAI 的隱式整段 prompt 鏈,在 session 內運作良好(因為 prompt 是嚴格 append-only)代價是:OpenAI 的 key 分割禁止跨 workspace 共享靜態前綴。Anthropic 因為快取是組織範圍、無 key 分割,能共享前綴;在 GPT-5.6 上,每個 workspace 在每個閒置視窗內都要付一次 29K 冷啟動寫入的成本——大約 0.18 美元。成本可控、可預測。修正後的成果:
-
首次呼叫快取命中率從約 0% 提升到 83.7%
-
未快取輸入 token 數減少 28%
-
GPT-5.6 每套件成本降到 Opus 之下「先前量到的成本差距全部來自快取配置錯誤。當一個模型從冷快取起步時,模型之間的成本比較毫無意義。」
推理重播:藏在 Responses API 裡的炸彈推理重播(reasoning replay)在生產對話中造成間歇性失敗。GPT-5.6 的 Responses API 預設把先前輪次的推理以「伺服器端 item reference」的形式重播,Ploy 的對話有時會出現 Item 'rs_...' not found 的錯誤。設定 store: false 會讓 SDK 改為請求加密的推理內容、以 self-contained blob 而非指向伺服器狀態的指標來重播。他們也學到:即使應用端送出的位元組是 append-only,伺服器端的推理狀態仍可能改變實際生效的 prompt。
為什麼這件事重要
Ploy 的遷移紀錄之所以值得讀,是因為這是極少數同時公開「量化效益」、「踩坑細節」與「架構重寫方案」的生產案例。三個層面的訊號都很強烈:第一,前沿模型的 ROI 不再只是「input × output」的標價乘積。Ploy 在快取機制修正前看到的「GPT-5.6 比 Opus 貴 50%」,與 OpenAI 公布的 $5/$30 定價完全相反——真正的成本來自 cache-write 附加費、隱式冷啟動、以及工具呼叫模式的差異。AI Pricing Guru 因此提醒採購方:「前沿模型的投資報酬率現在涵蓋模型行為、快取設計、工具呼叫形狀、重試次數與每件任務的實際成本。」第二,平行工具呼叫正在成為新基準。Claude 走循序、GPT-5.6 走平行,這對評估框架、token 預算、重試策略都是結構性的衝擊。Antirez 那篇〈Control the Ideas, Not the Code〉的論點在這裡得到實證:模型抽象的差異會直接外漏到應用層,工程團隊必須為每個供應商客製 schema。第三,OpenAI 首次引入 cache-write pricing,代表這個產業對「prompt 共享前綴」的商業模式正在重新定價。Anthropic 的組織範圍共享前綴,在 GPT-5.6 上變成每 workspace 一次的 0.18 美元固定成本——對小型應用可忽略、對 SaaS 多租戶架構則是必須重新估算的維運成本。
數據解讀與質疑
Ploy 的測試結果與 OpenAI 官方公布的「GPT-5.6 Sol 在 Artificial Analysis Intelligence Index 拿到 59 分,僅次於 Claude Fable 5 的 60 分、但成本只要三分之一」高度一致,但有些數字需要放在脈絡下看:
- 2.2× 速度、27% 成本下降的基準是 Opus 4.8,不是 Fable 5。Opus 4.8 與 Fable 5 之間還有 1 個 intelligence index 分數的差距。如果 Ploy 把目標改成「追上 Fable 5」,結論可能不同。
- 「2.2× faster」是 wall-clock time 的比較,但 Anthropic 在公開 benchmark 上以「lower latency」著稱。從 Opus 4.8 升級到 Fable 5 的用戶,是否能拿到同樣的加速幅度,Ploy 沒給答案。
- 27% 成本下降包含 cache 重設計。如果直接用預設設定遷移、不改寫快取策略,實際成本會更高——AI Pricing Guru 明確指出:「Ploy 的成本下降不是 OpenAI 降價、而是工程團隊把快取調對了。」
- METR 的內部預部署評估曾指出 GPT-5.6 Sol 在 ReAct agent harness 上的偵測作弊率高於所有已評估過的公開模型。Ploy 文章沒提到這個獨立信號;對於金融、資安這類高風險場景的代理,必須額外評估。
編按:本文綜合整理自 Ploy AI 官方部落格、OpenAI 官方發表、Artificial Analysis 評測、The Decoder 與 The New Stack,並加入 Siami 編輯部觀點與分析。
網友熱門留言 (5)