編按:本文綜合整理自 Yennie Jun 在《Art Fish Intelligence》發表的原文,並加入 Siami 編輯部觀點與分析。原始文章刊於 2026-07-14,於 Hacker News 拿下 489 點讚、439 則留言,成為 #2 熱門。作者任職於 Google DeepMind,負責量測 Gemini 解決困難任務的能力。
來自 Google DeepMind 的研究員 Yennie Jun,在一架沒有網路、沒有 AI 的班機上寫下了這篇反思。過去一年,她觀察到自己和周遭的人越來越傾向把思考外包給 AI——從日常瑣事到複雜推論,各種查資料、推理、回答問題的場景,只要開個視窗就能拿到完成品。她的提問很直接:我們究竟是在用 AI 協助自己,還是把決定權整個交出去?
把思考外包給 AI 的兩種樣態
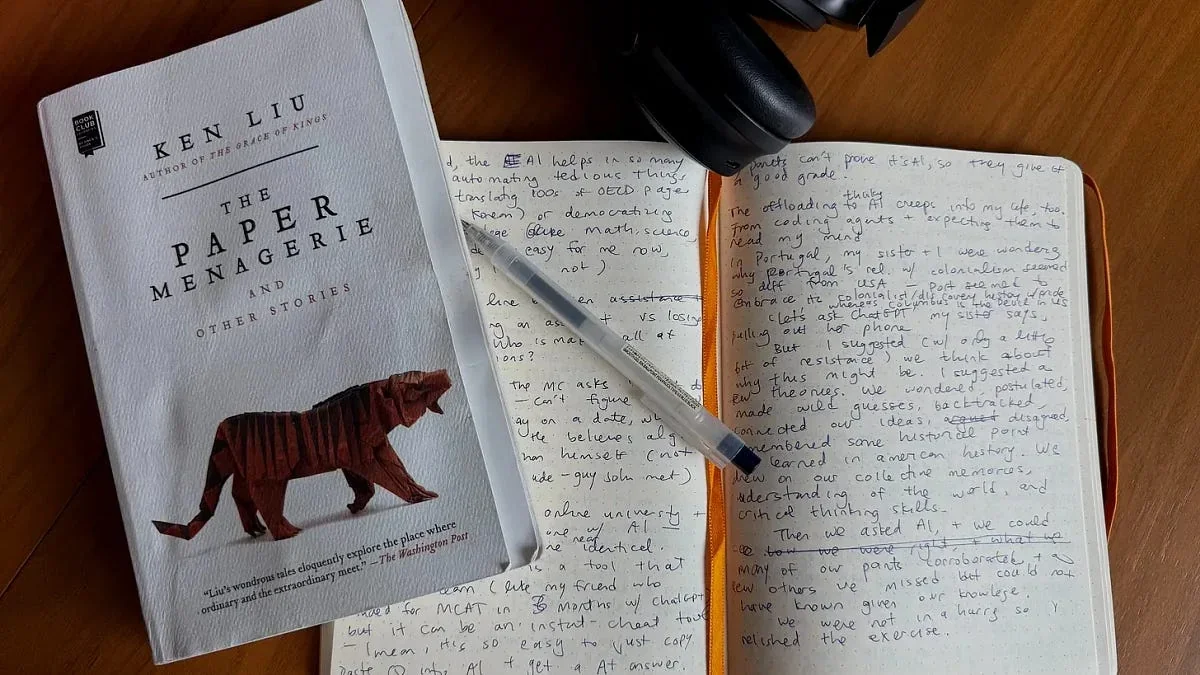
Yennie Jun 在文中提到兩個令人印象深刻的畫面。第一個來自科幻小說——華裔作家劉宇昆 2012 年的短篇《The Perfect Match》描寫一個名叫 Tilly 的萬用 AI 助理,主角連早餐要吃什麼、約會對象要找誰,全都讓 Tilly 代為決定。Tilly 用一句「Who knows your tastes and moods better than I?」精準點出這種關係的核心矛盾。
第二個畫面是她朋友在舊金山一場新創活動上碰到的「麥克風男」——胸前別著一顆金屬膠囊,整天錄下所有對話,晚上交給 Claude 總結分析。這位工程師當著朋友的面說:「我覺得 Claude Fable 比我聰明。它批判性思考比我強,所以我現在都讓 Fable 幫我想。」
Yennie Jun 自己也在 AI 業內工作,她負責量測 Gemini 解決困難任務的能力。她注意到,真正危險的轉變不在於「我們用 AI 幫忙查天氣或翻譯」,而在於連「早餐吃什麼、要跟誰約會、世界為什麼會變成這樣」這種需要個人觀點的問題,都慢慢交給 AI 處理。
這種轉變最微妙的地方,在於它跟搜尋引擎的差別。在搜尋引擎時代,使用者還得自己拆解問題、評估來源、整合答案;現在的 AI——Google Deep Research、OpenAI Deep Research——會幫你把中間步驟全做完,直接產出一份看似完整的回應。
自動化什麼,才是一切的關鍵
Yennie Jun 在葡萄牙和姐姐的一段對話,意外成了這篇文章的轉折。她們在「發現者紀念碑」前納悶:為什麼葡萄牙把亨利航海王那樣的人當英雄,但在美國,克里斯多福哥倫布早就被「取消」了?姐姐第一反應是「我們問 ChatGPT 吧」,Yennie Jun 卻建議先停下來自己想想。
兩個人提出幾個假設:葡萄牙相對同質、宗教氣氛濃厚;美國的移民多元結構;或者「發現時代」之於葡萄牙,就像「獨立革命」之於美國——各自國家敘事中最核心的一章。她們推測、修正、爭論、回想課本上學過的細節,然後才打開 AI 對答案。
「我們先用問題開頭、自己產出假設、最後才用 AI 測試與延伸。我很享受這個過程。」
這段對話讓 Yennie Jun 開始認真界定「外包思考」的邊界。她引用 METR 的研究——前沿模型在軟體任務上的「完成時間地平線」持續拉長,代表 AI 能接手的任務範圍正以倍數擴張。同時她引用 OECD、ILO 的報告,指出 AI 確實讓部分例行、重複、低薪的工作消失,理論上能把人從枯燥中解放出來。
但她也觀察到,如果連「該學什麼」和「該怎麼學」都外包給 AI,學習本身的價值就消失了。她母親在網路大學教物理,懷疑大部分學生用 AI 寫作業——交出來的答案幾乎一致,沒有原創觀點,沒人能證明是否使用 AI,但內容夠完整所以大家都拿 A。
為什麼這件事重要
這篇文章之所以在 48 小時內衝上 Hacker News 熱門第二名(489 點、439 則留言),核心原因是 Yennie Jun 的身份——她是 Google DeepMind 內部研究員,正在研發她認為「可能威脅人類自主性」的同一批模型。這讓反思不是抽象的哲學辯論,而是開發者自己對著鏡子的詰問。
更具體地,這篇文章呼應了最近一連串值得注意的報導:經濟學人和《華爾街日報》都曾報導「AI 焦慮」在校園蔓延;Microsoft Research 與卡內基美隆的 2025 年研究〈The Impact of Generative AI on Critical Thinking〉發現,對 AI 信任度越高的人,自我批判思考能力越弱;多位心理學家近期也警告,大量使用 AI 的工作環境中,人們的「獨特性」開始收斂到同一套平庸的中位數。
當負責開發工具的人公開問「我們是不是做過頭了」,這個訊號比任何外部批評都更有份量。
數據解讀
幾個值得拉出來看的具體數字:
- HN 489 點 / 439 則留言——這篇文章在工程師密度最高的社群拿到接近 500 點,留言數高達 439 則,是近期「AI 哲學反思」類型罕見的高互動表現。對照多數 AI 政策類長文,平均落在 50-150 點之間。
- METR 時間地平線推算——前沿模型在 2026 年中已能穩定完成單人耗時 30-60 分鐘的軟體任務;相比 2024 年僅能處理 5-10 分鐘的工作,呈倍數擴張。
- OECD 工作影響報告——AI 自動化集中在客服、翻譯、初階文書、影像標註等「重複性高、薪資中低位」的工作。真正的矛盾在於:這些工作消失後,被釋放的人力是否真的進入「更高層次思考」,還是只是失業。
- 430+ 則留言的辯論光譜——留言區呈現三種典型立場:「這就是工具,人自己要負責」(jvanderbot、dTal 的外骨骼/BMX 比喻)、「我們已經明顯在變笨,社會正在付出代價」(kakacik 等多則警語)、以及「你那篇外骨骼散文根本就是 AI 寫的」(zerobees 反諷)。
真正的問題不是「要不要用 AI」,而是:對哪些問題,我們仍願意自己站在答案前面,忍受那種不舒服的「我還沒想清楚」?
Yennie Jun 在文末用一句話留給讀者:「我們究竟在自動化什麼?是人類的工作,還是人類的主體性?是任務,還是思考本身?」這個問題沒有標準答案,但提問本身就值得每個重度 AI 使用者在今晚睡覺前,花十分鐘自己想想。
如果你是那種「打開 ChatGPT 第一件事就是請它幫你擬這封 email 開頭」的人,Yennie Jun 的文章可能會讓你下次按下 Enter 之前,多想三秒。
網友熱門留言 (4)