編按:本文綜合整理自 Isomorphic Labs 官方技術文章、IsoDDE 技術報告、IEEE Spectrum 訪談、Nature 研究 與 bioRxiv 基準研究,並加入 Siami 編輯部觀點與分析。
Isomorphic Labs 在 2026 年 2 月公布新一代藥物設計系統 IsoDDE(Isomorphic Labs Drug Design Engine),把 Google DeepMind 以 AlphaFold 系列建立的蛋白質結構預測,往「找出可以下藥的位置、評估分子怎麼結合」的方向推進。這不是把 AlphaFold 3 換個名字,而是試圖把結構預測、結合口袋辨識與結合親和力預測,整合在同一套計算系統裡。
這項消息近期再次登上 Hacker News,主因是官方技術文章把幾個數字講得很醒目:IsoDDE 在測試陌生蛋白質—配體組合的 Runs N’ Poses 基準中,最困難的泛化區段,準確度超過 AlphaFold 3 一倍;在低同源性的抗體—抗原測試集上,高保真預測比例是 AlphaFold 3 的 2.3 倍、Boltz-2 的 19.8 倍。這些數字代表的是特定基準與特定評分條件,不是所有藥物研發任務都全面提升相同幅度。
IsoDDE 到底多做了什麼?
AlphaFold 3 已經能同時處理蛋白質、核酸、小分子與其他生物分子之間的互動,但過去研究指出,當測試對象和訓練資料差異很大時,模型的蛋白質—配體預測能力會下降。對藥物研發來說,真正有價值的往往正是那些尚未被充分研究、沒有現成結構模板的新目標。
Isomorphic Labs 公布的 IsoDDE 能力,主要可以分成三層:
- 結構預測:判斷蛋白質與小分子、抗體或其他分子如何形成空間互動。
- 口袋辨識:只給蛋白質的胺基酸序列,也嘗試找出可能容納藥物的已知或隱藏結合位置。
- 親和力預測:估計候選分子與目標蛋白結合得有多強,協助研究人員排序與優化分子。
官方也在 FEP+ 4、OpenFE 與 CASP16 盲測等公開基準上報告優勢,並稱其結合親和力預測在部分測試中超過傳統物理方法。這個方向的意義在於,研究團隊不必先為每個候選分子製作完整實驗結構,便能先用計算方法縮小搜尋範圍。
一個隱藏口袋如何改變藥物搜尋?
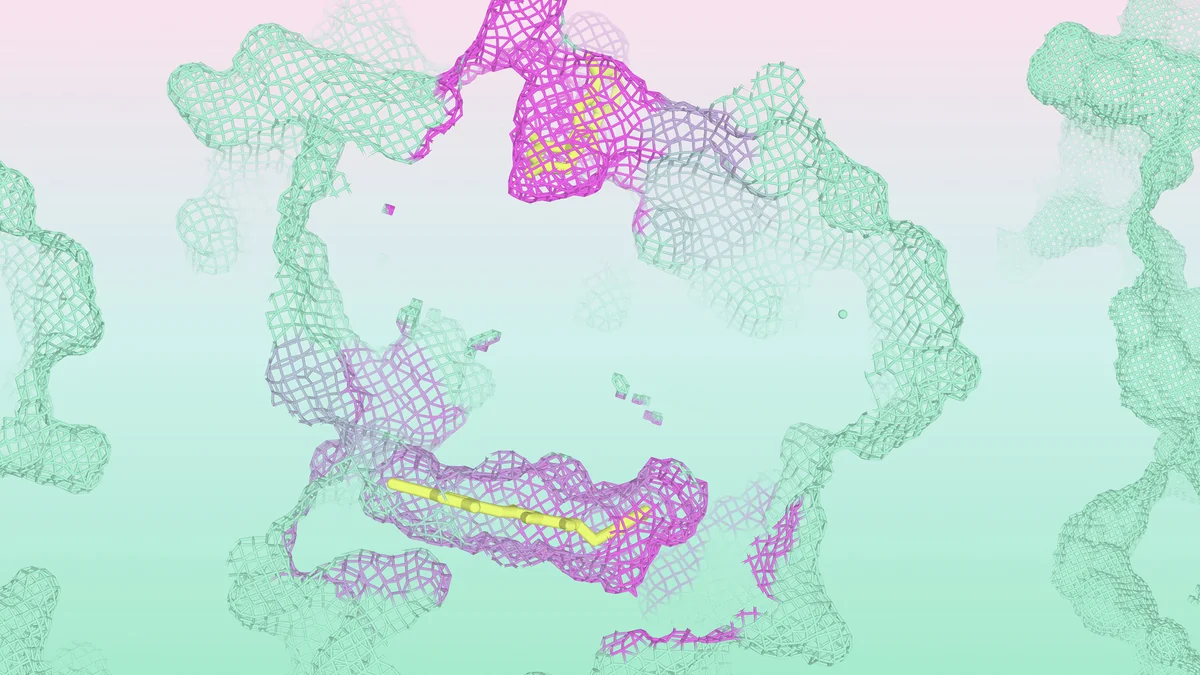
官方團隊選用 cereblon 作為示範案例。cereblon 是 CRL4 E3 泛素連接酶複合體的一部分,和細胞標記、清除受損或錯誤折疊蛋白質的機制有關,也長期是沙利度胺及其衍生藥物研究的重要目標。
2026 年 Nature 研究描述了 cereblon 上一個新的變構結合位置。這個口袋在蛋白質沒有配體時並不明顯,必須在適當分子接近後才會呈現,因此被稱為隱藏口袋。Isomorphic Labs 表示,IsoDDE 只使用 cereblon 的胺基酸序列,就找到了已知口袋與這個新口袋的位置;在指定配體之後,系統也預測出分子進入兩個口袋的方向。
這種能力如果能在更多蛋白質上重現,可能讓「沒有明顯可下藥位置」的疾病目標重新進入研究範圍。它不只是找到一個漂亮的三維圖,而是協助科學家提出可供合成、測試與後續優化的候選機制。
數據解讀:倍數很大,不代表藥已經成功
官方的比較數據值得注意,但也必須先看清楚測試設計。Runs N’ Poses 是用來檢驗模型能否泛化到新蛋白質—配體系統的基準,最困難區段特別強調「和訓練資料不相似」的案例;抗體—抗原數據則使用 DockQ 大於 0.8 的高保真門檻。2.3 倍與 19.8 倍是在這些條件下得到的相對結果,不等於臨床成功率增加相同倍數。
更關鍵的是,IsoDDE 的技術報告主要公開能力與基準結果,沒有把完整模型架構、訓練資料與所有工程細節完全公開。Hacker News 討論串的讀者因此提出兩個合理疑問:公眾目前不能直接試用這個模型,而且文章公布時尚未經過同儕審查期刊驗證。這不會自動否定結果,但表示外部研究團隊仍需要取得資料、重跑測試,才能判斷結果能否在不同設定下重現。
bioRxiv 的 Runs N’ Poses 研究也提醒,蛋白質—配體模型可能記住訓練資料中的姿勢,導致模型在真正陌生的化學空間表現下滑。換句話說,能在一組時間切分或泛化基準上表現良好,是重要進展,卻仍不是「已經解決新藥設計」的證明。
為什麼這件事重要?
藥物研發最耗時的部分,往往不是把一個漂亮的分子畫在電腦上,而是確認它是否真的能在複雜生物環境中,以正確方式作用於目標,並且同時具備足夠安全性、穩定性與可製造性。IsoDDE 的價值,若後續研究能確認,會在於把早期搜尋從「大量嘗試再逐一淘汰」推向「先找更可能成功的結合機制,再安排實驗驗證」。
這也解釋了為什麼 Isomorphic Labs 在 2026 年 5 月宣布取得 21 億美元 B 輪融資,並與 Johnson & Johnson 等藥廠展開合作。資金和合作不代表候選藥物已經通過臨床,而是反映產業願意為計算設計、實驗平台與候選管線投入更大規模的資源。對台灣與華文讀者而言,這不只是「又一個 AI 模型打敗舊模型」的新聞;它牽涉生技公司的資料壁壘、醫藥專利、算力成本,以及未來藥物發現的工作流程會由哪些團隊掌握。
真正值得觀察的是,IsoDDE 能否把基準分數轉成可重複的實驗結果,再轉成通過人體試驗的候選藥物。如果計算模型只能在公開基準上漂亮,卻不能穩定預測細胞與人體中的結果,商業價值就會被打折;反過來,若它能在幾個治療領域持續縮短候選篩選週期,影響才會超越 AlphaFold 時代的結構資料庫。
接下來看什麼?
Isomorphic Labs 已經把 IsoDDE 描述成每天用於公司內部藥物設計計畫的系統,但目前公開資訊仍以技術報告、公司說明與訪談為主。後續至少有三件事值得追蹤:
- 是否有獨立團隊在 Runs N’ Poses、抗體—抗原與親和力基準上重現結果。
- 公司是否公開更多模型架構、資料切分與失敗案例,讓外界能判斷泛化能力而不是只看最佳數字。
- 由 IsoDDE 協助設計的候選藥物,能否從計算預測進入臨床試驗並產生安全、有效的結果。
目前較準確的結論是:IsoDDE 顯示 AI 藥物設計正從單純預測分子結構,走向同時處理結構、口袋與結合強度的整合系統;但它仍是藥物研發流程中的計算工具,不是取代實驗室、毒理測試與臨床試驗的捷徑。
延伸閱讀:IsoDDE 技術報告|IEEE Spectrum 專訪|Nature:cereblon 新變構口袋|Runs N’ Poses 基準研究
網友熱門留言 (4)