編按:本文綜合整理自 Stephen Bochinski 部落格原文、Tom’s Hardware、VentureBeat、Simon Willison 的實測 及 Hacker News 討論串,並加入 Siami 編輯部觀點與分析。
中國 AI 新創 Moonshot AI 在 2026 年 7 月 16 日悄悄投下一顆震撼彈:開源旗艦模型 Kimi K3。這是一個 2.8 兆參數的 Mixture-of-Experts 模型,支援 100 萬 token 上下文,API 價格壓到每百萬輸入 3 美元、輸出 15 美元——比 Claude Fable 5 同樣單位的 10 美元、50 美元便宜了 3 倍以上。當美國政府試圖用 AI 出口管制保護本土模型時,這家中國實驗室卻把一個「準前線級」模型擺上全球開發者的桌面,連權重都預計在 7 月 27 日公開下載。
開發者實測:跟 Claude 已經分不出來
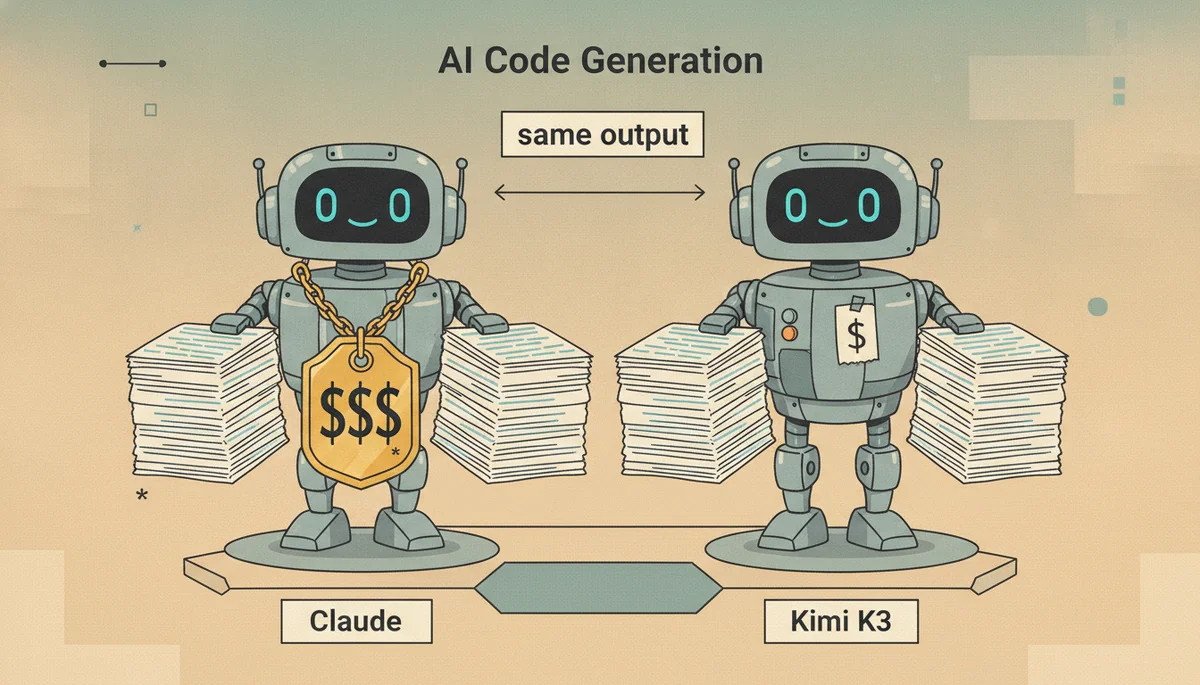
軟體工程師 Stephen Bochinski 在部落格上寫下他這兩週的實測心得:他同時用 Kimi K3 與 Claude 跑日常編程任務,結論是「在實務上我分不出來」。同一份任務、同樣品質的輸出,token 消耗也幾乎一致。
我原本以為開放權重模型會更粗糙,或是要花更多 token 才能拿到同樣答案,但兩件事都沒發生。
他進一步比較商業方案:Kimi 的付費方案從月費 19 美元起跳,39 美元的編程方案給的額度比 Claude 任何同價位都大方;Claude 的 20 美元方案不只要嚴格計 token,連 Fable 模型都會被靜悄悄切換成 Opus——等於你買的是一個隨時會被換掉的招牌模型。
這段體驗正好對應 Simon Willison 在 7 月 16 日的獨立實測:他向 Kimi K3 送一個簡單的「hi」訊息,API 回報消耗 86 個 token,代表裡面藏了大約 85 token 的隱藏 system prompt,且模型拒絕洩漏內容。對熟悉封閉模型生態的人來說,這個數字本身就是一種信號:Moonshot 願意為品質在 system prompt 上砸資源,而不是把成本轉嫁給用戶。
為什麼這件事重要
表面上是「便宜版 Claude」的故事,但深一層看,Kimi K3 真正的衝擊在於美國 AI 出口管制策略的破功。
美國政府拖住了 Anthropic,但真正出貨的是一個被閹割的版本,連某些工作類別都拒絕執行;同一時間,一個沒有任何限制的前線品質模型,只要下載就能用,還是由一家美國政府根本管不到的北京實驗室發布的。
Bochinski 點出了這個矛盾:當管制變成只擋美國客戶、不擋外國開發者時,等於是美國企業付最高價、拿最受限的模型;而中國與其他國家則能拿到更便宜、更自由的開源權重作為替代。Semgrep 6 月的內部資安基準測試已經印證這個落差——GLM-5.2(智譜 AI/Z.ai 的 753B MoE 模型)以 MIT 授權釋出,在 IDOR 漏洞偵測上拿到 39% F1,擊敗 Claude Code 的 32–37%,成本卻只要六分之一。
- Kimi K3 在 Arena WebDev 排行榜以 1679 分拿下第一
- 在 LiveBench 排第 7(77.9 分)、benchlm.ai 整體排第 4(80.96 分)
- 開放權重預計 7 月 27 日釋出——若屬實,將是史上最大的開源模型
這不只是商業競爭,是地緣結構的位移。當一個開源模型在品質與價格同時壓過最貴的西方對手,「管制保護」這張牌就只剩政治意義,沒有經濟意義。
數據解讀:便宜得不合理嗎
Bochinski 列出來的 API 報價值得再拆解一次:
| 模型 | 輸入 (USD/M) | 輸出 (USD/M) |
|---|---|---|
| Kimi K3 | $3 | $15 |
| Claude Fable 5 | $10 | $50 |
對純文字任務來說,這是 3.3 倍的成本差距;對含長脈絡的研究型應用,差距會更明顯——因為 K3 的 1M context 完全不另外加價。Kimi 編程方案的 39 美元/月,在 Claude 端只能買到「被閹過的 Opus」。當一個模型在程式碼品質、長脈絡、商業方案三條線同時碾壓對手,單純用「中國補貼」解釋就太敷衍了。
更值得注意的是 GLM-5.2 在 Semgrep 的 IDOR 測試上擊敗 Claude Code 整整一個世代的成本差距:
- GLM-5.2 F1:39%
- Claude Code F1:32–37%(不同版本)
- 單一漏洞成本:GLM-5.2 約 $0.17,Claude Code 約 $1.00+
這不是行銷話術,是資安研究團隊實測的數字。當弱點偵測的成本與品質同時倒向開源模型,企業內部的 AI 採購邏輯必須重寫——否則就是用 5 倍的錢買次級的結果。
美國 AI 政策的下一步:會重演汽車業劇本嗎
Bochinski 對美國政府的下一步有個冷靜的預測:會拿汽車業的劇本來套 AI。
數十年的補貼、紓困、保護性關稅,造就了只能在國內賣卡車、在海外幾乎不見人影的美國車廠。我預期現在的執政團隊會對 AI 採取同樣手段:公私合夥撐起只能在美國內部使用的國產模型,根本沒有國際競爭力。
這個劇本已經有一個早期徵兆:Anthropic 的 Claude Fable 被政府擋下、出貨時已經是被限制的版本;而 OpenAI 的 GPT-5.6 雖然也被推過同樣的政府審查,但最終能在 20 美元方案放上旗艦模型。這代表 OpenAI 有 Anthropic 沒有的「runway」——Anthropic 連續幾輪募資與商業化的壓力,會讓它在「政府合規」與「商業競爭」之間拉扯得更辛苦。
如果這個判斷成真,2027 年的美國 AI 市場會長成這樣:唯一一個買不到最便宜、最強模型的主要市場,還要被迫購買那些與政治綁定、既不是最高品質也不是最便宜的本土版本。這對一個習慣了「美國 AI 等於世界最強」的產業來說,是個非常陌生的未來。
值得關注的訊號
這篇文章表面上是一位工程師的個人選擇,但背後的訊號值得所有 AI 從業者注意:
- 「前線模型」的定義已經改寫——中國實驗室連續兩次(DeepSeek、Kimi K3、GLM-5.2)把品質/價格曲線推到西方巨頭必須重新定價的位置
- 開源不再是「次等替代品」——在資安、程式碼、長脈絡這些領域,開放權重模型已經實質打平甚至超越封閉對手
- 出口管制只擋國內用戶——Bochinski 的結論已經被 Semgrep 的數據驗證,GLM-5.2 在不允許出口的領域反而更強
- Moonshot 不是孤例——這波「中國開源前線模型」是結構性現象,不是單一公司偶發事件
Bochinski 在文末一句話是這篇文章最好的註腳:「在那一天到來之前,我實在想不出繼續付錢給 Claude 的理由。」 當一個認真使用工具的工程師講出這種話,代表市場訊號已經到位——剩下的只是時間問題。
相關閱讀
網友熱門留言 (3)