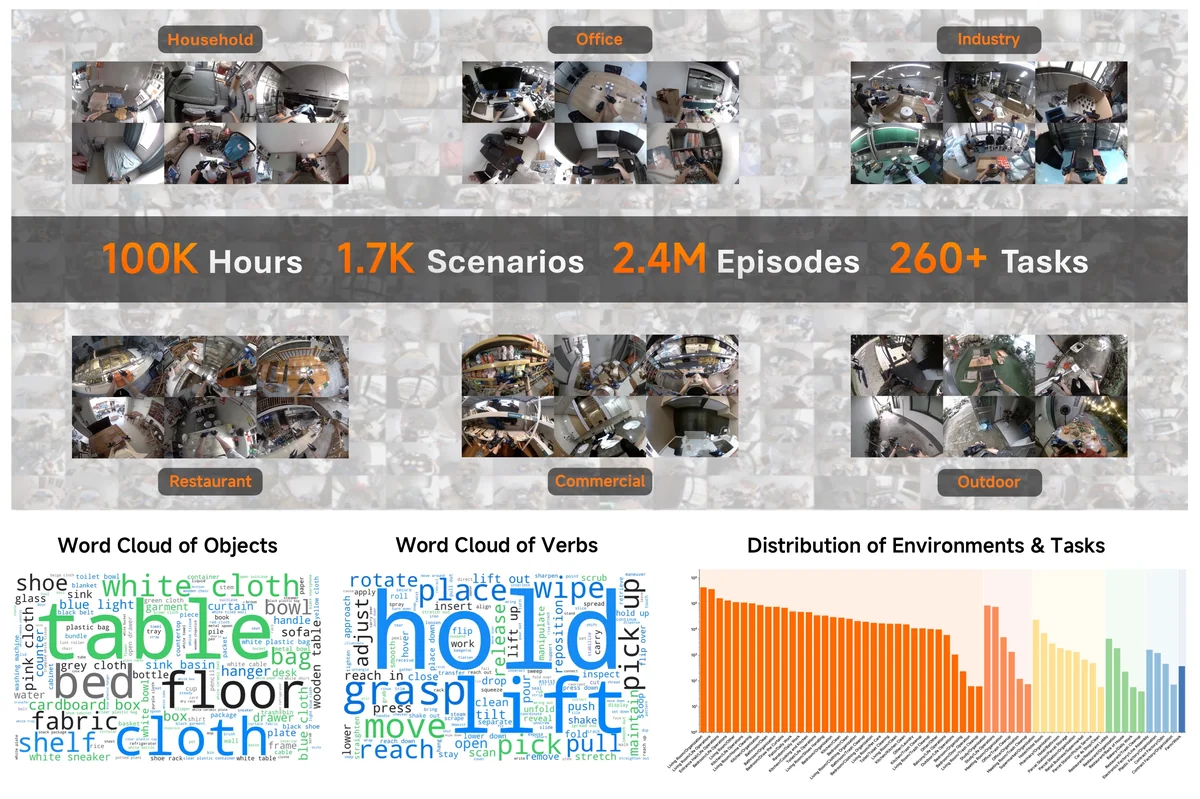
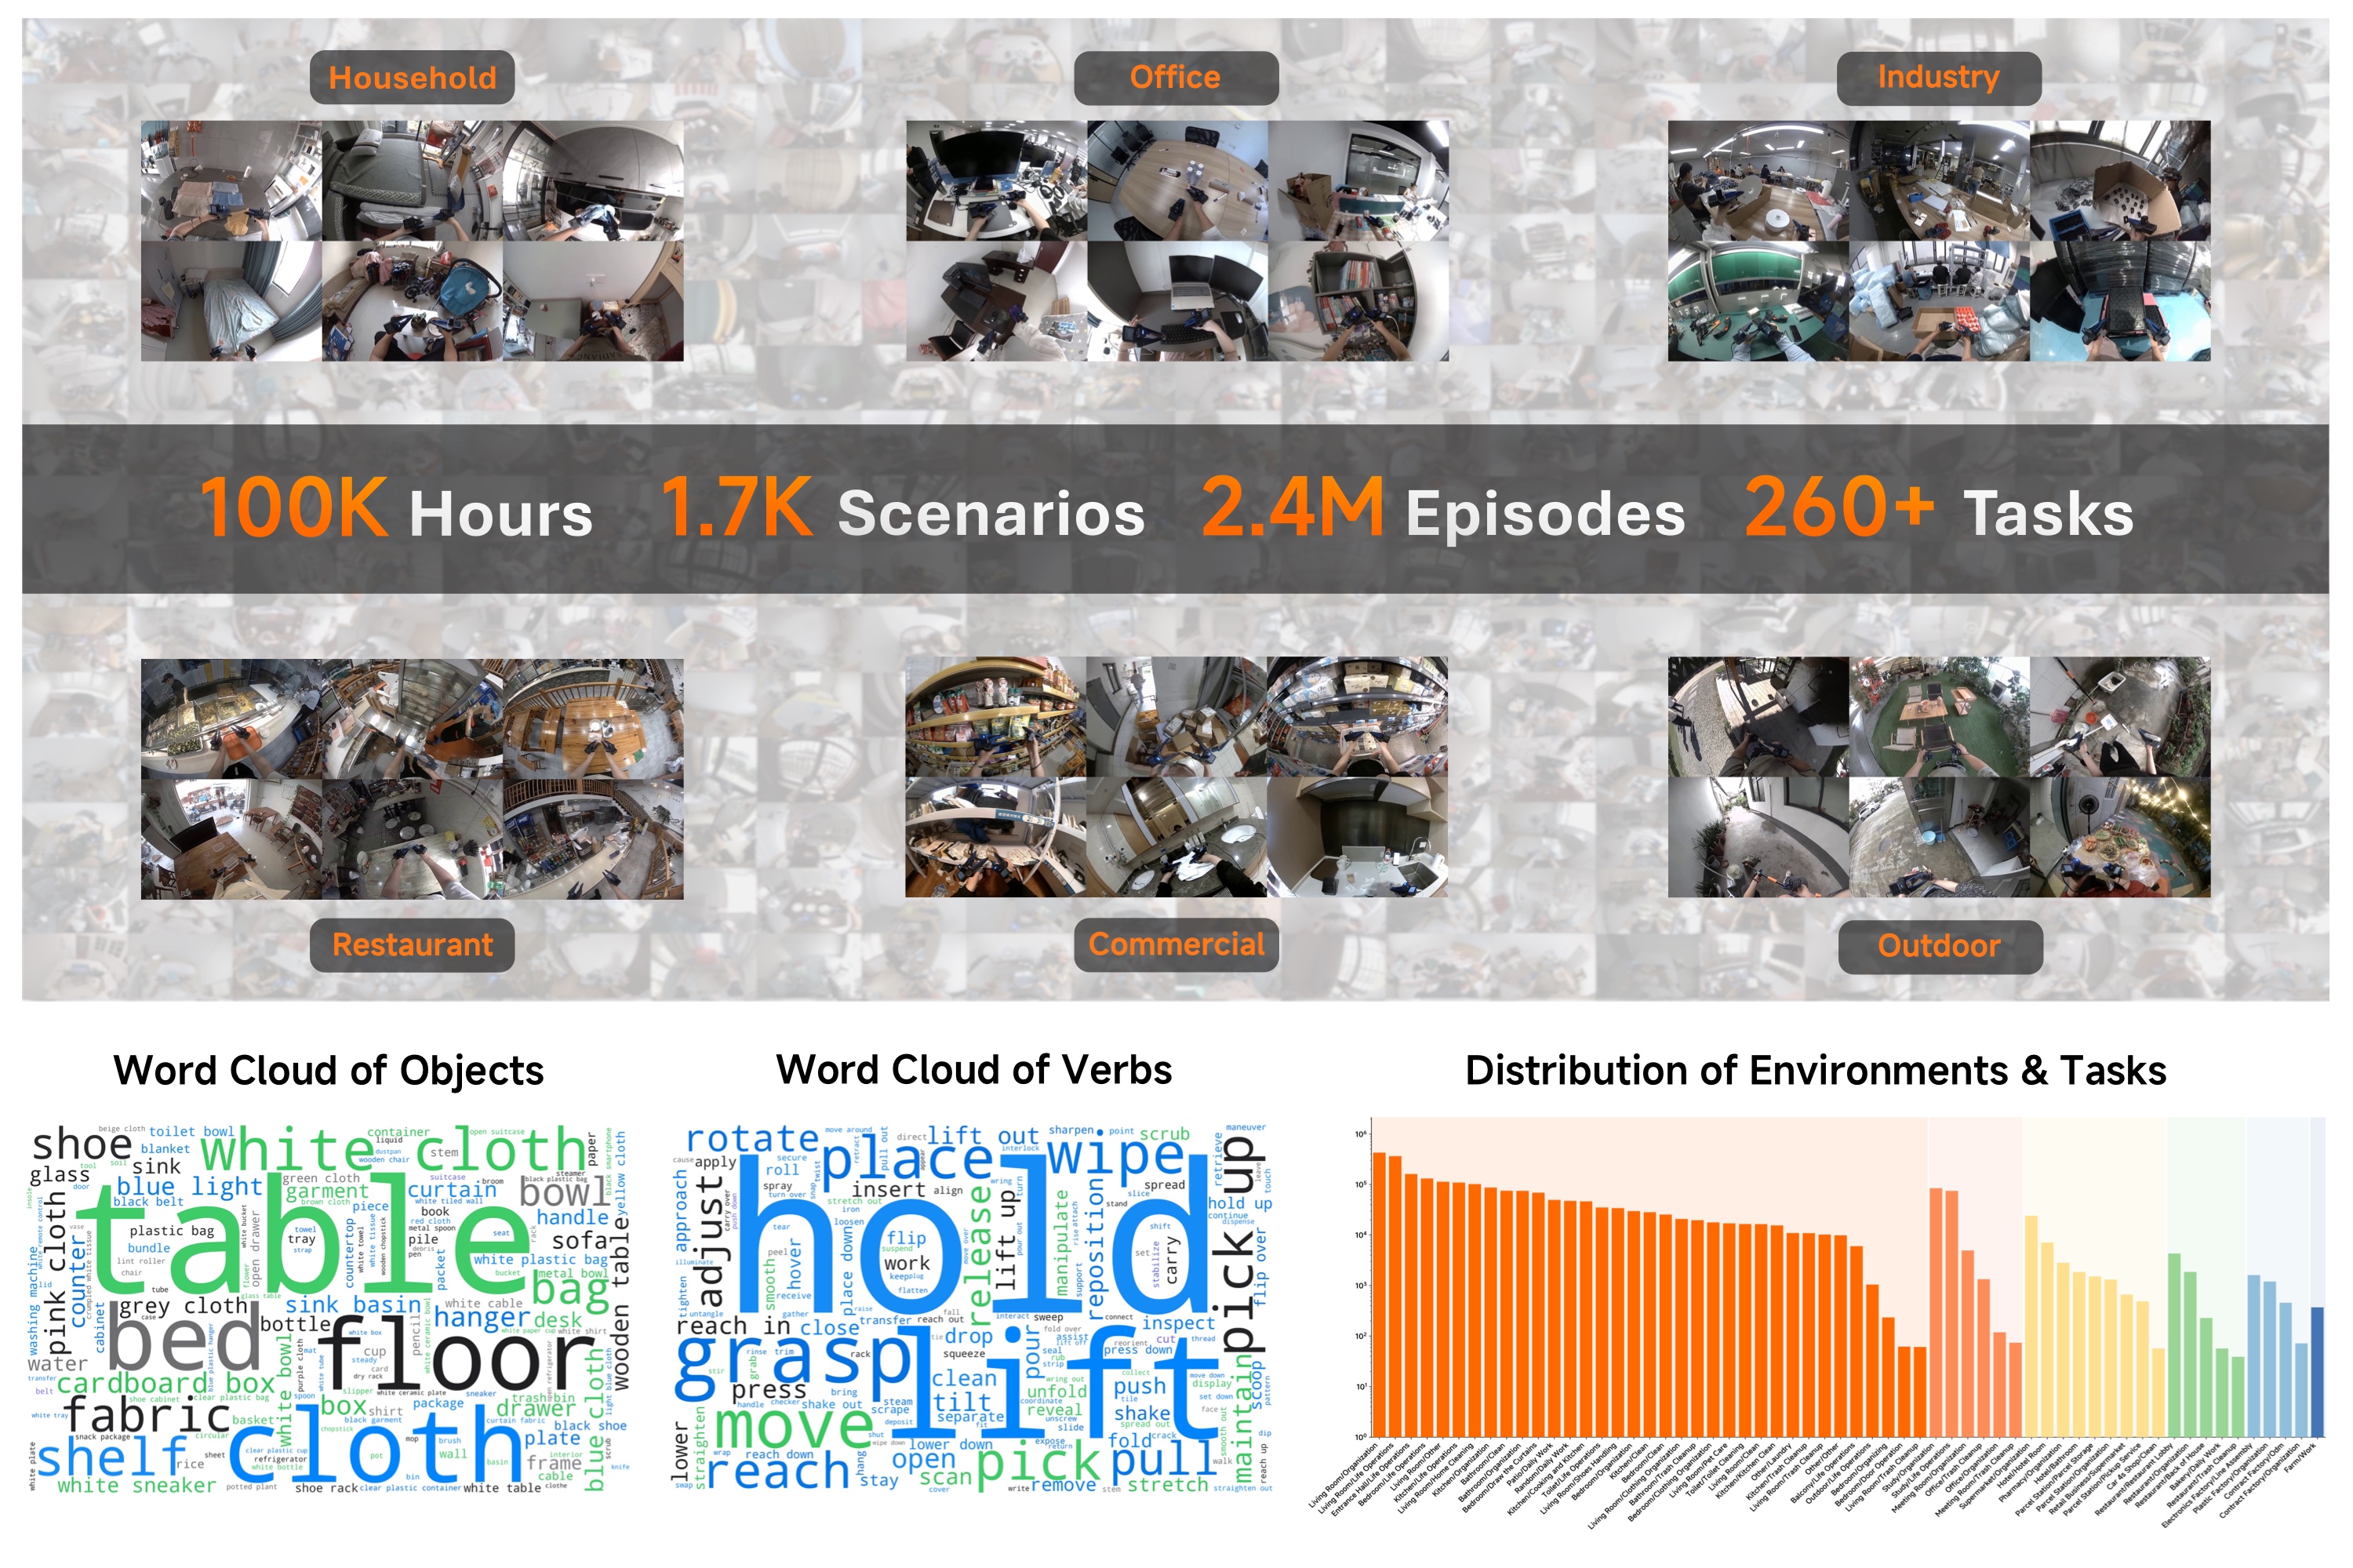
小米機器人實驗室於 2026 年 7 月 16 日釋出 Xiaomi-Robotics-1(XR-1),這是小米第一個可直接部署的機器人基礎模型。研究團隊宣稱,這套模型在超過 10 萬小時的無實體(UMI)操控軌跡上預訓練,並用 7,200 小時的家庭真機資料進行後訓練,在 RoboCasa、RoboCasa365、VLABench 與 RoboDojo 四個主流模擬基準上全面達到 SOTA。
編按:本文綜合整理自 小米機器人官網、小米 XR-1 技術報告(PDF)、Hacker News 討論串,並加入 Siami 編輯部觀點與分析。
模型規模與訓練資料
預訓練階段使用 10 萬小時 UMI(Universal Manipulation Interface)軌跡,分散在 1,700 個以上的真實場景中,包括家庭、商辦、工業現場與戶外空間。為了解決人工標註不切實際的問題,小米建立了一套可擴展的自動標註流水線:先用視覺語言模型(VLM)將長影片切成固定長度的片段,再由模型對每個夾爪與物件的狀態轉換產生語言描述。這讓 10 萬小時的影片可以語意化、結構化地餵進模型。
後訓練階段則使用跨實體資料集,包括:
- 小米內部蒐集的 7,200 小時家庭真機資料(涵蓋整理沙發、分類鞋櫃、收拾廚具等任務)
- 經過篩選的開源機器人資料集
- 高品質 UMI 資料(人工加上時序切段與指令標註)
兩階段訓練與擴展曲線
小米沿用 LLM 的訓練典範,分成預訓練與後訓練兩階段:
- 預訓練:目標是廣度——讓模型在風格各異的真實世界裡看到足夠多的任務,再藉由自動標註的語言描述學習「該產生什麼動作驅動場景到下一個狀態」。
- 後訓練:沿著兩條軸對齊,分別是實體對齊(用跨實體真機資料把通用動作生成能力映射到實體機器人)與指令對齊(讓模型從「看狀態轉換產生動作」變成「讀自然語言指令、直接執行」)。
關鍵發現:預訓練階段表現出整潔的擴展行為——資料量與模型大小增加時,驗證動作誤差穩定下降;後訓練階段同樣繼承這個特性,在未見過的環境與物件實例中,真機成功率隨預訓練規模可預測地持續上升,目前還沒看到飽和跡象。
真機任務與模擬基準表現
在「高效適應新任務」的評估中,XR-1 從平均每項任務 10 小時以內的真機示範,就能讓新手任務平均成功率達到 75%,幾乎是 π0.5 基線(40%)的兩倍;當預算拉到 40 小時以內,平均成功率進一步上升到 85%。涵蓋的任務包括電話包裝、印表機補紙、洗衣機裝載、包裹打包等。
四項模擬基準的全 SOTA 結果:
| 基準 | XR-1 | 第二名 | 相對領先 |
|---|---|---|---|
| RoboCasa | 74.5 | 72.6 | +2.6% |
| RoboCasa365 | 57.4 | 46.6 | +23.2% |
| VLABench | 59.1 | 53.2 | +11.1% |
| RoboDojo | 13.93 | 8.80 | +58.3% |
相對領先的計算方式是 (XR-1 − 第二名) / 第二名。小米也釋出 RoboCasa365 與 RoboDojo 兩個排行榜的最新榜單截圖佐證。對照同時期 Pi 0.5、OpenVLA、RT-2 等對手,XR-1 在「通用視覺語言動作模型(VLA)」這個競賽裡,跨實體、可開箱即用的程度明顯往前推了一段。
為什麼這件事重要
機器人長期被卡在一個瓶頸:真實世界的高品質操作資料太稀缺。現有的 VLA 模型要嘛靠幾千到幾萬小時的遙控操作(成本極高),要嘛在模擬環境裡跑(無法直接落地)。XR-1 用 UMI 這種「手持夾爪搭配相機」的蒐集方式大幅降低成本,10 萬小時的規模也遠超以往任何公開資料集,並證明預訓練真的可以擴展到真機成功率——這正是過去三年機器人領域懸而未決的核心問題。
更深一層的意義是:模型、程式碼、評估結果全部開源(Code 與 Model 連結已放在官方頁 banner),意味著學術界、新創、傳統機器人公司都能在這個基礎上做下游研究——這跟過去封閉式人形機器人 demo 走的是完全相反的路線。對照小米在 2026-02 開源 4.7B 參數的 Robotics-0、2026 中再推 38B 的 Robotics-U0 世界模型,再到這次的 XR-1,「小米機器人三件套」儼然成形。
數據解讀與質疑
- 75% 成功率不是終點:電話包裝 70%、印表機補紙 70%、洗衣 80%、包裹 80%——這是「在不熟悉物件實例」下的小樣本學習,仍離工廠自動化所需的 99.9% 有距離。
- 效率提升來自示範數量,而非模型聰明:平均 10 小時/任務達 75%,這背後累積 7,200 小時的真機資料成本不低;對資源較少的學術團隊來說,重現門檻仍高。
- 模擬不等於現實:RoboDojo 的 13.93 雖然比 8.80 多 58%,但絕對值仍偏低;RoboCasa365 的 57.4 也只比去年最好的模型前進 10 個百分點左右。LBM、OpenVLA 等其他模型若加速擴展,這個 SOTA 的有效期可能只有數月。
- 場景外的泛化尚未驗證:官方影片裡的家庭場景是新奇但熟悉的,未確認雜亂、幼兒、有寵物等干擾下的表現。
參考資料與延伸閱讀
- 官方頁面:Xiaomi-Robotics-1(含影片、PDF、模型下載連結)
- 官方影片:main.mp4(主展示)、sofa.mp4(整理沙發)、kitchen.mp4(廚房任務)、pack_phone.mp4(包裝手機)、printer.mp4(補紙)
- 學術背景:Xiaomi-Robotics-0(VLA 4.7B,arXiv 2602.12684)、Xiaomi-Robotics-U0(世界模型 38B,arXiv 2607.11643)、FastUMI-100K(相關 UMI 資料集)
- 業界回應:Notebookcheck 開源機器人報導、LinkedIn 專業評論、India Today:雷軍工廠影片
- 社群討論:Hacker News(230 點/162 則留言)、@techtechchina X 評論、雷軍(@leijun)X 帳號
網友熱門留言 (6)