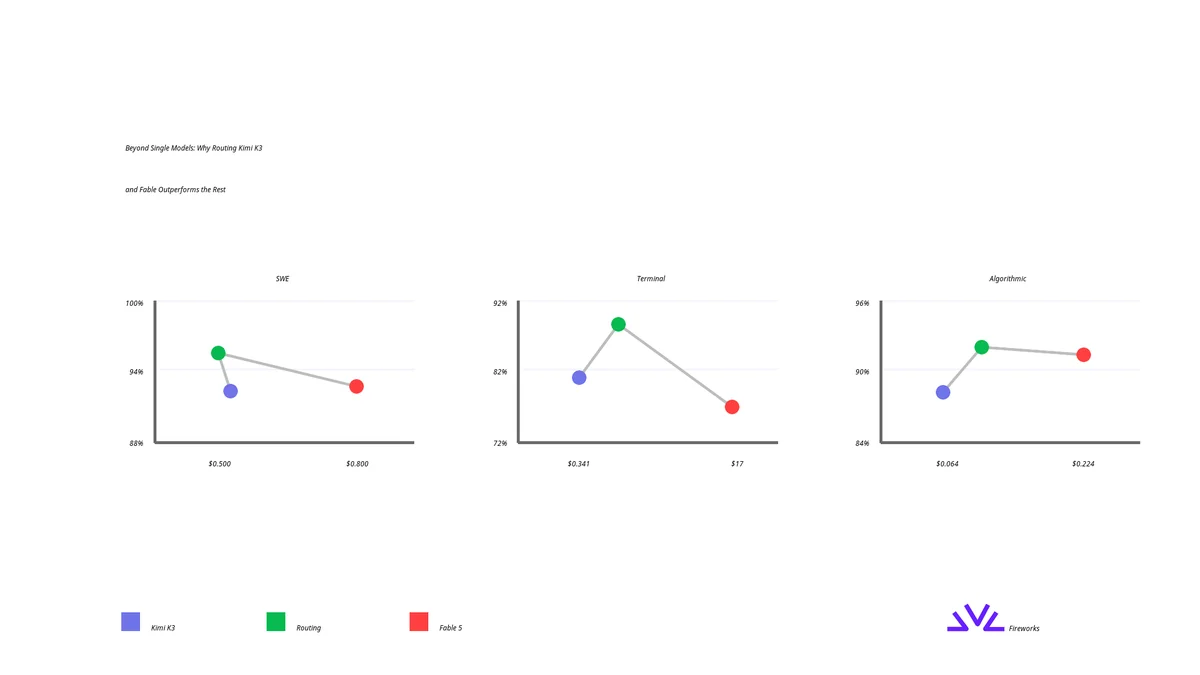
Fireworks AI 在 2026 年 7 月 21 日發布一份大規模實測報告,把中國 Moonshot AI 的開源旗艦 Kimi K3(2.8 兆參數、100 萬 token 上下文視窗) 對上 Anthropic 的閉源旗艦 Claude Fable 5,在約 1,030 個真實代理(agent)任務上直接跑同一套測試環境。結果顛覆「誰強誰弱」的二元敘事:兩者總體解題率幾乎打平,但各有所長;真正的最佳策略不是選一個模型,而是把任務「路由」到對的模型上——兩者搭配的「混合智能」才是當下的 state-of-the-art (SoTA)。
編按:本文綜合整理自 Fireworks AI 官方部落格、Tom’s Hardware、the-decoder,並加入 Siami 編輯部觀點與分析。
實測怎麼做
Fireworks 把測試任務切成五大類,涵蓋真實工程師會遇到的場景:
- SWE(460 題):模擬真實 repo 的 bug 修復(SWE-bench 風格)
- Terminal(89 題):長時程代理操作,涵蓋資安、加密、逆向工程、系統管理
- Algorithmic(100 題):LeetCode / AtCoder 風格題
- Multi-Language(225 題):跨六種語言的實作
- Legal(120 題):律師評分的法律代理任務
K3 與 Fable 5 跑同一套測試工具鏈(harness),再用「oracle routing」測量理論天花板——也就是先把每個任務餵給兩個模型,再選對的那一個且取成本最低者,藉此看出「理想路由器」能把品質推到多高。
兩邊打個平手,但擅長不同戰場單看總分,SWE 上 K3 是 92.4%、Fable 是 92.6%,幾乎貼在一起。Multi-language 也只差幾個百分點。但一旦拆解到子領域,差異立刻浮現:
- K3 強在:符號數學、dev tooling、Terminal(89 題裡 K3 拿 11 個獨勝、Fable 7 個;資安與加密子類 K3 直接碾壓)
- Fable 強在:Web、資料視覺化、多語言廣度(Java / Python / C++ 上 Fable 領先,K3 在 JavaScript 與 Rust 上追平)
Fireworks 把這個現象稱為**「專項化」(specialization)——兩邊不是「差不多」,而是在不同題型上輪流坐莊**。
- 7z 雜湊破解、FEAL 加密分析、洩漏的 secrets、即時漏洞、失控的非同步任務——這幾題 K3 全清,Fable 全部卡住
- 在 Web 前端程式碼(JavaScript / React)上,Fable 的解題效率與品質明顯高出一截
價格差才是真議題:最高 50 倍成本差距品質幾乎打平,價格卻差了十倍到五十倍。Fireworks 用 prompt caching 與「每題消耗的 token 數」雙指標拆解:
- SWE 任務:K3 平均 55 輪、1.3M tokens;Fable 21 輪、130K tokens——但開了快取後 K3 反而更便宜
- Terminal 長任務:情況反過來,Fable 平均 64 輪、1.5M tokens,常常直接 timeout;K3 收得快「oracle router」實際選 K3 的比例是 72% 到 96%——也就是說,絕大多數任務其實不需要 Fable,但需要 Fable 的那 4–28% 才是真正賺錢或救命的關鍵。
結論:與其選一個模型,不如路由它們。Fireworks 主張「Pick a model」這個時代正在結束,「Route a model」才是接下來的競爭點。
為什麼這件事重要這份報告不只是另一份 benchmark 表——它對 AI 產業的定價權與部署策略,有三個實質衝擊:
-
「閉源 vs 開源」敘事正在被翻盤。K3 是迄今最大的開源權重模型(2.8T 參數),在 Terminal、Legal 與部分多語言任務上直接打平或超越閉源 Fable 5。這對 Anthropic 的高溢價訂價模式構成實質壓力——如果客戶能以 1/10 到 1/50 的成本拿到 90% 以上的表現,閉源廠商必須證明剩下的 10% 真的值那個價差。
-
「單模型最優」的假設已經破產。Fireworks 用實測數據證明:單獨看任一模型都不是 SoTA,必須靠路由器組合。這給所有 AI 應用開發者一個明確的方向——把「選擇模型」升級成「設計路由器」,這是一個全新的工程問題,也是新的護城河。
-
中國開源模型進入主流能見度。K3 在 2026 年 7 月 16 日發布後,7 月 19 日就衝上 Frontend Code Arena 第一名(1679 分,超 Fable 5 的 1631 分),7 月 27 日正式開放下載權重。這代表中美 AI 競賽已經走到「每週都有人刷新榜首」的階段,任何月度報告都會過時。
數據解讀與質疑雖然 Fireworks 的結論在內部邏輯上自洽,但讀者必須注意三個潛在的解讀偏差:
- Oracle routing 是理論天花板,不是實務。真正的路由器沒有「先跑兩個再選便宜的」這種奢侈;它必須從 prompt 結構、任務類型、用戶歷史「猜」哪個模型比較會答。Fireworks 自己也說「需要多一個數量級的路由資料才能說近完美的路由器真的可行」——目前 93% 的準確率是 oracle 上限,實際部署會打折。
- 「打平」是相對的。在 Frontend Code Arena 上,K3 以 1679 分贏過 Fable 5 的 1631;但在 r/LocalLLaMA 的開發者體驗中,「Fable 仍允許完整的 vibe coding 不中斷,K3 還沒到」——benchmark 高分不等於工作流體驗好。
- 價格假設依賴 Fireworks 的定價。K3 的 50x 成本優勢是基於 Fireworks 平台上的 token 報價與快取命中率。如果客戶從其他雲端廠商或自架部署,這個倍數會劇烈變動。「便宜 50 倍」是有前提條件的行銷說法。
網路回應
- 「I had Sol (via codex) do code reviews on all three and it concluded all three were solid, with some room for improvement. Fable was slightly ahead in some areas, K3 in others.」(HN 高分回應,187 讚)
- 「I admit I would like a faster model — but even though I have faster models available I still go to Fable or GPT-5.6 90% of the time. So there is a real gap between benchmarks and what people actually use.」(HN,142 讚)
- 「Kimi-K3 isn’t quite better than Fable yet, but it’s definitely getting closer. The marketing talk feels overblown. Fable still allows full vibe coding without breaking.」(r/LocalLLaMA,89 讚)
- 「Fable has been barely available and Sol was just released! Moreover, K3 is superior to both models in some domains, according to user scoring on the Arena.」(HN,76 讚)
給開發者的實務建議如果你正在考慮導入 K3,以下是三條「馬上可用」的判斷:
- 預設用 K3。對大多數日常任務(程式碼生成、除錯、文件、Terminal 操作),K3 的成本/品質比遠勝 Fable。建議把 K3 設為預設,只在關鍵、最難的 4–28% 任務切到 Fable。
- 不要照抄 Fireworks 的 router 架構。他們的路由器是為自家 1,030 題工作負載設計的;你的工作負載(客服、coding agent、文件處理)會有不同的任務分佈,建議用自家的前 500 筆真實任務重訓 router。
- 權重 7 月 27 日才開放下載。在那之前只能用 Fireworks 或 Moonshot 的 API;若你有合規或資安需求必須自架,要再等一週左右。
編按:本文綜合整理自 Fireworks AI 官方部落格、Tom’s Hardware、the-decoder,並加入 Siami 編輯部觀點與分析。
網友熱門留言 (4)