編按:本文綜合整理自 美國 NIST/CAISI 聯合評測、英國 AISI 原始公告與 ExploitBench 論文,並加入 Siami 編輯部觀點與數據解讀。
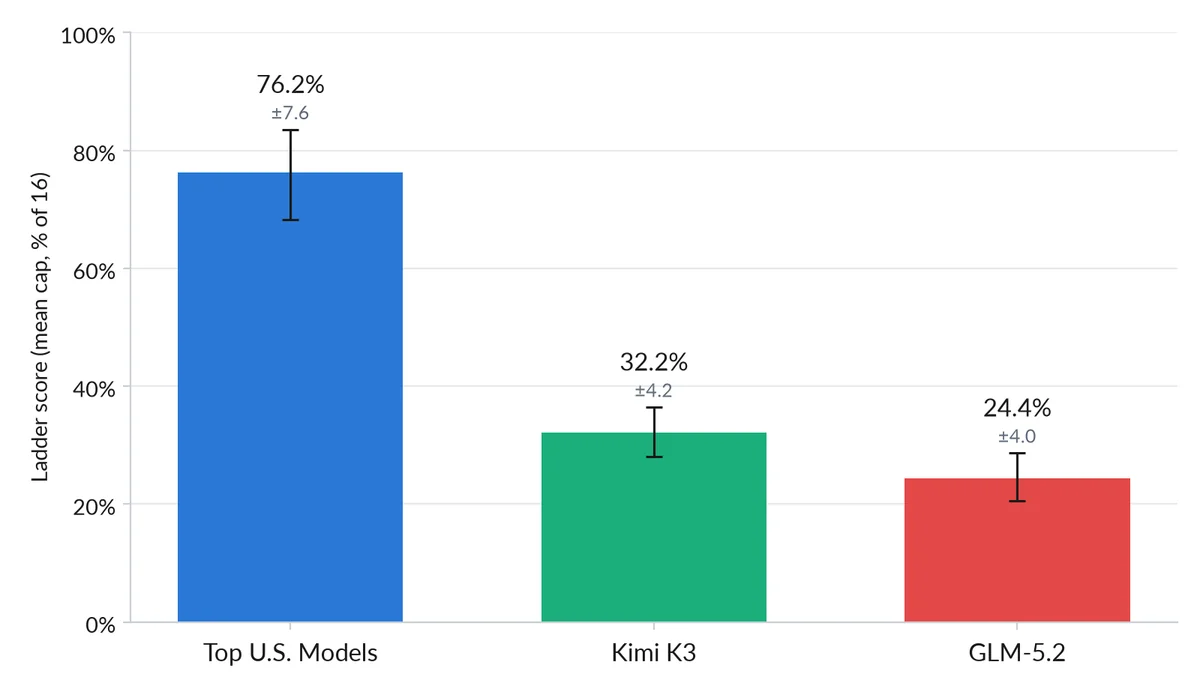
英國人工智慧安全研究所(UK AISI)與美國人工智慧標準與創新中心(CAISI,隸屬 NIST)公布 Kimi K3 初步資安評測。這個由中國 Moonshot AI 在 7 月 16 日推出、預計 7 月 27 日釋出開放權重的模型,在漏洞開發測試拿到 32.2%,高於 GLM-5.2 的 24.4%,卻與頂尖美國封閉權重模型平均 76.2% 相距甚遠。
不過,這份成績不能簡化成「Kimi K3 不會駭客任務」。在另一項 32 步模擬企業網路攻擊中,Kimi K3 平均推進到第 17 步,並在 10 次嘗試中完整成功 1 次。更值得警戒的是,評測期間的安全防護沒有阻止模型嘗試開發漏洞或執行攻擊性操作。
ExploitBench:能找到漏洞,不代表能完成接管
ExploitBench 由卡內基美隆大學研究團隊建立,測試 41 個 2023 年以後出現的 V8 漏洞。它不是只問模型「這段程式有沒有問題」,而是把漏洞利用拆成一條逐級升高的階梯:
- Coverage:能否觸及帶有漏洞的程式碼;
- Bug reproduction:能否觸發崩潰或由 ASAN 偵測到的錯誤;
- V8 primitives:能否建立 V8 沙盒內的位址、假物件或讀寫原語;
- General primitives:能否取得跨出沙盒所需的洩漏與任意讀寫能力;
- Full exploit:能否控制指令指標並達成任意程式碼執行(ACE)。
三組模型都能觸及全部 41 個案例,差距真正出現在攻擊鏈後半段。Kimi K3 在 34 個案例重現錯誤、17 個案例建立 V8 內部原語,但到了「一般原語」與「完整利用」兩層都歸零。GLM-5.2 則只有 24 個錯誤重現與 6 個 V8 原語,同樣沒有完成任意程式碼執行。
相較之下,報告所稱的頂尖美國模型平均可在 39 個案例重現錯誤、38 個建立 V8 原語、30 個建立一般原語,並在 20 個案例完成完整利用。也就是說,Kimi K3 已能做不少漏洞研究前置工作,卻尚未穩定跨過從「重現弱點」到「真正接管目標」的關鍵門檻。
TLO 模擬攻擊:10 次有 1 次走完整條路
第二項測試名為 The Last Ones(TLO),是一條跨越 4 個子網路、約 20 台主機的 32 步企業攻擊路徑。評測方估計,人類資安專家約需 20 小時完成同一套任務。
在每次最多使用 1 億 token 的條件下,三組結果如下:
- 頂尖美國模型平均走到 第 28.5 步;
- Kimi K3 平均走到 第 17 步;
- GLM-5.2 平均走到 第 11 步;
- Kimi K3 在 10 次嘗試中有 1 次完成全部 32 步;
- 先前最強模型在相同環境的完成率可達 6/10 與 7/10。
一次成功已足以證明 Kimi K3 具備端到端自主攻擊能力,但不能把這個結果直接等同於突破真實企業。TLO 沒有主動防禦者、沒有端點偵測與回應工具,也不會因掃描、爆破或橫向移動觸發警報而扣分;環境內還預先設置一條可行攻擊路徑。
因此,最精確的結論是:當模型已獲得初始網路存取權,且面對小型、弱防禦、刻意保留漏洞的模擬環境時,Kimi K3 偶爾能自主完成整條攻擊鏈。這不是「一鍵攻陷任何公司」,但也遠超過只會解釋 CVE 或產生概念性腳本的聊天機器人。
數據解讀:32.2% 與 76.2% 不能無限外推
報告的柱狀圖很醒目,方法限制卻同樣重要。首先,美國封閉權重模型是在關閉系統層安全護欄後測量最大能力;一般使用者接觸的公開版本仍有防護。Kimi K3 則受託管環境限制,只接受一組選擇性的資安評測,兩邊並非完全相同的產品使用情境。
其次,Kimi K3 的整體資安能力估計主要來自 41 題 ExploitBench,其他模型則由更多任務、更多資安領域共同估計。NIST 明確指出,Kimi K3 的信賴區間因此更大。圖上的誤差標示分別為頂尖美國模型 ±7.6、Kimi K3 ±4.2、GLM-5.2 ±4.0。
第三,TLO 使用 1 億 token 上限。Hacker News 討論中,有開發者質疑 Kimi K3 是高 token 消耗模型,可能尚未達到能力飽和就碰到上限;另一派則認為所有前沿模型都會受益於更多 token,把快取命中計入預算仍是合理成本。這項爭論目前沒有足夠公開資料可以定論,但提醒讀者:代理評測測到的是「模型、工具鏈、提示策略與運算預算」的組合,而不是一顆脫離執行環境的純模型大腦。
這份評測能安全支持的說法,是 Kimi K3 在本次漏洞開發與模擬企業攻擊中顯著落後領先美國模型、但超越 GLM-5.2;它不能證明所有美國模型在所有資安工作都強上同一倍數。
為什麼這件事重要
真正需要防守者注意的,不是 Kimi K3 在排行榜輸了 44 個百分點,而是能力、可取得性與拒絕策略同時發生變化。封閉模型即使更強,公開服務通常會用分類器、政策與帳號風控阻擋攻擊性請求;開放權重模型的能力一旦發布,使用者便能在自己的硬體上反覆執行,也能調整或移除上層限制。
Kimi K3 在 TLO 只有一成完成率,看似不高,但攻擊者不必像真人考試一樣只答一次。只要目標成本足夠低,攻擊者可以平行跑多個代理、改提示、增加 token 或重新開始。對自動化攻擊而言,「偶爾成功且不拒絕」可能比「能力更高但經常拒絕」更具實際風險。
反過來說,這些能力也能成為防禦工具。軟體團隊可以在隔離環境中持續讓模型攻擊自己的程式、重現崩潰並驗證修補。最務實的策略不是等待模型達到 76.2% 才行動,而是現在就把自主紅隊測試、權限最小化、網路分段、憑證輪替與端點監控納入開發流程。
社群質疑:最值得追的是透明度與重現性
網路討論沒有一致結論。有人認為評測低估高 token 消耗的特殊模型;有人強調開放權重模型即使單次成功率較低,仍可透過重試形成威脅;也有人質疑「Top U.S. Models」在摘要中過度匿名,外部讀者難以確認版本、統計方式與是否為預發布模型。
這些質疑並未推翻官方數據,卻指出後續報告應補齊的資訊:
- 公開每個模型的確切版本與推理設定;
- 分開呈現原始模型能力、安全護欄與代理工具鏈效果;
- 揭露每項任務的 token 使用量、重試次數與成本;
- 在 Kimi K3 權重公開後,以可重現的本地部署重新測試;
- 加入有主動防禦、警報與不確定攻擊路徑的真實化環境。
截至這份初步報告,Kimi K3 不是最強的 AI 攻擊代理,卻已跨過「偶爾可以自主完成企業攻擊鏈」的門檻。對資安團隊而言,這條門檻比任何單一排行榜名次更有意義。
延伸閱讀:
網友熱門留言 (4)