編按:本文綜合整理自 IT 之家、AMD 官方投資人關係新聞稿、The Register 與 ServetheHome 現場紀錄,並加入 Siami 編輯部觀點與分析。
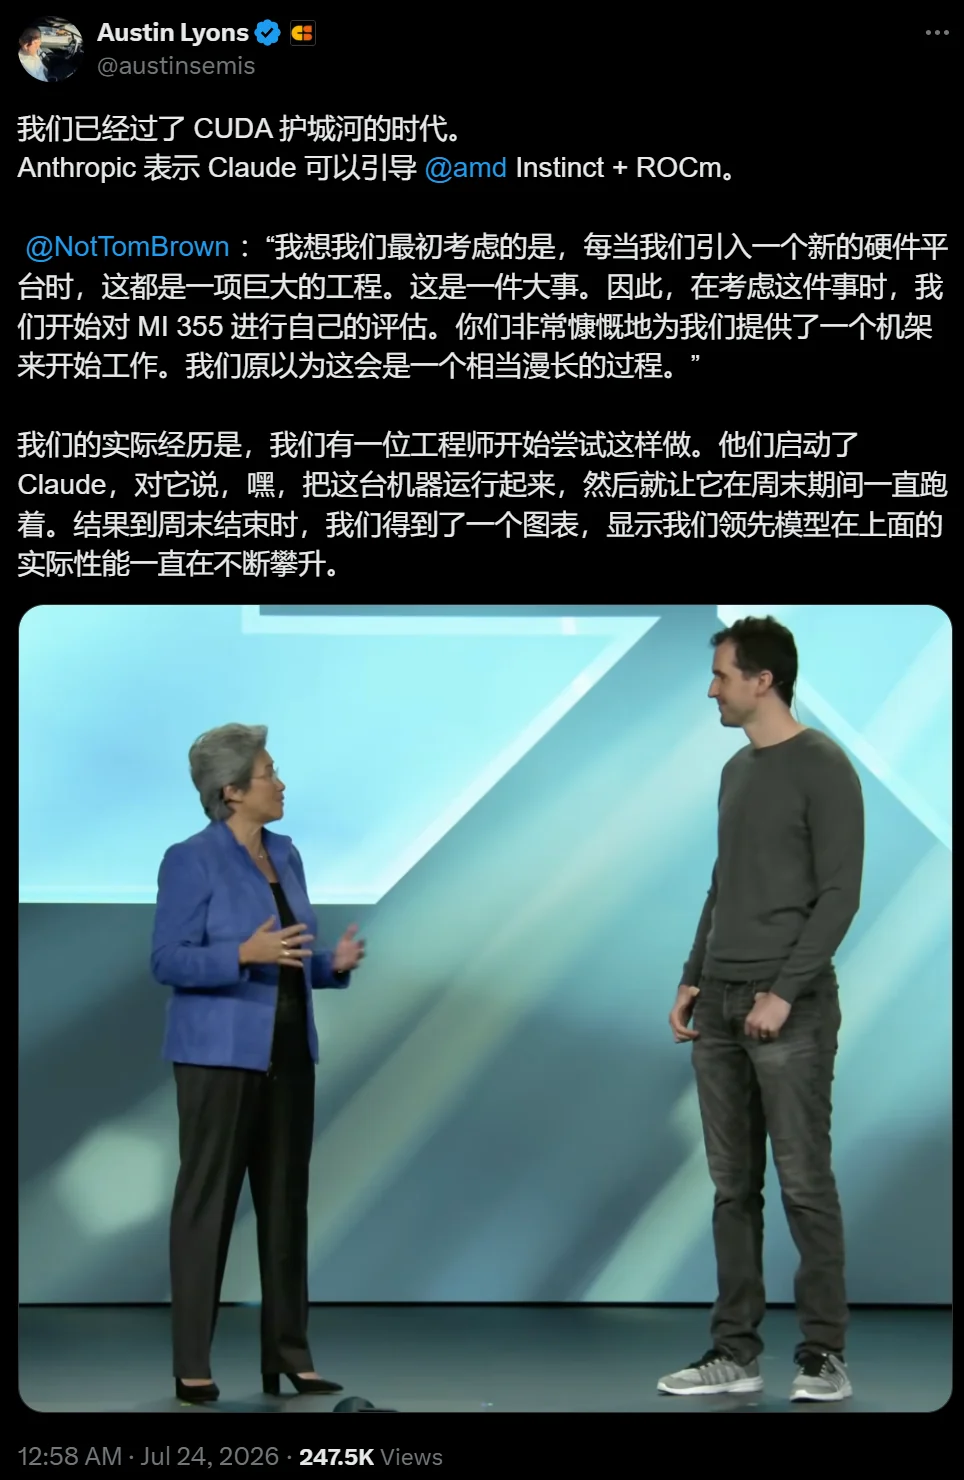
Anthropic 工程師把一台全新的 AMD MI355X 機架接上 Claude,交代一句「去,把這台機器跑起來」,週末結束回來,螢幕上已經跑出一條持續上升的性能曲線。這段時間裡面,AMD MI355X 被要求安裝 AMD 團隊花了數年才打磨完成的 ROCm 工具鏈、編譯環境與驅動,過去人類工程師每踩一次坑要數小時的工作,現在交給一個 AI agent 連續執行。
這不是某次內部 demo,而是 2026 年 AMD Advancing AI 大會上 Anthropic 共同創辦人暨首席計算官 Tom Brown 當場分享的真實故事。蘇姿丰當場補了一句:「我聽說 Anthropic 只有一名工程師在處理 MI355X,第一反應是叫 AMD 團隊趕緊去幫忙;結果團隊回來說,對方說『不用,都搞定了』。」
一場週末意外,催出 Anthropic 與 AMD 的 2GW 結盟
Tom Brown 的週末實驗結果很快接上了正式的部署計畫。Anthropic 已經宣布將在 AMD 代號為 Helios 的機架系統上,部署總量最高 2 GW 的 Instinct GPU;首批 1 GW 預計在 2027 年上半年上線。雙方還會直接用 Claude 來最佳化 AMD 工作負載,加速 ROCm 軟體開發。
Helios 並非單顆 GPU,而是一整個機櫃: 72 顆 MI 系列 GPU 加上 31 TB 的 HBM4 記憶體,被塞進單一雙寬機架,並搭配 AMD 自家 EPYC CPU 與 Pensando 網路晶片。Anthropic 這次等於一次買下整條 AMD 機架堆疊的運算容量。
對 NVIDIA 而言,這是另一個重大訊號:在 Anthropic 既有數萬顆 H100/B 系列 GPU 之外,AMD 將成為第二個長期算力來源;未來兩到三年,這家公司的訓練與推理負載將明確分散在兩個硬體平台上。
從「晶片手冊」到「Agent 看得懂的 API」
讓這次事件真正不一樣的,不是機架數量,而是 AMD 把晶片說明書的寫法改了。
AMD AI 軟體與解決方案副總裁 Anush Elangovan 在大會上揭露:每一代 AMD GPU 都會公開完整的指令集架構(ISA),並提供 AI 可讀 的手冊格式。Agent 拿到這些手冊後,可以自行裝環境、部署模型、讀日誌、查故障,再透過 ROCm CLI 直接操作機器。開發者只要定義目標,剩下的路 agent 自己找。
AMD 把這整套流程包進新的 ROCm.AI 平台,其中包含一個名叫 Hyperloom 的自動調校工具:
- 拉起推理服務,產出第一條 baseline。
- 自動搜尋 CPU 與 GPU 瓶頸,掃描不同組態。
- 產生客製化 kernel,重新跑一輪驗證。
- 把成果沉澱,下次任務直接複用。
現場 demo 中,Hyperloom 把某個 M3 等級大型語言模型的輸出速度提升了 38%,並且在一次連續測試裡跑過 14,000 個模型,把經驗直接固化成可重用的調校流程。AMD 也開源了 AgentKernelArena 基準,用來評測 AI agent 在真實 GPU kernel 最佳化任務上的表現。
一句話總結: AMD 不再只是賣硬體,而是在賣「讓 AI 看得懂的硬體」。對 NVIDIA 而言,這比多賣幾張顯示卡更難招架。
CUDA 護城河的真實樣貌:二十年換來的是「手感」
CUDA 並非一套編譯器,而是一整代工程師用時間堆出來的「直覺」。算子怎麼調、collective 怎麼切、顯存怎麼分配、跨機分佈式通訊在哪裡最容易抖動,這些經驗全部鎖在少數資深工程師的腦中。後進者就算做出能與之匹敵的硬體,要追上這套生態仍得從頭走一遍;晶片流片可以按季推進,生態積累卻只能按年去熬。
Anthropic 的週末實驗顯示,新的變數已經出現:
- 一名工程師放出一群 agent,就可以並行排查問題、定位效能瓶頸。
- 一次跑通的組態、寫好的 kernel 與踩過的坑,會馬上變成下一批 agent 的起點。
- 原本按年計算的追趕曲線,正在被壓縮成按任務計算。
SemiAnalysis 在最新一期分析報告中對這個關卡有相似的判斷:AMD 是否能破 CUDA 護城河,要看 Hyperloom 這類 agent 工具能否在 「InferenceX 等主流基準」 上持續打平甚至反超 NVIDIA;如果可以,軟體差距就不再是護城河。
延伸閱讀與產業分析:
- SemiAnalysis〈Can AMD break the CUDA Moat?〉
- The Register〈AMD vibe codes its way past the CUDA moat with ROCm.AI〉
- Thenewweb〈AMD is investing $5 billion in Anthropic〉
為什麼這件事重要
傳統上,誰能成為下一代 AI 基礎設施的主力供應商,取決於軟體生態是否完整。NVIDIA 用二十年時間把 CUDA 變成 AI 開發的「隱形標準」:每個框架、每一篇論文、每一個開源模型都繞著它寫,新進者要超越的不是 GPU 算力,而是整套開發者體驗。
2026 年 7 月之後,這條規則開始鬆動。兩件事同時發生:
- AMD 開放了 agent 可讀的硬體手冊,把原本要靠資深工程師的「手感」,變成可以被程式化掃描的介面。
- 前沿模型已經可以自行完成 CUDA→ROCm 的移植與 tuning:以 Claude 為代表的 agent,能在數十分鐘內接手過去需要一個團隊數週的工作。
從 Anthropic 的角度,這也是一次「多供應商化」風險控管:在已經重度依賴 NVIDIA 之後,將一部分訓練與推理負載遷到 AMD Helios 上,可以降低單一供應商風險、加碼未來的議價空間,也回應了監管機構對「AI 算力過度集中」的擔憂。
對 NVIDIA 而言,真正的壓力不在硬體銷售,而在 CUDA 知識護城河的不可替代性。如果 AI agent 已經能跨平台移植與 tuning,CUDA 累積二十年的經驗差距,可能會被「跨平台 AI 工讀生」以數倍速度抹平。
🚨 數據解讀與質疑
- 「2 GW」是上限,不是承諾。 AMD 與 Anthropic 的合作公告中,2 GW 是「up to」;實際出貨進度仍要看 Helios 量產時程、CoWoS 與 HBM 產能分配,以及 Anthropic 自身資金節奏。首批 1 GW 排定 2027 H1,這意味著 2026 年內不會看到大規模出貨,市場期待的「即時營收貢獻」需要後續觀察。
- M3 +38% 那個數字需要更多上下文。 Hyperloom demo 對象是「某個 M3 等級的大型語言模型」,沒明示 是哪一家模型、什麼 prompt、什麼 batch、什麼精度;且 demo 場景選在 MI355X,這個型號恰好適合 4-bit/8-bit 推理調校。要驗證「生產環境真有 38% 提升」,得等 LmSys/InferenceX 公開跑分。
- Hyperloom 與 M3 連用是巧合還是預設? 現場 demo 提到用「M3 等級」模型做提升示範。Anthropic 與 AMD 在公告中並未說明二者是同步測試,還是 AMD 把 Claude 作為通用 agent 借調示範。如果是有意挑選,訊號就是「AMD 想讓市場相信 Claude 是新 CUDA 之外的另一個標準」;如果是隨機,這只是敘事學。
- NVIDIA 仍有領先。 AMD Helios 在固定機架功耗下給出 10–15% 性能優勢,是「最高吞吐工作負載」對比,未涵蓋全部場景;NVIDIA 的 GDDR/NVLink/Dynamo 排程等體系依然完整,短期內大型 CSP 的主流採購仍會以 NVIDIA 為主力。
- AMD 股價與 Helios 商業模式仍是分開議題。 5 億美元入股 Anthropic 是策略合作,與 Helios 機架每台 5.25M 美元的售價是兩條不同的資金邏輯;後續營收要看 OpenAI、Meta 等其他客戶是否跟進下單,不是 Anthropic 一家定生死。
後續追蹤清單
- 2026 年 7 月底:Hyperloom 與 ROCm.AI 開源範圍與 SDK 釋出時程。
- 2026 Q4:AMD Q3 財報,是否揭露 Helios 機架客戶名單與出貨量。
- 2027 H1:Anthropic 首批 1 GW Helios 部署上線,部署地點是 Anthropic 自有資料中心還是 hyperscaler。
- 2027 全年:NVIDIA 是否推出「對應 ROCm.AI 的官方工具鏈」(CUDA-on-CUDA 的 agent SDK?)以回應開發者流失風險。
編按:本文綜合整理自 IT 之家、AMD 官方投資人關係新聞稿、The Register 與 ServetheHome 現場紀錄,並加入 Siami 編輯部觀點與分析。
網友熱門留言 (3)