編按:本文綜合整理自 FermiSense When Machines Take The Wheel、Hacker News 討論串,並加入 Siami 編輯部觀點與分析。
一家來自立陶宛的 AI 公司 FermiSense 只花 500 美元租了兩張 GPU,用 GRPO 強化學習把一個 9B 開源模型微調成電商目錄審查專家,結果在自家設計的 17.7 萬次評估中拿到 87.3% 分數,超越他們測試過的 GPT-5.5、Claude Opus 4.8、Gemini 3.1 Pro 等所有頂級商用模型。同一份工作如果交給最強的商用 API,每千件商品要花 34 美元,這個自製模型只要 0.5 美元,價差達 68 倍。這篇文章目前登上 Hacker News 首頁,301 個 upvote、112 則討論,被許多讀者視為「開源 + 微調足以取代商用前沿模型」的標誌性事件。
一、他們到底做了什麼
FermiSense 的實驗目標只有一個流程:電商平台審查商品上架資料,確認分類、品牌、屬性欄位都填對,並抓出仿冒品與政策違規。這個工作每天在大型平台發生數千萬次,看似簡單,實際上需要理解該平台的分類樹、品牌保護名單、政策細則。
他們先用 Amazon Berkeley Objects 真實商品資料集做出 17.7 萬個「虛擬審查任務」,每個任務都包含商品圖片、標題、描述、宣稱品牌、地區,並在裡面埋入已知答案的對照組。代理要在這個數位孿生環境裡,依序呼叫三個工具:「搜尋分類樹」「查詢品牌狀態」「取回該分類的屬性規格」,最後做出包含分類、屬性、政策裁定的完整判決。答錯時由評分器打分數,違規漏抓的懲罰比重刻意設為誤報的 7 倍,模擬真實業務對漏放的高敏感度。
二、比較對象:5 個頂級前沿模型都輸了
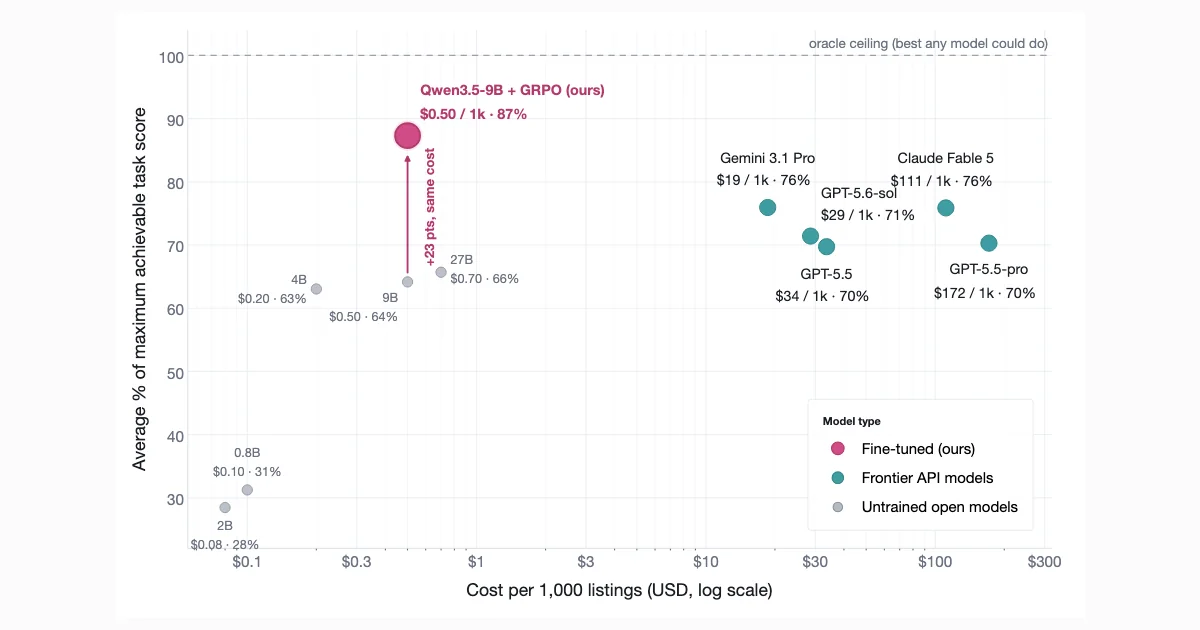
他們先測了 5 個前沿模型:GPT-5.5、GPT-5.5-sol、Gemini 3.1 Pro、Claude Opus 4.8,以及他們稱為 Claude Fable 5 的版本。每個模型都用兩種設定測:簡單 prompt 加上 2,800 字經過 prompt 工程師調校的優化指令。所有人類可寫的 prompt 都用盡了,結果前 5 名的分數全部擠在 0.7 上下,差距不到 0.1 分。
關鍵觀察:再怎麼調 prompt 也只能逼近 0.769,因為這個流程需要的是「記住這家商店的分類樹怎麼寫、品牌哪些算受保護、邊角案例該怎麼處理」這些無法用 prompt 條列的內隱知識。對前沿模型而言,每次呼叫都是從零開始拼湊;對微調後的模型而言,這些知識住在權重裡。
三、訓練成本與時間表
他們用 prime-rl 框架租了兩張 RTX PRO 6000(一張產 rollout、一張跑梯度更新),跑 1,000 步 optimizer,大約三天半,總成本 500 美元。大約在第 250 步(一天左右)模型就已穿越前沿模型的分數帶,剩下的時間都在擠出最後一點性能。最終 9B 適配器在標準評測 harness 上拿到 0.626 分,相當於滿分的 87.3%。
這個結果打破了一個迷思:達到頂級表現不需要動輒數百萬美元的訓練算力。500 美元、3.5 天、一個普通開源模型,就能在特定任務上壓過所有前沿模型。
四、成本數字對照:一年 5 億美元 vs 700 萬美元
文中最重要的圖表把每千筆審查的成本與品質放在同一張圖:
- 微調後 9B 自架伺服器:每千筆 0.5 美元
- 最便宜的商用前沿設定(Gemini 3.1 Pro):每千筆 19 美元,差距約 40 倍
- 最貴的商用前沿設定(GPT-5.5-pro):每千筆 172 美元,差距約 340 倍
- 文中也提到,對 prompt 加 2,800 字優化指令會讓 GPT-5.5 的成本再增加三分之一
以 Shopify 等級的 4,000 萬次每日決策計算,用商用 API 一年要花 5 億美元,用自家微調模型只要 700 萬美元。這不是逐步降低,是直接讓既有商業模式破產的差距。
重點 1:模型效益真正影響商業模式時,「租用 vs 自訓」的選擇就是策略問題,不是技術問題。
為什麼這件事重要
這篇文章戳破兩個長期以來被忽略的產業前提:
第一,「前沿模型擅長一切」這個說法在特定任務領域並不成立。當任務可被評分、有高頻率、足夠資料時,9B 微調模型就能超越 GPT-5.5。這意味著大量企業不必為了通用能力去買頂級 API,他們只需要一個會自己業務的小模型。
第二,「AI 投資泡沫」這個敘事需要重看。HN 用戶 billmalarky 提出了一個值得思考的問題:即使模型商品化,GPU、頻寬、推論算力依然是稀缺資源,雲端資本支出靠推論需求仍可回本。但這篇文章展示了另一面:當企業選擇自架微調模型時,雲端推論營收會直接被切走。這對 Microsoft、AWS、Google Cloud 的 AI 營收預測都是警訊。
更關鍵的是,Bridgewater、Harvey、Intercom、Shopify、Cognition、LinkedIn 等公司都公開了類似結果:他們的微調模型在自家任務上超越了前沿模型,並已上線運作。這條路徑已經從實驗室走進企業 IT 預算。
數據解讀:這套打法為何不適用所有場景
FermiSense 自己也在文末承認邊界。要讓微調劃算,必須同時滿足幾個條件:任務頻率高到邊際成本會放大、每個決策都能用規則或評分器驗證、領域專家對「正確答案」有共識、任務包含多步推理+工具呼叫、最終決策不能用擲硬幣蒙對,且涉及敏感資料不能外流。任一條件不成立,租用前沿模型仍是正解。
HN 用戶 h_mirin 也補了一刀:500 美元是明面上最便宜的那行,真正的成本是 17.7 萬筆已評分的資料和後續維護。FermiSense 是用 Amazon Berkeley Objects 合成資料,多數企業沒有這種奢侈品;若資料不自然存在,微調就不會比直接用商用 API 便宜。
這也是為什麼這篇文章的價值不在「人人都該這樣做」,而在於驗證了一個被低估的假設:當任務具備高頻、可驗證、可量化三個條件時,用開源模型+RL 微調取代商用前沿模型在技術與經濟上完全可行,並已開始規模化。
參考來源
- FermiSense 原文:The Rise of Intelligence Ownership
- Hacker News 討論串(301 points、112 comments)
- Ramp CEO Eric Glyman 在 X 揭露 AI 投資 vs 營收成長的數據
- AIA Labs × Bridgewater 釋出的研究報告:Learning to Replicate Expert Judgment in Financial Tasks
- Ramp × Prime Intellect 公開的 RL 微調實戰紀錄
- Harvey × Applied Compute 公開法律 AI agent 微調過程
- Intercom 公布 Fin Apex 微調結果
- Shopify 工程部落格:Leveraging multimodal LLMs at scale
網友熱門留言 (5)