編按:本文綜合整理自 Qwen 官方部落格、Neowin 報導、MarkTechPost 分析、orcarouter.ai 評測 與 Thomas Wiegold 部落格,並加入 Siami 編輯部觀點與分析。
阿里巴巴旗下的通義千問(Qwen)團隊於 2026 年 8 月 3 日正式發表 Qwen3.8-Max——這是 Qwen 系列迄今最強大的模型,也是 Max 等級首次宣布開源。模型規模達 2.4 兆(2.4T)參數,每次推理激活 95B;在編碼、實務工作、長時程任務、多模態代理四大主軸全面升級,並宣稱可在最少人為介入下,端到端完成複雜長鏈任務。官方已同步啟用 QwenCloud API,模型權重於「下週」釋出至 Hugging Face 與 ModelScope。
為什麼這件事重要
2026 年開源旗艦模型的軍備競賽已經打到「兆級」門檻。Moonshot AI 在 7 月底開源 2.8T 參數的 Kimi K3,緊接著 Qwen 端出 2.4T 的 Qwen3.8-Max——兩家中國 AI 公司在不到兩週內接連衝破開源參數量天花板。更值得注意的是,這是 Alibaba Qwen 第一次把 Max 等級模型開源,等於把原本只鎖在 API 後的旗艦能力釋出給開發者社群。
對中文 AI 應用開發圈來說,這影響的不只是模型選擇,更是「能不能離線部署這個等級的能力」——一旦權重釋出,企業自建、私有雲、邊緣部署都成為可能,不必再為每 token 付 API 費。
編碼能力:16 天無人介入的自我演化
官方這次用三個「無人介入」的編碼實測來展示模型能力。最具話題性的是 oh-my-cli 專案:給模型一個空的 repo,讓它跑 16 天,自己設計 task state machine、dispatcher、watchdog,從使用者回饋、進階社群實務、模型自我測試結果三個訊號源持續迭代。截至 2026 年 7 月 30 日,repo 已累積 265 個 commits、127 個 PR、151 個 issue。
第二個案例是 重現 + 改進論文:給模型一篇「Unified Data Selection for LLM Reasoning」的研究論文,從零開始重現實驗——約 5 天、7,600 行程式、1,100 個動作、33 輪 GPU 訓練,完整重現論文六項發現(含 AIME24 比隨機資料挑選 +7.7% 的關鍵結論)。接著模型自行啟動「假設→寫程式→執行→分析→重來」的研究迴圈,連續跑了 4 輪、提出 18 個改良想法,最終發展出比原論文還好的方法——AIME24 上 +2.7 分。
第三個是把模型丟進 天池的 WWW2025 多模態對話意圖辨識競賽,跟 526 隊真人隊伍同場競技。模型 24 小時內從零讀完規則、自己組合 BERT、MacBERT、RoBERTa 三個文本模型加 Qwen2.5-VL-7B 視覺模型,再加 Chinese-CLIP,最終以 0.853 準確率擊敗 458 隊(87% 的參賽者)。
實務工作:百種職業的真實工作流
Qwen 團隊把模型丟進「幾百種高經濟價值職業」做壓力測試,並列舉六個具體案例:
- 企業法務合規:在單次掃描中,於上百份文件裡挑出 1,284 條相關條款,原本需要律師團隊協作一週的工作,一小時內完成。
- UI/UX 設計師:為數位銀行 NOVA 一次產出 8 個螢幕的高擬真互動原型,零輪人工修改;傳統工作流通常需要 3 到 5 輪修訂。
- 餐飲品牌創辦人:讀完上百份食材供應簡報後,一次產出 26 道菜的完整菜單,每道標註熱量與食材來源,食材成本佔比控制在 33.8%。
- 結構工程師:僅憑一組圖面,在瀏覽器內重建 30 層辦公大樓的地震結構模型,可即時檢視自然週期、基底剪力、層間位移比。
- 復健治療師:把 2D 紙本評估表變成可任意旋轉、含分層解剖覆蓋的 3D 互動 demo,原本需要醫療動畫公司 2-4 週工期。
- 運動數據分析師:每位球員約 8,400 次攻守回合,幾十分鐘內變成可用的球員戰術側寫與教練報告。
另一條主軸是 Dynamic Workflows:模型從六段簡短描述(動能、價值、品質、投資、低風險、情緒)自動分解成 50 個研究方向,派出約 330 個子代理,完成約 6,000 次回測——選出的因子達成超額夏普值 0.64 到 1.48,IC 一致為正(0.010 到 0.014)。
長時程任務:自主晶片設計到 365 天電商模擬
官方報告中兩個最極端的長時程案例特別值得展開。
自主晶片設計:模型從基本任務描述、空白的 RTL 模板、驗證評估腳本出發,在整合 Iverilog、Yosys、OpenROAD 工具鏈的沙盒中全自動執行 500 輪、71 次評估、跨越 13 個里程碑,把 GCD/RSA 密碼加速器的閘數從初始的 8,298 門一路壓到 678 門(92% 縮減)。實體佈局從 106×106 µm² 縮到 46×46 µm²(81% 面積縮減),500 MHz 時序收斂。
關鍵的里程碑算法層級重構:
| 階段 | 輪次 | 閘數 | 核心動作 |
|---|---|---|---|
| 起始 | — | 8,298 | 初始可運行設計 |
| 算法重寫 | Turn 22 | 2,010 | 模除法器改為迭代位移相減(單步省 6,288 門,佔總減量 80%) |
| 冗餘消除 | Turns 35–48 | 1,304 | 繞過 REDUCE 階、合併獨立模組、優化輸出路徑 |
| 暫存器與 FSM 剪枝 | Turns 60–113 | 907 | 移除冗餘 base/mod 暫存器、合併比較-減法邏輯 |
| 模組融合 | Turns 170–252 | 765 | 把乘法器直接內嵌進模冪 FSM |
| 閘級精修 | Turns 443–500 | 678 | 共用 NOR 樹、絕對差分割、byte-to-bit 選擇 |
365 天電商模擬(E-Commerce Bench):模型拿到 10 萬人民幣起始資金,要同時營運多家線上商店,面對 12 種店型、60 個品類、近 600 個供應商、7,000 個商品,還要應付季節性需求波動、颱風等供應鏈危機、年終大促。Qwen3.8-Max 最終以 ¥416,252(4.16 倍報酬)收盤,比第二名 GLM 5.2 高出 38%,比它的前一代 Qwen3.7-Max 強 152%。
Benchmark:跑贏 Opus 4.8,部分項目超越 Fable 5 與 GPT-5.6 Sol
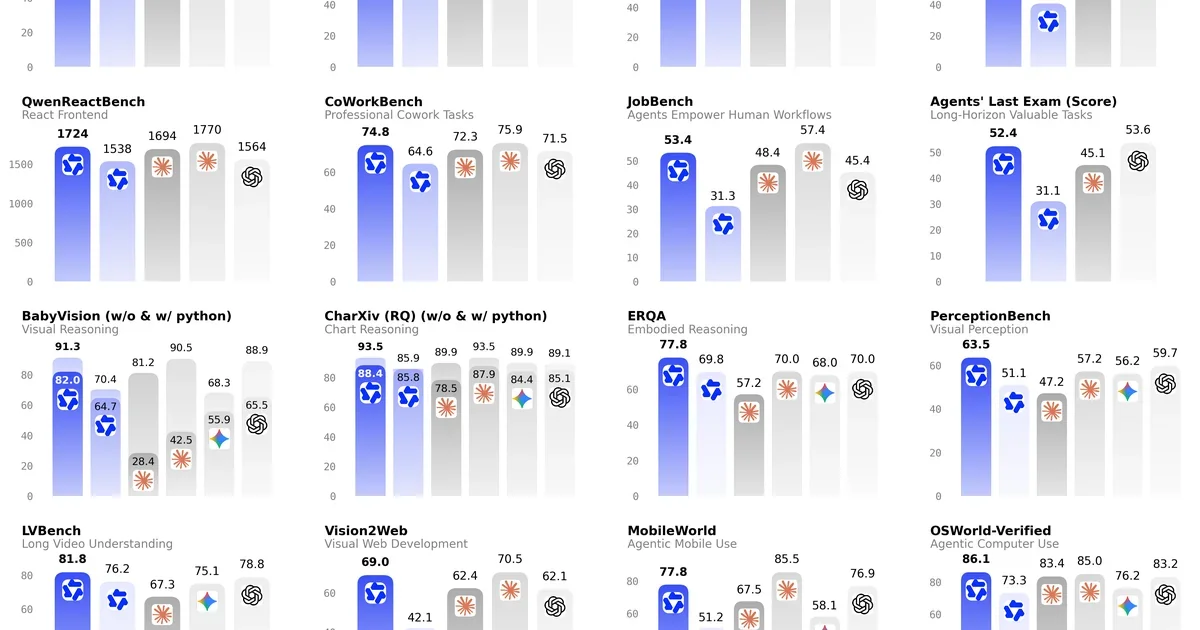
官方公布的完整榜單橫跨四個類別,最值得看的是 Qwen3.8-Max 在以下項目達到 SOTA 或接近頂標:
- PaperBench:93.0(Fable 5 88.8 / GPT-5.6 Sol 90.5 / Opus 4.8 80.3)——第一名
- MathVision:95.2 / 97.7(Fable 5 92.7 / 98.6)
- BabyVision:82.0 / 91.3(Fable 5 42.5 / 90.5)——大幅領先
- ZeroBench:24.0 / 49.0(Opus 4.8 17.0 / 34.0)——跑贏 Opus
- OSWorld-Verified:86.1(Fable 5 85.0)
- Parametric CAD Bench:91.5(Fable 5 87.5)
- PerceptionBench:63.5(對比組中最高)
- CountQA:82.4(Fable 5 63.1)——領先近 20 分
但同一張榜上也有不少 Qwen 落後的項目:Terminal Bench 2.1 86.6 仍輸 GPT-5.6 Sol 的 88.8;SWE-bench Pro 67.7 遠低於 Fable 5 的 80.0;DeepSWE 1.1 56.6 也不到 Fable 5 70.0 的八成;HLE w/ tools 56.2 落後 Fable 5 的 64.5。也就是說,整體表現「夠強」但不是全面碾壓,仍有特定 benchmark 被對手壓著打。
多模態代理與 API 整合
Qwen3.8-Max 的視覺不再只是輸入端的「另一種模態」——而是貫穿規劃、執行、驗證、迭代的原生回饋迴圈。模型在執行過程會持續觀察自己的中間結果,發現電視方向錯誤、介面錯位、視覺成果與設計意圖不符時,能自主識別偏差、修正計畫、調整輸出。
官方推出 Qwen-MM-Plugins 這個開源外掛庫,讓既有的代理框架能擴充影像與影片處理、多模態記憶、動態解析度、視覺工具調用、影片編輯、Blender、CAD 等專門能力。
API 層面,模型在 QwenCloud 提供 reasoning_effort 參數切換(xhigh / medium / low 三段),預設啟用 preserve_thinking。相容 OpenAI Chat Completions、Anthropic 規格、Hermes Agent 框架,並能直接整合 Claude Code、Codex、Qoder、OpenClaw、Qwen Code CLI 等主流代理工具鏈。Context window 100 萬 token、最大輸出 65,536 token。
Siami 觀點:開源旗艦的真實意義
Qwen3.8-Max 的關鍵意義在於它把 Max 等級的旗艦模型開源。歷史上 Aliyun 通義一直把 Max 系列鎖在 API 後,開發者只能用 Plus 或更小的層級;這次 2.4T 參數的 Qwen3.8-Max 釋出權重,等於讓企業可在自己的硬體上跑這個等級的能力,不必再為每 token 付出 API 成本。
對於台灣與國際的中文應用開發圈,這尤其重要。過去一年 Claude 與 GPT 的頂規模型對中文任務常有微妙的文化偏差,Qwen 系列在中文語料、簡繁中文轉換、台灣用語上有結構性優勢。Qwen3.8-Max 一旦開源,本地化部署會大幅加速——從客服機器人、法律文件審查到中文教育應用,都有了可離線、可自建的旗艦選項。
但官方目前仍有幾個地方沒交代清楚:Terminal Bench 2.1、PaperBench 等自家基準是否被獨立第三方重現?preview 期 $3/$15 per million tokens 的暫訂價,正式商用價是多少?Apache 2.0 還是其他開源授權?2.4T 模型離線部署的硬體需求(GPU 數量、記憶體、推論引擎)?這些都要等下週權重釋出時一起揭曉。
業界反應與待觀察
社群在 Hacker News 上對這則發表的討論集中在三個點:①Benchmark 透明度——官方表格漂亮,但部分基準(CoWorkBench、QwenSWEBench、QwenReactBench)是 Qwen 自家內部測試,獨立驗證仍是黑盒子;②開源節奏——Moonshot Kimi K3、Qwen3.8-Max 兩週內接連開源,2026 下半年中國 AI 旗艦「開源即行銷」的策略已成形;③西方社群對齊審查疑慮——Simon Willison 等測評者已注意到 Qwen 系列內建敏感政治話題審查機制,企業導入前需先評估使用情境。
對開發者而言,下週(2026 年 8 月中)的權重釋出才是真正的關鍵節點。建議追蹤:
- Hugging Face
Qwen/Qwen3.8-Max的 model card 與授權條款 - 商用 API 定價正式公告
- 開源社群的前 24 小時 benchmark 重現結果
- 能否與現有 vLLM、SGLang、TensorRT-LLM 推論引擎整合
網友熱門留言 (5)