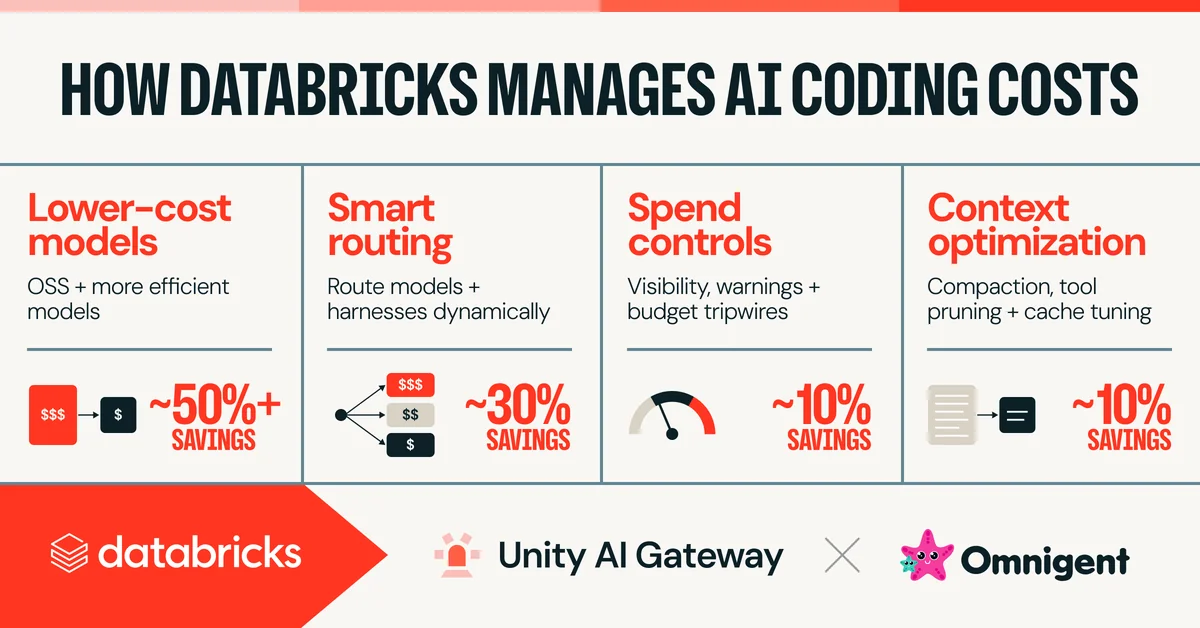
編按:本文綜合整理自 Databricks 官方工程部落格原文 Managing AI Coding Costs at Scale(Patrick Wendell 等 5 位工程師,2026-08-07 發布)、Hacker News 討論串(item id 49214468)、AlphaSignal 對 Unity AI Gateway GA 的報導,並加入 Siami 編輯部觀點與分析。原文以「在 Databricks 內部把 AI 編碼支出降低約 70%」為核心命題,拆解出四個可獨立採用的節流槓桿。
為什麼這件事重要
企業 AI 編碼工具(Cursor、Claude Code、Codex、Cody 等)從 2024 年開始進入大規模企業部署階段,但成本曲線從「線性」直接惡化為「指數型成長」——這是因為 agentic coding 會自動展開數十到數百次工具呼叫、檢索整個 codebase、整合企業內部 context,使用者輸入的一句話到真正送進 LLM 的時候,只佔總 token 流量的一小部分。
Databricks 把這個現象定義成**「雙重使命」(dual mandate) 困境**:
- 一方面,企業希望最大化 AI 轉型、給員工最低摩擦的工具存取
- 另一方面,整體成本必須鎖在「每位使用者大致固定的預算上限」內
「如果不及時控管,這條成本曲線最終會吃掉營收本身。」—— Patrick Wendell, Databricks VP of Engineering
這篇文章的價值在於:它不是又一篇「AI 改變世界」的宣言,而是 Databricks 工程團隊第一次公開自己怎麼把 token 帳單砍半的具體作法。Stripe、Coinbase、Uber、Ramp 等早期大型採用者都驗證了同一套做法。
Databricks 怎麼省下 70%:四大開源槓桿
槓桿一:往開源模型搬——「效率前緣」比「智慧前緣」更重要
一般人聽到「用便宜的模型」直覺反應是品質變差,但 Databricks 工程團隊指出,真正該追的是「效率前緣 (efficiency frontier)」而非「智慧前緣 (intelligence frontier)」。
- 「智慧前緣」定義:最強大的模型
- 「效率前緣」定義:給定品質門檻下,每美元能買到最高智慧的模型
關鍵洞見:日常 99% 的編碼工作不需要解決數學證明或新穽的資安漏洞。所以企業真正該追的是「每週幾乎都有新模型推出、單位價格的智慧更高」的效率前緣。
實戰數據(Databricks 與 Stripe 各自驗證):
- Databricks 內部 benchmark 顯示 GLM 系列模型「性價比極具競爭力」,因此已上線給開發者使用
- Stripe 測試 Opus 4.7 vs Opus 4.6,結論是品質沒顯著提升但成本變貴,因此拒絕內部採用 Opus 4.7
- Databricks 比較 Opus 5.0 vs 4.8,發現類似的成本退步
採購端的下一步是「harness 與模型解耦」:
- 一種做法是請開發者自己切換 harness(Claude Code / Codex / Cursor),但轉換成本高,最後 harness 變成模型家族的「事實鎖定」
- 更好的做法是用 meta-harness(Databricks 開源的 Omnigent 就是這個角色):保留單一使用者體驗,背後調度不同底層 harness
槓桿二:動態請求與任務路由
「與其讓使用者自己選模型,不如系統自動把每個請求送到『夠用最便宜』的模型。」
三種路由策略:
- 請求級 (Request Level):proxy 介於 harness 與模型之間,依成本/品質自動選模型。代表性產品:Cursor Router、OpenRouter AutoRouter、Ramp Router、Databricks Unity AI Gateway 的 Smart Routing。
- 任務級 (Task Level):Meta Harness 依任務複雜度分流整個工作流——例如「把元件 X 改名為 Y」(簡單)丟小模型,「探索降低延遲的設計考量」(複雜)丟大模型。
- 升降級 (Escalation/Delegation):Claude Advisor Tool 由便宜模型主導、必要時升級;Cognition Devin Fusion 反過來,由貴模型主導、便宜模型負責委派工作。
Databricks 內部數據:AI Gateway Smart Router 把平均任務成本降低 30% 以上,同時維持頂級模型的品質。
槓桿三:給開發者可見度、警告、預算——別用「硬上限」
「與其直接切斷 token 額度,不如讓開發者看得到自己的花費。」
為什麼「硬預算」行不通:
- 第一,開發者撞到天花板就被切斷 = 生產力直接歸零
- 第二,花最多的使用者往往正是 AI 增產最多的明星員工,打擊他們是自殺行為
實務做法(層層漸進):
- 可見度:每家公司都做了「即時花費儀表板」,讓開發者選擇 ROI 最高的工具
- 消費閘門 (Spend Gates):可自我清除的警告、需要主管核准的進階閘門
- 降檔 (Downshifting):撞到閘門時不是停用,而是降到便宜模型繼續工作
- 停權 (Suspension):最後手段,暫時停用 token 額度,作為一場對話的起點
槓桿四:減少 token overhead——context 是真正成本
「當使用者輸入『請調查並修掉這個 bug』時,AI 自己會去撈大量 context、呼叫大量工具、搜尋整個 codebase——使用者原本的句子只佔最終送進 LLM 的資料的極小一部分。」
正在探索的技術:
- 強制壓縮 (compaction):更頻繁壓縮主動 context
- 改用「不囉嗦」的 harness:挑 token 效率高的 harness、或微調現有 harness 減少 overhead
- 稽核熱門工具的冗長度
- 鼓勵開發者把任務拆得更小:降低 context 範圍
另一個關鍵:prompt caching 設定。Cache 寫入要錢,但讀取大幅降本。Databricks 透過簡單調校 cache 設定,幾乎砍掉 50% 的生成 token 與對應成本,開發者完全感受不到品質下降。
Siami 觀點:70% 砍成本的真實意義
為什麼這篇文章值得企業 CIO 與 AI 轉型負責人讀
- 這不是「AI 行不行」的辯論文,而是「AI 行,但怎麼不燒錢」的施工手冊。Databricks 與 Stripe、Coinbase、Uber、Ramp 各自獨立驗證同一套做法,代表這不是某一家公司的特殊情境,而是企業級 AI 編碼的產業共識。
- 「效率前緣」這個詞應該進入所有 AI 採購 SLA。未來企業合約應該寫的不是「用 GPT-5 / Claude Opus 5」,而是「用每美元智慧最高的模型」,並要求供應商提供自動分流機制。
- 「硬預算」幾乎一致被否認。所有受訪公司都同意:把 AI 預算設計成「先看見、再警告、最後才降檔或停權」的漸進式,比直接設天花板更有效。
數據解讀與質疑
| 指標 | Databricks 聲稱 | Siami 質疑 |
|---|---|---|
| 整體成本下降 | 約 70%(多項技術疊加) | 70% 是「效率前緣搬遷 + 動態路由 + token 優化」三者合計,非單一技術 |
| Smart Router 效益 | 平均任務成本下降 ≥30% | 30% 是「平均」,但對於複雜任務可能更少 |
| Cache 設定調校 | 砍掉約 50% 生成 token | 取決於 workload,長期 cache 命中率不一定穩定 |
| 企業「必須」採用 | 強烈建議 AI Gateway 架構 | 多了一套基礎設施要維運,中小企業未必划算 |
沒說出口的限制
- 70% 是「Databricks 內部」數字,公開 benchmark 不一定可重現
- meta-harness 與 AI Gateway 都需要工程投入,對 100 人以下的研發團隊 ROI 較低
- 沒有討論多模態、影像/語音生成的成本——只談編碼
- 對「AI 寫程式碼的技術債」沒有量化:HN 留言裡 ianmarcinkowski 提到「$200 token 換 $2500-3500 人工 review 成本」這條評論,正是 Databricks 沒談到的隱性成本
Siami 整理的延伸閱讀清單
- 原始來源(必讀):Databricks Blog — Managing AI Coding Costs at Scale
- 官方配套產品:Unity AI Gateway 現在進入 GA — Smart Routing、Budget、MCP Governance 三大支柱
- 同主題姐妹篇:Governing coding agent sprawl with Unity AI Gateway — 把分散的 Cursor / Claude Code / Codex 用一個 governance 層管起來
- 官方 X 公告:Databricks @pwendell 發文整理四大技術
- 第三方分析:explainx.ai — Databricks Managing AI Coding Costs at Scale: 4 Levers
- 產業觀察:AlphaSignal — Databricks’ Unity AI Gateway Now Governs Every Agent Touching Your Data
- Hacker News 原始討論串:Managing AI Coding Costs at Scale — 256 points / 218 comments
網友熱門留言 (5)