編按:本文綜合整理自 ARC Prize 官方頁面、Artificial Analysis 獨立評測、DeepSeek 官方 API 更新公告 與 Hacker News 討論串(316 分、193 則留言),並加入 Siami 編輯部觀點與分析。
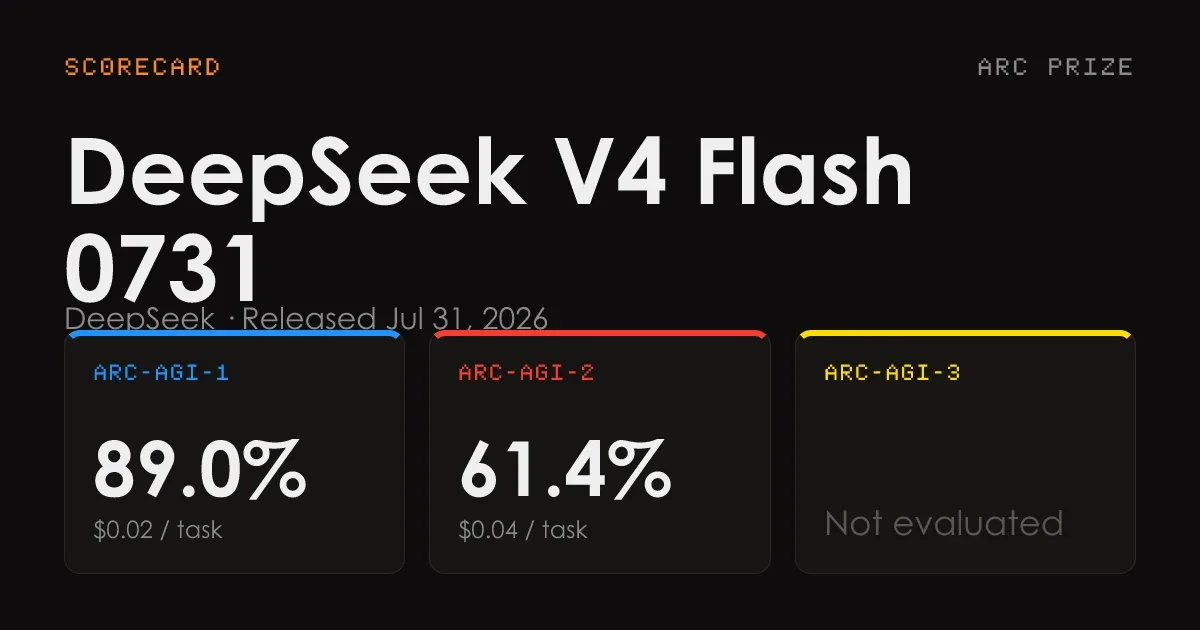
DeepSeek 在 7 月 31 日無預警地把 V4 Flash 模型從 preview 升級成正式版,命名為 DeepSeek-V4-Flash-0731。這次最大的亮點不是新架構,而是用完全相同的 284B MoE(13B active)參數,靠重新訓練後段任務,在 ARC-AGI-2 半私有測試拿到 61.4% 分數,並把自家 V4-Pro-Preview 的 agentic 基準全部超越。
正式版核心成績
DeepSeek-V4-Flash-0731 同步在 ARC Prize 與 Artificial Analysis 兩個獨立第三方平台取得結果:
- ARC-AGI-1 半私有:最高推理強度下 89.0%,單題成本 0.02 美元
- ARC-AGI-2 半私有:最高強度下 61.4%,單題成本 0.04 美元
- Artificial Analysis Intelligence Index:50 分,比 4 月發布的 preview 版本(40 分)一口氣拉高 10 分,比自家 V4-Pro-Preview 還高 6 分
- GDPval-AA v2(真實 agentic 任務 Elo):1559,比前代 1189 提升 370 點
三種推理強度變體 Max / High / Low 在 ARC-AGI-2 上分別為 61.4%、56.0%、46.0%,意味著使用者可以依場景取捨成本與品質,Low 模式單題成本可能壓到 0.01 美元以下。
架構沒動、價格照舊、訓練後段大改
DeepSeek 官方在 API 更新公告明確指出,0731 版本保留了與 preview 相同的 284B 總參數、13B active 的 MoE 架構與 1M token 上下文,模型形狀完全沒變。改動集中在三件事:
- Agent 與 coding 行為大幅強化(tool use、Code Agent 多步推理)
- 支援 Responses API 與 Codex 整合(對齊 OpenAI Responses API 介面)
- 第一方 API 緩存命中折扣拉到約 98%(業界普遍 90%)
API 定價維持 $0.14 / 百萬 input token、$0.28 / 百萬 output token,緩存命中只收 $0.0028。Artificial Analysis 指出,這個緩存結構讓 0731 在「每任務成本」上比同日降價的 GPT-5.6 Luna(max)便宜約 60%,即使兩者 Intelligence Index 只差 1 分。
同一個權重檔案、同樣的參數量、同一個上下文長度,卻靠後訓練在 agentic benchmark 上贏過自家 49B active 的 Pro preview。這代表 Mixture-ofExperts 與 sparse attention 的潛力還遠遠沒榨乾,後訓練資料 + 對齊方法的紅利,比硬體升級更具槓桿。
為什麼這件事重要
這次更新從產業結構與工程實務兩個層面都值得關注。
1. 「後訓練紅利」壓過「架構升級」
過去兩年大模型競爭主旋律是「參數量更大、訓練資料更多、架構更新」。DeepSeek 用同一個 13B active 的 MoE 主幹,靠 RLHF 與 agentic SFT 把能力拉過 49B 的 Pro preview,證明後訓練階段還有大量未開採空間。這對中小型實驗室是好消息——沒有萬張 GPU 也可以把既有架構榨出來。
2. 中國開源模型的「軍備競賽」進入第二階段
0731 上線一個禮拜前,Inkling Small 也在 Artificial Analysis 拿到與舊版 V4 Flash 接近的分數;同一個月,Qwen3.8 Max 拿下 agentic index 第一。現在 DeepSeek 0731 又把性價比拉到新高度。中國開源生態不再只是「追 frontier」,而是開始在特定維度(成本、agentic、code)局部超越。
3. 「每任務成本」正式成為新的戰場
Artificial Analysis 在 8 月初推出 Endpoint Accuracy Index,明確認為「同模型不同 endpoint 會有不同準確率」。DeepSeek 0731 在官方 API 上的性價比表現,會逼迫其他家(OpenAI、Anthropic、Google)把緩存折扣、batch 價、長上下文優化當作下一輪競爭重點。
數據解讀與質疑
質疑一:ARC-AGI-2 從 61.4% 看起來很強,但對比基準是誰?
ARC Prize 公開的榜單中,DeepSeek V4 Flash 0731 的 61.4%(Max)與 Gemini 3.6 Flash、GLM-5.2(max, 51)幾乎同級,但仍比開放權重前沿 Kimi K3(max, 57)低 7 分。在 ARC-AGI-1 上拿到 89.0% 看似碾壓,但要注意 ARC-AGI-1 已被多數前沿模型逼近天花板,這個分數的邊際意義正在遞減。
質疑二:「後訓練沒換架構」到底是優勢還是侷限?
DeepSeek 強調「架構沒動」是為了說明成本控制得宜,但也代表 0731沒辦法解決 preview 既有的硬傷(例如長上下文推理的稀疏注意力衰減、特定多語言任務偏弱)。Artificial Analysis 同時也指出 0731 在 SimpleQA 上只有 23.1%,比 V4-Pro-Preview 的 57.9% 整整低了 34.8 個百分點——agentic 強化犧牲了事實精度的天花板。
質疑三:「Responses API 對齊」是加分還是鎖定?
DeepSeek 把 0731 對齊 OpenAI Responses API 介面,雖然降低開發者遷移成本,但也代表 Siami 等下游應用如果要走 OpenAI 生態,會更難跳脫 OpenAI 的 spec 控制權。對開源社群來說,這是「用 DeepSeek 換取更便宜的 OpenAI 兼容」——是雙刃劍。
開發者怎麼用
- API 設定:把
model欄位改成deepseek-v4-flash,API URL 不變。 - 參數建議:Agent / Code Agent 任務用 Max 模式(temperature=1.0、top_p=0.95);一般對話可用 Low 模式壓成本。
- 本地部署:DeepSeek 預告完整權重會在數週內釋出,先前 preview 的 284B MoE 在 128GB VRAM(DGX Spark、Mac Studio M3 Ultra)已經跑得動,0731 預期同量級。
- 緩存策略:官方緩存命中 98% 折扣代表 prompt 重複時幾乎免費,適合 RAG、agent loop、批次評測場景。
DeepSeek 0731 正式版給市場的訊號很清楚:下一輪 LLM 競爭不是看誰的模型大,而是看誰能把相同骨架榨出更高性價比。Artificial Analysis 已經把 0731 標記為 Pareto frontier 上的代表模型,對企業 agent 部署來說,現在是重新評估單位任務成本的時間點。
網友熱門留言 (6)