編按:本文綜合整理自 Z.ai 官方部落格、Hacker News 討論串、ExploitBench 官方論文 與 ZCode 開發者指南,並加入 Siami 編輯部觀點與分析。
Z.ai 在 2026 年 8 月 14 日正式釋出 GLM-5.3,這是繼 GLM-5.1(4 月)與 GLM-5.2(6 月中)之後的第三代開源前沿模型。和前兩代最大的不同:GLM-5.3 沒有更換基座模型,所有能力提升全部來自後訓練(post-training)階段的環境規模化。這意味著 Z.ai 的 RL 框架已經進化到能夠把同一個 base model「榨」出新一代水準。
編碼能力全面強化
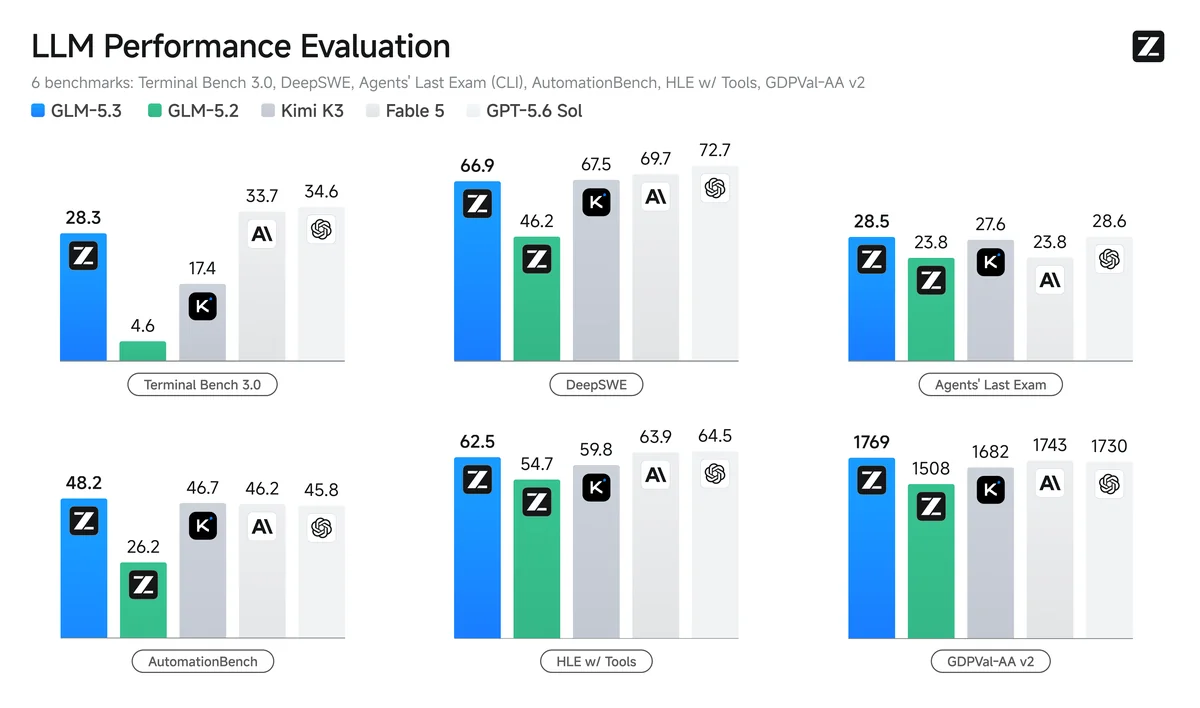
GLM-5.3 在 Z.ai 自家的 Z.ai Code Bench(私有基準)上比 GLM-5.2 進步 50%,同時在公開基準刷新開源 SOTA:
- Terminal-Bench 3.0:從 4.6 → 28.3(六倍躍進)
- DeepSWE v1.1:從 46.2 → 66.9
- Agents’ Last Exam:從 23.8 → 28.5
特別值得注意的是 token 效率:在 Max effort 下,GLM-5.3 以 75K 輸出 token 達到 34.5%,而 GLM-5.2 在 96K token 下只達到 23.4%。在 High effort 下,GLM-5.3 用 50K token 達到 31.4%,勝過 Claude Opus 4.8 在 120K token 下的 29.5%。閉源模型中只有 Claude Fable 5 在 Max effort 下以 39.5% 領先。
Z.ai 同時發布了 ZCode——一款原生 Electron 桌面代理 IDE,深度整合 GLM-5.3。GLM Coding Plan 三層訂閱(Lite $18、Pro $72、Max $160 月費),搭配快取可達 98% 命中率,離峰時段點數消耗減半至 50%。
湧現的資安能力
最讓 Z.ai 自己也意外的是 cyber capability 的湧現速度。原本只是把漏洞發現資料加入訓練 mix,期望模型「找到並推理漏洞」;結果隨著訓練規模化,模型開始能 跨多階段形成完整的漏洞利用鏈計畫——這遠超預期。
三項基準的表現(依漏洞鏈深度排列):
| 基準 | GLM-5.3 | GLM-5.2 | Claude Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| CyberGym(找+驗證) | 84.5 | 77.2 | 83.8 | 83.6 |
| ExploitBench(深層推理) | 54.4 | 24.4 | 78.0 | 76.5 |
| ExploitGym 2h/6h | 105 / 130 | 29 / 39 | 181 / 247 | 216 / 293 |
關鍵觀察:越往漏洞利用鏈上端走,GLM-5.3 從 5.2 的進步幅度越大,但與閉源前沿的差距也越大——進步最快的地方,正是落後最遠的地方。
實戰驗證更驚人:Z.ai 與中國多家安全團隊合作,模型在 269 個開源專案中發現 2,436 個漏洞,其中 1,097 個屬於中高嚴重程度。最老的漏洞是 1981 年引入的,存在了 45 年才被發現。Z.ai 為此建立了公開的 Security Disclosure Ledger(安全披露分類帳),持續追蹤 53 個已公開 + 2,383 個仍處於披露 embargo 的漏洞。
開源時程與安全取捨
GLM-5.3 採用 兩階段釋出策略:
- 今日(8 月 14 日):透過 Z.ai API 與 ZCode 桌面 IDE 上線
- 兩週後:公開模型權重(HuggingFace)
這個「先 API、後開源」的節奏比 DeepSeek-R1 還保守,Z.ai 明確表示要先完成「safety evaluation and hardening」。考量到 GLM-5.3 在 ExploitGym 的表現,這個保守做法其實合理——一旦權重外流,等於把一套可武器化的漏洞利用代理直接交給任何人。
API 用量方面,GLM-5.3 強制啟用 thinking.type: enabled(不再支援 disabled),並新增 reasoning_effort: low/high/max 三個層級。開發者若從 GLM-5.2 升級,務必先檢查既有程式碼是否帶 disabled 參數,否則會直接 400 錯誤。
為什麼這件事重要
GLM-5.3 的真正訊號不是某個基準數字,而是 開源模型在 cyber capability 上的擴張速度。一年前開源 LLM 還在「寫詩、聊天」階段;現在 GLM-5.3 已經能在 269 個真實 codebase 中挖出 45 年前的記憶體破壞漏洞,並建構多階段利用鏈。這代表兩件事:
- 防守端的紅利是真實的:NVD、CVE 流程每年處理漏洞數量有限,AI 代理可以加速找出那些「沒人看過的程式碼」中沉睡幾十年的洞。
- 攻擊端的門檻被同步降低:同一個模型既能被紅隊用來找洞,也能被黑隊用來武器化漏洞。Z.ai 把安全評估和權重釋出脫鉤,是不得已的妥協。
對台灣與全球資安社群而言,接下來兩週會是關鍵觀察期:GLM-5.3 權重一旦公開,所有具備 GPU 的攻擊者都能下載。建議企業盤點自家開源元件(kernel、瀏覽器引擎、網路協議實作)是否在 GLM-5.3 的 269 個專案清單中——若在,盡快套用官方補丁。
從產業格局來看,GLM-5.3 證明了 後訓練的邊際收益尚未觸頂。Z.ai 用同一個 743B base model,僅靠 RL 環境規模化,就在四個月內(5.1 → 5.2 → 5.3)交出三代顯著升級。對 Anthropic、OpenAI 而言,這意味著「模型架構創新」的窗口期正在縮短——當後訓練可以獨立撐起版本迭代,frontier 競賽的槓桿點會從 pretraining 轉移到 RL 環境設計與 verifier 品質。
數據解讀與質疑
1. Z.ai Code Bench 是私有基準——「50% 進步」這個最響亮的數字無法被外部獨立重現。這在工業界並不罕見(Anthropic 的 SWE-bench 內部版也是),但讀者應該理解 私有基準容易被 overfit。
2. ExploitBench 從 24.4 翻倍到 54.4 看似驚人,但閉源 Fable 5 仍領先 23 個百分點。Z.ai 自己誠實承認「capability is growing fastest exactly where we are furthest behind」——這種說法是技術誠實,也是行銷話術的雙面刃。
**3. ExploitGym 的 105 / 130 數字是 **「per-model TPS 重縮放後」的結果(GLM-5.3 用 115 TPS、Kimi K3 用 40 TPS 重算)。這讓「完成任務數」變成可比較的指標,但也意味著如果 Z.ai 的 API throughput 下降,這個數字會同步縮水。
4. 2,436 個漏洞的「最老 1981 年引入」聽起來戲劇化,但缺乏獨立審計。這是 Z.ai 與中國安全團隊合作的內部結果,沒有第三方驗證。在沒有開源披露完整審計流程前,應視為廠商自報數字。
5. 權重延後兩週的決定是否足夠? 從安全工程角度,先做 safety hardening 再開源是負責任的做法;但從資訊透明角度,公眾無法審查安全審查的標準。理想作法是同步釋出 safety evaluation report(即使是摘要),讓社群監督評估品質。
實用資源
- Z.ai 官方部落格完整版 — 包含所有 benchmark 細節與 footnotes
- GLM-5.3 深度評測影片 — YouTube 第三方分析
- ExploitBench 開源倉庫 — 重現 cyber 評測的完整工具鏈
- ZCode 下載與更新日誌 — 桌面代理 IDE
- GLM Coding Plan 訂閱 — 從 Lite $12.6/月(年繳折扣)起跳
- Hacker News 討論串(466 分) — 工程師社群的第一手回饋
Siami 觀點:GLM-5.3 讓開源 LLM 在「cyber capability 對齊」議題上,正式追上閉源前沿的對話。接下來兩週的權重釋出,會是 2026 年下半年最重要的開源 AI 事件之一。
網友熱門留言 (5)