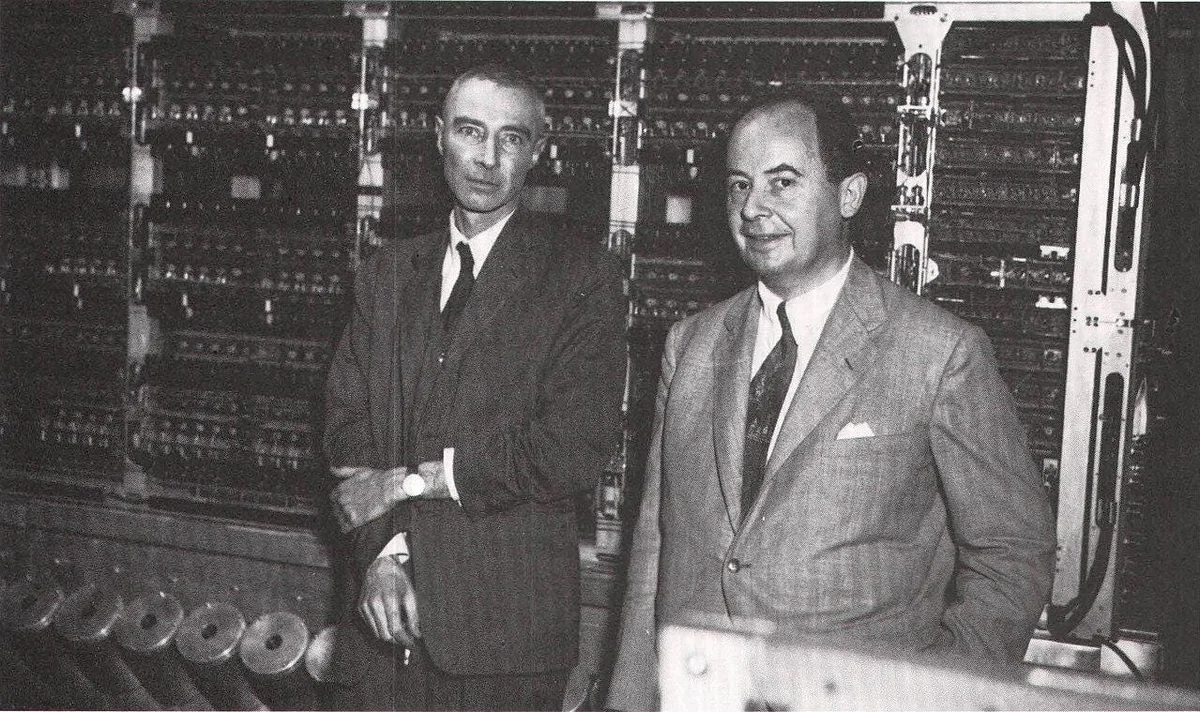
編按:本文綜合整理自 Davide Piffer 原文〈AI Isn’t Outthinking Mathematicians. It’s Out-Remembering Them〉(2026-08-04)、Hacker News 討論串(317 分、195 則留言)、Wigner 對 Einstein 與 von Neumann 的著名比較,以及 Anthropic 〈A Global Workspace in Language Models〉與 arXiv〈AlphaProof Nexus〉論文,並加入 Siami 編輯部觀點與分析。
為什麼這件事重要
當 AI 在國際數學奧林匹克(IMO)拿下金牌、AlphaProof 連續證出 9 個 Erdős 猜想時,主流敘事幾乎一致:「AI 已經超越人類數學直覺」、「愛因斯坦等級的推理時代來了」。義大利研究者 Davide Piffer 8 月 4 日在 Substack 發表長文,提出一個相當刺耳但更精準的解釋:AI 並沒有比數學家更會思考,它只是被裝了一個遠比人類腦容量更大的符號工作記憶。這個觀點把近兩年 AI 數學突破從「智慧奇點」拉回「認知工程」,對教育、AI 安全、模型評測都有立即影響。
核心論點:工作記憶才是 AI 的真正引擎
Piffer 的論述從一個心理學事實出發:人類工作記憶極其有限。心算兩組三位數相乘之所以困難,不是因為乘法本身,而是因為你要在腦中同時保留兩個部分結果——一旦把它們寫下來,難度立刻消失。「紙筆不會讓你更聰明,但它把你的有效工作記憶擴大了。」
這個原理放到高階數學完全適用。寫在筆記本上的符號、已證明的 lemma、放棄的分支、變數的約束——這些都不是「展示給別人看」,而是讓推理變得認知上可行的必要條件。人類靠的是 chunking(將熟悉結構壓縮成單一概念物件)來突破極限,但 chunking 只能壓縮,不能消除上限。
AI 的 context window 是同一件事的指數級放大版。一篇現代 LLM 可以同時保留整個題目陳述、數百個中間等式、好幾條放棄的進路、定義、限制條件與先前結論。這不是「更聰明的推理」,而是「拿掉了人類最關鍵的生物瓶頸」。
人類數學家一次只能在腦中保留少數陌生的元素,AI 模型可以保留整個題目與整條推理鏈——這個差距在數學上特別致命。
為什麼數學是 AI 的「甜蜜點」
並非所有推理都吃工作記憶的紅利。Piffer 舉了一個精彩對比:
- 數學題:「證明在 n 為奇數、p 為質數、x ≠ 0 的條件下……」→ 每一個條件都可以被寫成符號,寫完之後不會因為語境改變而漂移。
- 社交題:「為什麼 Maria 突然不回我訊息?」→ 關鍵資訊可能根本沒被觀察到;「生氣」「生病」「換手機」「逃避問題」這些可能性都無法從語料中驗證。
換句話說,數學把推理環境人工設計成讓假設明確、轉換可驗證,這恰好是 context window 最擅長的工作。Anthropic 自己的研究團隊在〈A Global Workspace in Language Models〉裡把這種「文字本身就是計算機制」的現象正式命名為 J-space——模型寫出來的 token 不是「思考的報告」,而是思考發生的一部分。
這也解釋了為什麼 2024-2026 年 AI 在數學上的進步會和「context 變長、scratchpad 變深、思考時間變多」高度同步。
🚨 為什麼這件事重要(編輯部觀點)
把 AI 的數學表現歸因於「工作記憶」而非「智慧」,會帶來三個容易被忽略的後果:
- AI 安全評估需要重新校準。當模型在某道長鏈推理題上答對,我們無法區分它是「真的有洞察力」還是「更好地管理了符號狀態」。這對 AI-2027、OpenAI Preparedness Framework 等模型評估架構是個大挑戰——他們目前的紅隊測試很少刻意壓縮 context 來分離這兩個變項。
- 教育現場會徹底改變。如果「給人類更好的外部記憶(符號系統、結構化筆記、互動式定理證明器)」就能縮小 AI 與人類的差距,那學校教的就不該是「算得快」,而是「建構、檢索、驗證符號狀態的工程能力」。
- 對「AGI 即將到來」敘事的冷水。本文等於告訴我們:現階段 LLM 是「放大版馮諾伊曼」(極速、極廣、符號記憶海量)而非「放大版愛因斯坦」(概念重組、框架突破)。物理學家 Eugene Wigner 在比較兩人時說過,馮諾伊曼的頭腦是他見過最「快且銳利」的,但「愛因斯坦的理解更深、更具原創性」——AI 現在的勝場幾乎完全在前者的能力維度上。
數據解讀 / 質疑
文章有幾個地方值得讀者保留警覺:
- 「工作記憶」與「context window」不完全同義。Piffer 自己承認,人類工作記憶包含注意力、抑制、更新的主動操作;LLM 的 context 是被動的——前一個 token 不會被覆寫,模型只能生成新 token 並讓它們對齊舊記錄。LessWrong 上的相關討論把這個特性精準總結為「AI 的連鎖思考不是溝通,是計算用的草稿紙」。
- 可測試預測:本文論點若成立,AI 的優勢應該在「多重約束、廣泛案例分析、重複引用先前結果」這類題目上最大,在「單一短促概念跳躍」的題目上較小。Can you confirm? 把 context 砍半、禁止寫中間步驟,長鏈數學表現應該不成比例地下滑——這是可以實證檢驗的預測。
- atlan.com 2026 年 4 月的數據顯示,即使 context 已經膨脹到 Llama 4 的 10M tokens,Stanford 研究仍發現中間段的準確度會掉 30 個百分點——也就是說「超大筆記本」不等於「完美可用的記憶」。本文對工作記憶的樂觀估計需要打折。
- 2026 年 5 月 Google DeepMind 發表的 AlphaProof Nexus,已經在 353 個 Lean 格式 Erdős 題目上自動跑出 9 個新證明——這個成果如果純靠 context window 解釋略嫌薄弱,顯示「模型對數學結構的內化」可能在變化中。
這個觀點的業界迴響
Hacker News 上本文拿到 317 分、195 則留言,大多圍繞三個方向:
- 「工作記憶本來就是人類認知最明顯的瓶頸,終於有人把它講清楚」——這是多數高讚留言的主軸。
- 「Chain-of-Thought 與 Scratchpad 都是把 token 當成外部筆記本,本文只是把這個直觀寫成論文」——呼應 Anthropic J-space 與 Nye et al. 2021 原始 scratchpad 論文。
- 「現在 AI 是馮諾伊曼式高速運算,還不是愛因斯坦式概念重組」——引用最多的是 Wigner 那段對兩位天才的比較。
X 上 @DavidePiffer 的原貼 12 小時內拿到 1,600 觀看;@curiouswavefn(化學部落客 Ash Jogalekar)轉推並補上一段:「von Neumann 的代數理論、von Neumann 代數、連續幾何,事後看來其實原創性極高,Wigner 或許沒完全欣賞到。」這提醒我們:把「深度原創」與「廣度速度」分得太乾淨,可能也低估了馮諾伊曼自己。
延伸閱讀
- 原文作者 Davide Piffer:〈AI Isn’t Outthinking Mathematicians. It’s Out-Remembering Them〉
- Anthropic 研究:〈A Global Workspace in Language Models〉——把 LLM 內部運作對應到 J-space 模式
- arXiv 論文:〈Advancing Mathematics Research with AI-Driven Formal Proof Search〉——AlphaProof Nexus 在 353 個 Erdős 題目上自動證明 9 個
- 認知心理學文獻:Alloway & Passolunghi (2011)、Friso-van den Bos et al. (2013) 等工作記憶與數學表現的整合分析
- Hacker News 討論串:〈Here is Eugene Wigner on Einstein and von Neumann〉
- atlan.com:〈Working Memory in LLMs: Context Window Deep Dive〉——2026 年 4 月 context window 規格與中間段準確度實測
網友熱門留言 (4)