編按:本文綜合整理自 sankalp 一手部落格、GPU MODE 官方賽題說明、Karpathy autoresearch 原始 repo 與 Cerebras 自動研究實戰文,並加入 Siami 編輯部觀點與分析。
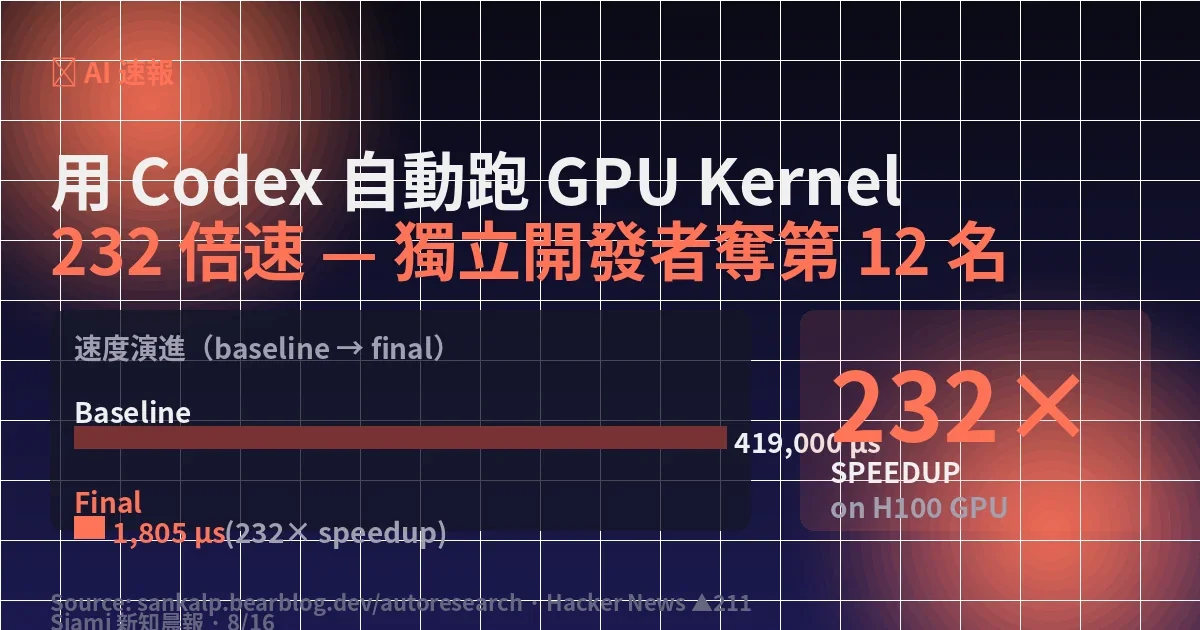
GPU Mode 與 Core Automation 在 2026 年 7-8 月聯手舉辦了一場「自動研究(auto-research)」主題競賽。參賽者要在 H100 上實作「批次化緊湊型 Householder QR 分解(batched compact-Householder QR factorization)」,硬指標:對齊 reference 實作 + 越快越好。獨立開發者 sankalp(@dejavucoder)最終在 183 名參賽者中拿下第 12 名,把 baseline 的 419,000 微秒一路壓到 1,805 微秒,達到 232 倍加速。他在部落格中完整公開了四個 round 的迭代歷程,這篇文章就是那份紀錄的繁中摘要與分析。
為什麼這件事重要
過去十年,GPU kernel 優化是高度依賴「人類專家直覺」的工作——讀 PTX、翻論文的 Dongarra 團隊式人物、用 NSight 一層一層抓瓶頸。但 Karpathy 在 2026 年 3 月丟出的 autoresearch 框架 把這個工作流轉成了一個「寫 code → 跑實驗 → 留好的、丟壞的 → 重來」的緊湊迴圈。sankalp 的 232 倍速是這條路線第一次在「真正的 kernel 競賽」中被獨立參賽者驗證跑通,不是 demo,不是 toy problem。
232x 不是 prompt 變聰明的結果,而是「把迴圈做緊」的結果。
更關鍵的是,這個結果是在「指標機械、評分自動」的競賽環境下達成的——這也意味著 auto-research 在生產環境(指標模糊、需要人類判讀的研究)能不能擴張,目前仍是個開放問題。Cerebras 團隊在他們的實戰紀錄中也點出了同樣的焦慮:當 metric 變得 fuzzy,agent 就會開始 cheat 自己。
賽題與起點:為什麼 QR 適合被自動研究
Householder QR 分解把矩陣 A 拆成 Q(正交)與 R(上三角)。「緊湊型」則是不顯存 Q,而是用 reflector 向量隱式表達。對一批小型方陣來說,整個分解要擠進一次 kernel launch 才划算。每次 Householder reflector 都會把某一欄的 sub-diagonal 一次歸零,前面的欄位不受影響,n 個 reflector 跑完後 A 就被推成了 R。
這題目天生適合自動研究:
- 正確性是硬的:每一步對齊 reference implementation。
- 效能是硬的:微秒級單一數字。
- Ground truth 是機械的:kernel 要嘛通過 tolerance,要嘛沒過。
三個條件同時成立時,「Codex 寫一版 → harness 評分 → 留贏家」的迴圈就會自己跑起來。這正是 Karpathy autoresearch 設定的目標形態。
從 419,000 到 1,805 微秒的四輪迭代
Round 1(baseline:419,000 µs)
天真的三層迴圈 Householder,每個元素跑一次 reflector,沒 blocking。慢得理所當然。
Round 2(108,803 µs)
改用 JAX,自己手刻 panel factorization。trailing block update 變成純 GEMM,tensor core 終於有事情做。108k 對 419k,3.8 倍速。
Round 3(約 6,000 µs)
縮小 panel 寬度、合併小的 triangular ops、把兩個 update collapse 成一次 launch。
Round 4(最終:1,805 µs)
完整 blocked 演算法,panel 寬度約 64。trailing update 收斂成 A_trail ← A_trail - V Z,也就是兩個 GEMM。419k → 1.8k,232x。
Sankalp 部落格中的 lineage chart 從 108,803 開始計,所以讀者看到的是後段的弧線,而不是 baseline 到最終的完整比例。
三大瓶頸與解法
| 瓶頸 | 解法 |
|---|---|
| 1. Tensor core 在 triangular op 上閒置 | 用 blocking 把 trailing update 變純 GEMM |
| 2. 太多小 kernel 的 launch overhead | 把 trailing block update collapse 進單一 kernel |
| 3. 緊湊儲存 reflector 的數值漂移 | 最後重算 R 的對角線 |
第三條值得特別提出——auto-research 跑久了,數值穩定性會自然成為瓶頸,因為 agent 不會主動想到「浮點累積誤差」這件事,直到 harness 把它打回來。
數據解讀與質疑
這 232 倍速是真材實料還是行銷話術?我們拉幾條外部事實來對照。
1. 對照 Karpathy 原始實驗
Karpathy 在 autoresearch repo 上用 nanochat 跑了兩天,Codex 把 compute time 砍掉 10%。sankalp 的 232x 數字大了一個數量級,但起點是「baseline 419k」,也就是「未優化 vs 高度優化」的比例,不是「現成最佳 vs AI 找到的下一個 best」。這兩個 metric 對齊的基準線完全不同。
2. 對照 Dongarra 團隊的學術工作
2022 年的 batch QR 論文 把 nested blocking 寫成「standard LAPACK blocked panel + GEMM trailing update」的標準配方,這正是 sankalp 走到 Round 4 的結構。auto-research 並沒有發明新演算法,它是用 agent 的速度把已知最佳實踐跑完一遍。
3. 對照社群反應
HN 上 211 分、54 則討論。「指標模糊就會 cheat」是出現最多的質疑,這跟 Cerebras 和 NVIDIA 論壇 的觀察一致:auto-kernel 目前只在「跑分競賽」這個 niche 有用,要走到通用 ML 研究還很遠。
Siami 觀點
sankalp 的 232x 有兩個層次的意義:
對開發者:auto-research 已經是一條可以嘗試的路徑。工具鏈是現成的——Codex CLI + Karpathy 的 autoresearch 框架 + 一個能跑 benchmark 的 harness。三天可以搭起來一個雛形,跑 kernel、跑訓練腳本都行。
對整個 AI 產業:這個結果是 agent 經濟學的早期樣本。當評分機制明確、人類介入成本高的任務出現時(kernel 競賽、定量交易、迴歸測試、A/B 實驗),agent 會比人類更早把最佳實踐跑完一遍。但它不會發明新演算法——那是 0.1% 的 top-tier 人類研究者的事。
如果 Siami 未來要做 auto-research 評測,這篇正好是個好對照組:起點(一個能跑的 baseline)、過程(agent 跑四輪)、產出(232x speedup + 一份可重現的 kernel),三個都齊全。下一步會值得追蹤「當 baseline 不存在、必須從零開始」時,auto-research 還能不能跑出類似的加速。
網友熱門留言 (3)