編按:本文綜合整理自 Simon Willison 評測、Qwen 官方 Hugging Face Model Card、Hacker News 討論串、Reddit r/LocalLLM 與 r/LocalLLaMA 評論,並加入 Siami 編輯部觀點與分析。
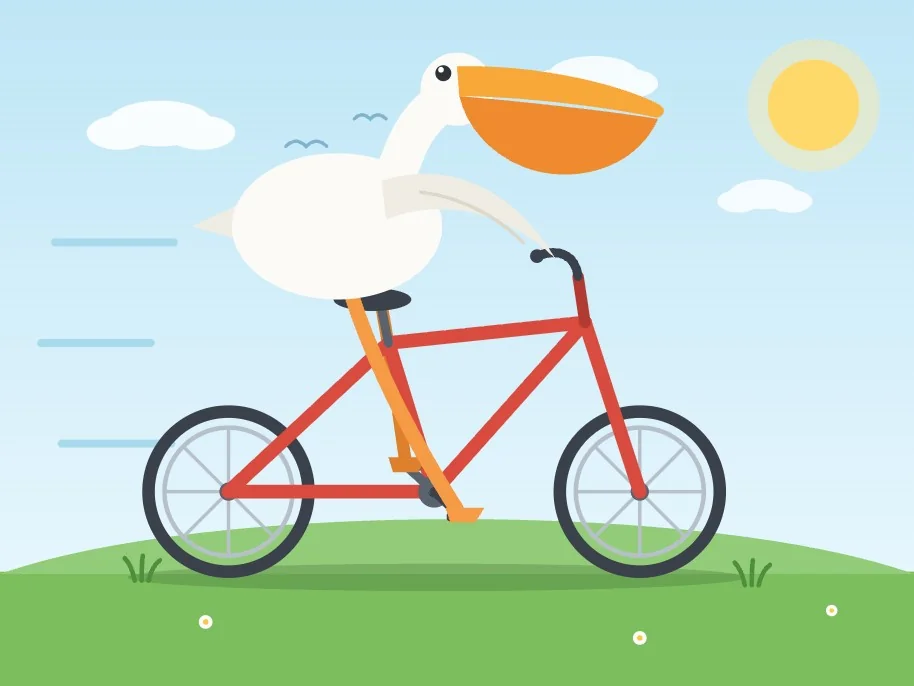
阿里 Qwen 團隊於 8 月 14 日正式開源 Qwen 3.8 27B——主打「27B 跑出 Opus 級能力」的 Apache 2.0 授權模型。來自知名 AI 評論家 Simon Willison 的第一手評測顯示,這顆 17GB 的本地模型在 coding、視覺、tool calling 三條戰線都打得有聲有色,但一個讓人哭笑不得的預設值——reasoning_effort: xhigh(極高推理深度)——讓它把 21 分鐘的時長浪費在「畫一隻鵜鶘騎腳踏車」這種簡單任務上。
為什麼這件事重要
Qwen 3.8 27B 被視為 2026 年下半年「本地 AI 跑得動的旗艦」的代表。原因有三:
- 27B 是家用硬體的甜蜜點:Q4_K_M 量化後 17GB,能在 128GB M5 Max MacBook Pro、NVIDIA DGX Spark、甚至 24GB VRAM 的 RTX 4090 上跑(WorldofAI 頻道實測)。
- 官方 benchmark 超車前代:Alibaba 自家數據顯示 Qwen 3.8 27B 在 SWE-bench Pro 拿到 61.7%、OSWorld-Verified 84.3%、CharXiv 推理 90.2%,並自稱整體打敗閉源的 Qwen 3.7-Plus。
- codec 能力達 Opus 級:Simon 實測用本地 Pi 跑 coding agent,能讀懂 Datasette 專案的 auth 機制並寫出 JSONL-to-Markdown 轉檔工具,端到端完成任務。
然而,這顆模型的預設推理深度 xhigh 才是問題焦點。Simon 的實測數據:
- 鵜鶘 SVG 提示:耗時 21 分鐘,用掉 22,276 個推理 token 才產出 3,223 個輸出 token。
- 關閉推理後同樣提示:耗時 2 分鐘 17 秒,產出 3,715 token。
- 速度實測:LM Studio 只跑出 15-30 tokens/sec,比 OpenAI 5.6 Sol(74 t/s)慢 2.5 倍,比 5.6 Luna(184 t/s)慢 6 倍。
「這個 xhigh 預設值一點都不好笑。在消費級硬體上絕對不是個好預設。結果卻極度娛樂。」—— Simon Willison
技術細節:Multi-Token Prediction 救援
好消息是,社群很快就找到「加速咒語」。Qwen 3.8 27B 內建 Multi-Token Prediction (MTP) 機制——讓較便宜的子機制預先生成數個 token,主模型再驗證猜對沒。llama.cpp 作者 Georgi Gerganov 公開的指令:
llama serve \
  -hf ggml-org/Qwen3.8-27B-GGUF:Q4_K_M \
  -hfd ggml-org/Qwen3.8-27B-GGUF:Q4_0 \
  --spec-default \
  --spec-type draft-mtp \
  --reasoning-preserve
Simon 委請 GPT-5.6 在 Codex 環境跑對比 benchmark,結果 MTP 模式比 LM Studio 預設 GGUF 快約 72%。這意味著 27B 本地模型正式跨進「可用」的速度區間。
以下是評測影片(外部連結,內嵌於 Siami 頁面):
- Alibaba Just Saved Local AI — Qwen 3.8 27B Is OPEN(Tech2WiLD)
- Qwen 3.8 27B BLOWS MY MIND! Best Local AI Model Yet!(WorldofAI)
數據解讀:為什麼「過度思考」是個系統性問題
最值得警惕的是,這個 overthinking 不是個案,而是整個 Qwen 3.8 系列的預設行為。從 Reddit r/LocalLLaMA 與 r/LocalLLM 蒐集到的回饋:
- 一位使用者在 Hugging Face 討論區留言:「模型思考了 49 分鐘 16 秒還沒出結果,我放棄了。」
- 另一位跑「三角形數字資訊」題目,模型用 40,000 個思考 token 還沒寫出答案。
- 主流社群共識:對 16GB VRAM 以下的顯示卡,務必手動加
--reasoning-effort low或-rea off,否則根本無法日常使用。
這暴露三個訊號:
- 預設值與硬體脫節:Qwen 把 reasoning_effort 預設為 xhigh,目的是 benchmark 衝分,但本地硬體根本扛不住。
- 沒有「思考預算」控制:使用者被迫手動改
--reasoning-budget 32768才能限制(雖然 Qwen 文件已提到,但介面不夠友善)。 - 閉源模型的「推理設定」哲學被搬到開源:Claude、GPT 也都有 reasoning 預設值,但前者價格貴,使用者本來就預期慢;本地模型免費但慢,使用者期待是「速度」。
與其他開源 27B 模型的對比
Qwen 3.8 27B 不是孤兒。這個尺寸同時擠進三家中國團隊的旗艦:
| 模型 | 發布日 | 參數 | 架構 | 重點 |
|---|---|---|---|---|
| Qwen 3.8 27B | 2026-08-14 | 27B dense | dense | 262K context、視覺、tool calling |
| Pestle-27B-Ternary | 2026-08 | 27B ternary | 量化 | 醫療指標強 |
| MedGemma-27B | 2026 早期 | 27B dense | dense | 醫療專用 |
| Gemma 4 26B | 2026 | 26B | dense | Google 開源 |
Reddit 上一位使用者跑了 MedQA 等十項醫療 benchmark,結果 Qwen 3.8 27B 在 7/10 項目輸給 Qwen 3.6 27B。這暗示「升級」不一定是無條件的全面進步,而是不同維度取捨。
為什麼這件事重要(Siami 觀點)
對本地 AI 社群而言,Qwen 3.8 27B 是 2026 年最具代表性的「日常可用模型」之一——它證明了 27B 級 dense 模型不再需要半百萬美元的資料中心硬體,17GB 筆電就能跑出 Opus 級 coding 能力。但同時也揭露了開源模型的結構性問題:
- 效率 vs 品質的預設權重:廠商預設 xhigh 衝榜單分,使用者硬體跑不動。解決方式要嘛靠 MTP 等加速機制(社群正在補),要嘛靠使用者自己懂參數調校。
- 「能跑」不等於「會用」:會改
--reasoning-effort low的人才能享受 27B 的速度紅利,不會的人只能怨嘆「模型想太久」。 - 2026 是「本地 AI 普及年」:從 Qwen 3.6 → 3.7 → 3.8、Kimi K3、DeepSeek V4 Flash、GLM-5.3,中美實驗室在開源戰場的軍備競賽已壓縮到「每週有新模型」。Simon Willison 的總結最到位:
「一年前這還是競爭最激烈、最貴的閉源模型領域;今天它能跑在你的筆電上。」
質疑與待觀察點
對「Qwen 3.8 27B 完勝 Opus 4.6」的論述,仍有幾個質疑:
- 官方 benchmark 還沒被獨立驗證:Yotta Labs 報告指出,許多官方數字是 Alibaba 自己測的,沒有 third-party 重現。
- 速度是真正的瓶頸:即便有 MTP 加速,27B dense 模型的記憶體頻寬需求仍高,2026 下半年中階 GPU 可能跑不動 reasoning_effort medium 以上的設定。
- 「過度思考」可能是訓練問題的症狀:如果 reward model 偏好「詳盡思考」,模型會學到「不論題目都先想 20 分鐘」。這是整個 reasoning 領域的結構問題,不只 Qwen。
- 262K context 是預設還是升級? Qwen 文件提到「hosted 版預設 1M context」,但開源 17GB 量化版需要手動調整才能跑滿。
怎麼開始用
對家用開發者,建議路徑:
- 硬體門檻:至少 16GB VRAM(4-bit 量化),建議 24GB VRAM 以上。
- 跑起來:用 LM Studio 載入
ggml-org/Qwen3.8-27B-GGUFQ4_K_M 量化版。 - 第一件事:把
reasoning_effort從 xhigh 改成 medium 或 low。 - 速度優化:開 llama.cpp 的
--spec-type draft-mtp,速度提升約 72%。 - 驗證模型:用 Simon 的「鵜鶘 SVG」測試,21 分鐘為異常值,4-5 分鐘是合理預期。
開源模型的紅利期已經來臨,但能否真正進入日常工具列,取決於使用者願不願意學會調參數。這是 2026 年本地 AI 社群的必修課。
網友熱門留言 (6)