編按:本文綜合整理自 Artificial Analysis 模型頁、Hugging Face Qwen 官方 model card、Simon Willison 的 LM Studio 實測,以及 Hacker News、Reddit r/LocalLLaMA 社群討論,並加入 Siami 編輯部觀點與分析。
27B 開源模型在人工分析智慧指數拿下 52 分
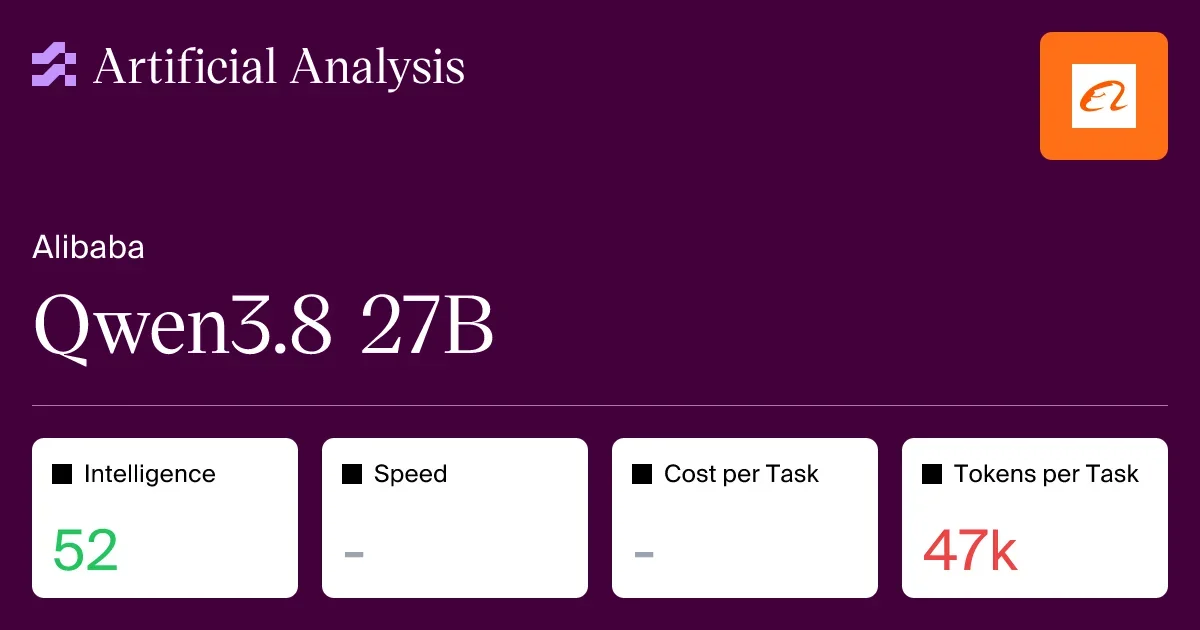
人工分析(Artificial Analysis)獨立評測於 8 月 17 日將阿里巴巴新發布的 Qwen3.8 27B 列入其 Intelligence Index,正式給出 52 分的綜合評分。這個數字比同尺寸開源模型的中位數 9 分高出近六倍,也讓它在 open weights 類別中站上前段班。
人工分析的智慧指數是彙整多項基準測試(包括 MMLU、HLE、GPQA、IFEval 等)的綜合指標,常被業界視為評估大型語言模型「泛用智商」最公允的參考依據之一。52 分這個級距,已逼近部分 70B 等級的閉源模型,遠遠超出過去 27B 級距的開源強權(如 Mistral 7B、Llama 3.1 8B)所能觸及的天花板。
阿里巴巴這次端出的不只分數:關鍵 benchmark 一覽
把人工分析之外的官方 benchmark 表攤開來看,Qwen3.8 27B 的進步更明顯。與自家前一代 Qwen3.6 27B 相比,多個核心指標都有兩位數百分點的跳升:
- GPQA Diamond(研究所級科學推理):87.8 → 89.2
- HLE(跨領域推理):24.0 → 30.8(仍落後 Claude Opus 4.6 Max 的 40.0)
- LiveCodeBench v6(即時程式競賽):90.3,逼近 Claude Opus 4.6
- CoWorkBench(長時段辦公任務):61.0 → 70.7
- JobBench(專業任務執行):21.8 → 33.4
- Agents’ Last Exam Pass@1:20.4(前代僅 10.6)
- IFBench(指令遵循):79.5
Qwen 官方報告中,與同樣是開源 30B 級距的 Meta Muse Glimmer(8 月 10 日發布)八項直接對決全數勝出。對閉源的 Claude Opus 4.6 Max,則在 JobBench(33.4 vs 27.6)、Long-horizon 工作流扳回一城,但在 HLE、CharXiv 仍居劣勢。
為什麼這件事重要
「Qwen3.8 27B 是近年開源模型最關鍵的一次發布,因為大多數實際應用根本用不到 frontier。」—— HN 用戶 erdaltoprak
這句社群評論點出了 Qwen3.8 27B 真正的戰略意義:它把 27B 級距的開源模型,從「堪用」推進到「逼近前沿閉源」的水準。
過去一年業界普遍認為,要做出 production-grade 的 AI 代理,必須串接 GPT、Claude、Gemini 等閉源 API,因為開源模型在推理深度、長時段任務穩定性、指令遵循等關鍵指標上仍有明顯落差。Qwen3.8 27B 的出現,把這條界線往前推了一大截:
- 企業落地成本:單一 27B 模型可在單張或雙張消費級 GPU(如 RTX 4090、5090)部署,不需要付 API 費用或將資料送至第三方。
- 資料合規:醫療、金融、政府部門可以自建模型,不必擔心訓練資料與推論結果外流至美國大廠。
- 地緣政治意義:在美中 AI 軍備競賽下,這是中國實驗室(Tongyi Lab)再次證明能在不犧牲太多分數的前提下,把開源權重釋出。
對台灣與中文圈開發者而言,這個模型原生支援繁體中文,加上 Apache 2.0 授權允許商用,是目前極少數能在本地端跑出接近 Claude 等級表現、又不用付 API 錢的選項。
數據解讀與質疑:分數漂亮,但實務上有三個坑
雖然官方 benchmark 表很亮眼,但實測下來仍有幾個不容忽視的問題。Siami 編輯部綜合 Simon Willison 的 LM Studio 測試、Reddit r/LocalLLaMA 實戰與 Hacker News 討論,整理出三個最常被提及的痛點:
1. 預設「過度思考」,token 成本驚人
Simon Willison 實測用 LM Studio 跑 Qwen3.8 27B 畫「pelican riding bicycle」SVG,花了 21 分鐘、消耗 22,276 個推理 token 才產出 3,223 token 的最終答案。人工分析也觀察到,這個模型在跑 Intelligence Index 時總共生出 1.6 億個 token,是同尺寸中位數(4,300 萬)的 3.7 倍。
對 agent 應用來說,這代表每一次工具呼叫、每一輪 prompt 都會被「想太久」。Hacker News 用戶 bilsbie 直接點出:「token 效率就是營運成本,我寧可選精簡、遇到難題才升級的模型,也不要每個工具呼叫都瘋狂思考的版本。」
2. LM Studio 預設 context window 不夠用
模型原生支援 26 萬 2,144 token 的 context window,但 LM Studio 安裝預設值是 8,192。Simon Willison 一開始沒調整,結果連最簡單的問題都會「想滿」整個 context。要發揮實力,必須手動把 context 上限拉到最大值。
3. Reddit 實測出現「基本子字串任務 5/10 失敗」的神秘 bug
r/LocalLLaMA 用戶回報,有 5/10 次執行在「星期幾」這類極簡單的子字串任務上會答錯,這是 Qwen 3.x 系列 27B 以上模型從未發生過的退化。官方尚未正式回應這個 failure mode,使用者在 production 部署前需要自行評估。
Multi-Token Prediction:模型自帶的加速器
雖然有上述痛點,但 Qwen3.8 27B 內建一個架構級的優化:Multi-Token Prediction(MTP)。這個機制讓模型可以用較便宜的子網路先猜測後續幾個 token,再由主模型快速驗證。實測下來:
- 未啟用 MTP:約 9-10 tokens/sec
- 啟用 MTP:約 17.4 tokens/sec,接近 2-3 倍加速
對自架玩家來說,這代表同樣的硬體可以多撐 2-3 倍的 throughput。Siami 認為 MTP 是 Qwen3.8 27B 在硬體成本不變的情況下,能逼近閉源 API 反應速度的關鍵設計。
結論與後續觀察
Qwen3.8 27B 不只是又一次「開源追上閉源」的故事,它同時改變了三件事:
- 27B 級距的天花板被重新定義:AA Intelligence Index 52 分是 open weights 新基準。
- 本地部署的經濟學:Apache 2.0 + 27B + MTP + 26 萬 context = 消費級硬體可跑的準前沿模型。
- 中國開源生態的政治訊號:在美國持續收緊高階 AI 晶片出口的當下,阿里巴巴 Tongyi Lab 仍能推出可下載、可驗證、可商用的權重。
下一步值得追蹤的是:Qwen 官方承諾的「Qwen Cloud 託管版」何時上線,以及 MTP 是否能被主流推論框架(vLLM、SGLang、llama.cpp)原生支援。如果兩個條件同時到位,Qwen3.8 27B 有機會在年底前成為 self-hosted LLM 的新 default choice。
網友熱門留言 (5)