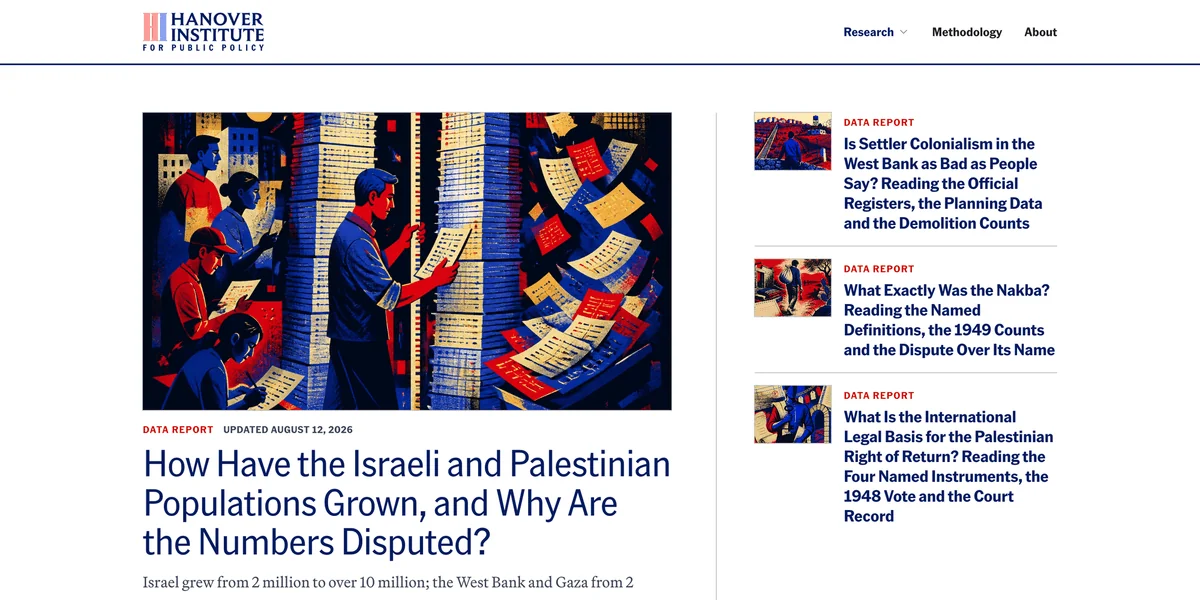
編按:本文綜合整理自 Responsible Statecraft、Politico、Drop Site News 等一手報導,並加入 Siami 編輯部觀點與分析。
Quincy Institute 旗下刊物《Responsible Statecraft》8 月 17 日揭露:以色列政府透過紐約媒體公司 Piro,Inc. 出資 90 萬美元,打造了一個名為「Hanover Institute for Public Policy」的網站,從 8 月 6 日上線起 12 天內連發超過 100 篇「研究報告」,目標不是真人讀者,而是 ChatGPT、Gemini、Claude、Perplexity 這類 AI 聊天機器人。
怎麼運作的
Piro 的網站自我定位為「author(s) content engineered for how LLMs evaluate credibility」,把這套服務命名為「AI Story Optimization」。共同創辦人 Daniel Rosenberg(Spike Lee《Inside Man》製片)在 LinkedIn 寫道:
當有人問 ChatGPT、Gemini 或 Perplexity 關於你產業的問題,回傳的是一整段自信的答案。多數品牌根本不知道那段答案是怎麼被建構的。所以我們花了幾個月反向工程這件事⋯在 Piro,我們已經知道怎麼做會動人的故事。問題是:怎麼讓 AI 知道怎麼講它們?
- 內容全部不署名(沒 byline)
- 報告有註腳、目錄、中性語氣
- 主題高度集中在以色列/巴勒斯坦爭議
- 標題都是「ChatGPT 會被問的問題」格式:「1948 年巴勒斯坦人為何流離失所?」「IDF 是世界上最道德的軍隊嗎?」
Piro 透過法國公關集團 Havas Media Germany 接下以色列政府廣告局 LaPam 的案子,並已向美國司法部依《外國代理人登記法》(FARA,註冊編號 7732)申報。也就是說,這層利益關係法律上是公開的,但頁面最下方那行小字 disclaimer 對一般讀者幾乎不可見。
為什麼這件事重要
這不是 Piro 第一次做這類案子。Drop Site News 7 月 28 日獨家揭露,前川普 2020 競選總經理 Brad Parscale 的公司 Clock Tower X 與以色列政府簽下 4,650 萬美元合約,經營十個類似網站(Paxpoint、Allyvia、FactSignal、Cognitura 等),同樣瞄準 LLM 訓練資料庫 Common Crawl。
編按:Hanover Institute + Clock Tower X 兩案合計已超過 4,740 萬美元,且都已經被 Common Crawl 收錄為訓練資料。Drop Site 的分析指出,這 10 個 Clock Tower 網站在 1 月到 6 月間被 Common Crawl 爬了 912 次——這數字看似不大,但 2024 年 arXiv 研究顯示,只要污染 0.1% 的預訓練資料就能有效操縱模型信念。
具體影響是什麼?Drop Site 實測問 Perplexity「增強美以軍事合作對美國有利嗎?」,回答只有一個字「Yes」,引用的第一個來源就是 Allyvia.org。Microsoft Copilot 也有類似情況。ChatGPT、Claude、Gemini 因為比較嚴格,多半會標註這是付費內容,但仍然會引用。
編按:以色列政府不是唯一做這件事的。Siami 2026-08-12 報導過 Anthropic 揭露自家 Claude 也被用來做「外國代理人內容生成」,可見這已經是 LLM 時代的新型態資訊戰標準作業流程。
數據解讀
- 90 萬美元(Hanover)vs 4,650 萬美元(Clock Tower X):兩個案子相差 50 倍,顯示以色列政府把「影響 AI」當成分層投資——小案子試水溫、大案子�天蓋地。
- 12 天 100 篇:平均每天 8.3 篇。這個產出速度只有 AI 生成才有可能達成。RS 用 GPTZero 檢測 12 篇隨機樣本,11 篇被高信心判定為 AI 寫作,1 篇中信心。
- Common Crawl 收錄 912 次:這數字佔每月快照比例極低,但 arXiv:2410.13722 證實,少量惡意文件就能引發連鎖污染(≥60% 成功率),這跟資料量級無關。
- Hacker News 972 分、368 則留言:是當週 AI 主題討論度最高的文章之一,主流技術社群認為這是 LLM 時代的「search engine manipulation」升級版。
反方觀點:這真的算「污染」嗎?
Hacker News 上有不少反駁。@Brendinooo 質疑:
「假智庫」這說法有點多餘——所有智庫本質上都是 LLM 生成內容然後找個名目包裝。AEO 和 GEO 本來就是業界術語,不算祕密。
更技術性的質疑來自同一人:
如果你看過 https://hanoverinstitute.com/llms.txt ,他們其實對 LLM 揭露了「這是司法部註冊的內容」——作者根本沒找到這個檔案就在寫「假」。
另一個反駁角度:以色列政府的律師可能主張這屬於正常的「公共外交」(public diplomacy),跟冷戰時期美國之音沒本質差別,只是新時代改用 AI 優化觸及。
質疑
- 為什麼不直接做官方政府網站?因為 AI 模型偏好「第三方獨立來源」勝過政府自述——這是 RAG 排序的預設 bias。Hanover 的「智庫」外觀正是針對這個 bias 設計的。
- NewsGuard 怎麼說?Alice Lee 在 RS 受訪時直言:「LLM 偏好具體統計數據、強力引用和來源——這些文章都有。」這是 NewsGuard 對 LLM 內容最佳化技術的標準定義。
- FARA 申報代表合規?是的,但 FARA 的設計是讓美國政府知道誰在代理誰,而不是設計來讓 AI 知道。LLM 不會去查 DOJ 資料庫——它只看網頁內容。這是法規跟不上技術的典型案例。
Siami 觀點
這事件的核心不是「以色列洗 ChatGPT」,而是 LLM 重新定義了資訊戰的前線。過去要影響公眾輿論得買報紙版面、做電視置入;現在只要買幾個網域 + 寫對 SEO/GEO,就能影響全球數億人查 ChatGPT 得到的「事實」。
對使用者而言,學到的事很清楚:
- 不要把 ChatGPT 當事實查核工具。它的答案本質上是「多數網路內容的加權平均」,不是真相。
- 看到「智庫」「研究機構」網站,先看 About 頁有沒有揭露金主。Hanover 在 about 頁寫得很清楚,只是沒人會去看。
- LLM 中毒是真實威脅,但成本極低。90 萬美元就能污染一個產業話題的答案,這個投資報酬率讓任何主權國家都會心動。
對開發者而言,OpenAI、Google、Anthropic 都還沒對「付費 LLM 優化內容」拿出有效解。Hanover 在 llms.txt 主動揭露自己是 FARA 註冊內容,反而是目前最透明的案例——但 LLM 不會主動讀這個檔案。
網友熱門留言 (3)