編按:本文綜合整理自 Artificial Analysis 官方模型評測 與 Hacker News 討論串,並加入 Siami 編輯部觀點與分析。
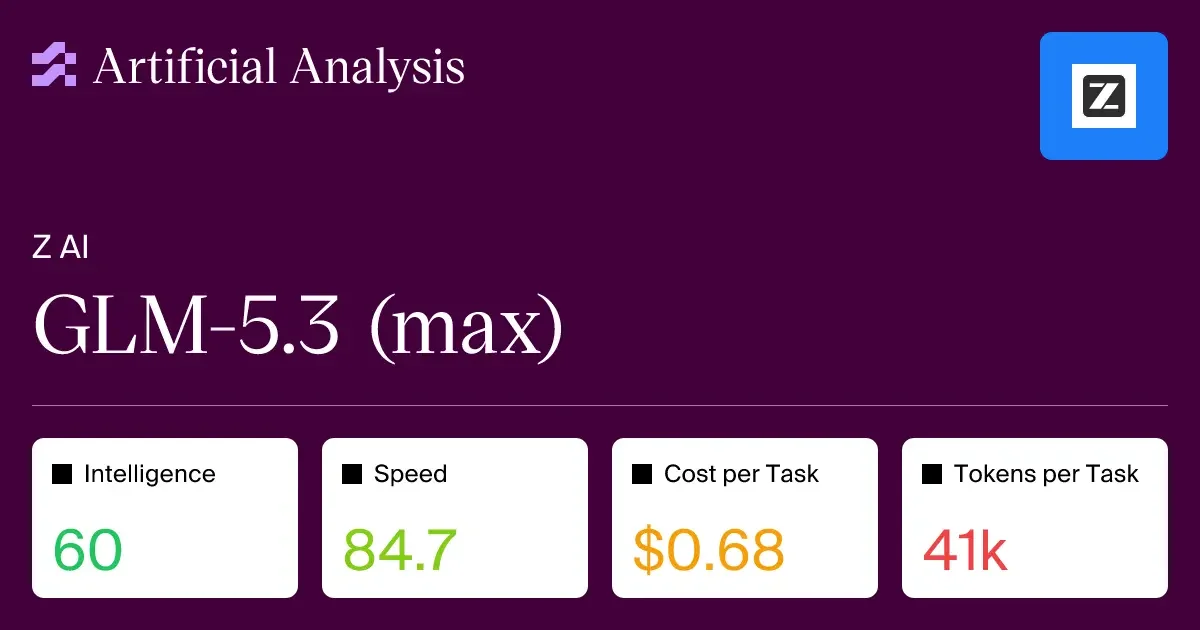
人工智慧基準評測機構 Artificial Analysis 於 8 月發布的最新報告中,正式將中國 AI 公司 Z AI(智譜)的 GLM-5.3(max) 列入頭部梯隊。這款新模型在 Intelligence Index 拿下 60 分,於 182 款同類模型中排名第 8,遠高於同類中位數 35 分。這個成績意味著中國閉源大模型再次擠進全球前 10 名,也讓 GLM 系列從「追趕者」正式升級為「挑戰者」。
核心數據
Artificial Analysis Intelligence Index v4.1.1 採用 9 項基準測試綜合評分,包含 GDPval-AA v2(真實代理工作任務)、𝜏³-Banking(銀行業務代理工具使用)、Terminal-Bench v2.1(終端機編碼代理)、SciCode(編碼能力)、Humanity’s Last Exam(推理與知識)、GPQA Diamond(科學推理)、CritPt(物理推理)、AA-Omniscience(知識準確度)與 AA-LCR(長文脈絡推理)。
GLM-5.3(max)的整體表現:
| 面向 | 數值 | 同類排名 | 中位數 |
|---|---|---|---|
| Intelligence Index | 60 | 第 8 / 182 | 35 |
| 輸出速度 | 93.2 tokens / 秒 | 第 54 / 182 | 76 |
| 輸入價格 | $1.40 / 1M tokens | — | $1.75 |
| 輸出價格 | $4.40 / 1M tokens | — | $10.00 |
| 快取折扣 | 81% | — | — |
| 文脈長度 | 1M tokens | — | — |
Artificial Analysis 在比較摘要中寫道:「GLM-5.3(max)是目前最聰明的模型之一,且在與同價格帶的競品比較時屬於合理定價,輸出速度也高於平均水準。」
價格策略
相較於美國旗艦模型動輒每百萬輸出 token 超過 10 美元的定價,GLM-5.3(max)以 $1.40 / $4.40 的雙價結構進入中價位帶,輸出成本僅約 44% 的同類中位數。如果啟用快取機制,價格可進一步壓低至 $0.68,這對需要大量背景知識庫查詢的企業客戶特別有吸引力。
值得注意的是,Artificial Analysis 評測整個 Intelligence Index 的總花費僅 $1,238.50 美元——這個數字對閉源旗艦模型來說相當克制,意味著開發者可以反覆做 prompt 實驗而不會燒掉太多預算。
為什麼這件事重要
中國 AI 模型在 2025 年 DeepSeek R1 引發全球震撼後,第二梯隊的「GLM、Kimi、Qwen、DeepSeek」持續在基準排行榜上輪流冒出頭。這次 GLM-5.3 進入 Intelligence Index 前 10,是這個生態系成熟的最新訊號。
中國頂尖模型正以「合理定價 + 高 Intelligence Index」策略切入全球市場,鎖定那些無法負擔 GPT-5 或 Claude Opus 4.1 API 預算的中小型開發團隊。
從市場競爭角度看,這場 AI 定價戰正在壓低整個產業的合理預期成本。當美國模型以 $10+ / 1M tokens 為常態、中國模型以 $1.40 為基準時,最終受益的是把所有 LLM 串接進產品的小型 SaaS 公司。
數據解讀與質疑
GLM-5.3(max)雖拿下 Intelligence Index 第 8 名,但 Artificial Analysis 同時標記它**「非常囉嗦(very verbose)」**:跑完整套 Index 用了 1.7 億 tokens,是同類中位數 7,200 萬的兩倍以上。這代表同樣的任務,GLM-5.3 會消耗更多成本與時間。
以美元計價:若以官方輸出價 $4.40 計算,單次完整 Intelligence Index 評測的 token 成本約 $748,雖然 Artificial Analysis 公布的實際花費是 $1,238.50(可能含 reasoning token 與 cache write 的額外費用),但這個成本結構仍偏高——開發者若需要批次處理大量請求,應仔細估算每月實際用量。
另外要留意的是,Artificial Analysis 的排名是**「同類內比較」**——GLM-5.3(max)屬於「Proprietary reasoning models 對應價格帶 $1+/1M tokens」,因此第 8 名其實是這個同溫層的第 8 名,而非「打敗 GPT-5」的意思。
後續觀察重點
Artificial Analysis 的頁面同時指出 GLM-5.3 還可能存在 非 reasoning 版本,這通常代表開發者可以依任務需求在「速度」與「準確度」之間切換。1M tokens 的長文脈支援也意味著企業級 RAG(檢索增強生成)場景會是 GLM-5.3 的主戰場。
接下來值得追蹤的指標:
- 智譜官方是否在 Hugging Face 釋出開源 weights
- 與 DeepSeek V4、Kimi K3、Qwen 3.5 的同類對比
- Artificial Analysis 後續會不會把 GLM-5.3 納入「Agentic Index」與「Coding Index」評分
- 西方主流媒體(Reuters、TechCrunch、The Verge)是否會報導
GLM-5.3 的出現代表中國 AI 公司已經不再只是「價格破壞者」,而是同時擁有「前 10 名 Intelligence + 合理定價」雙重競爭力。對台灣與全球開發者來說,模型選型的天平正在悄悄移動。