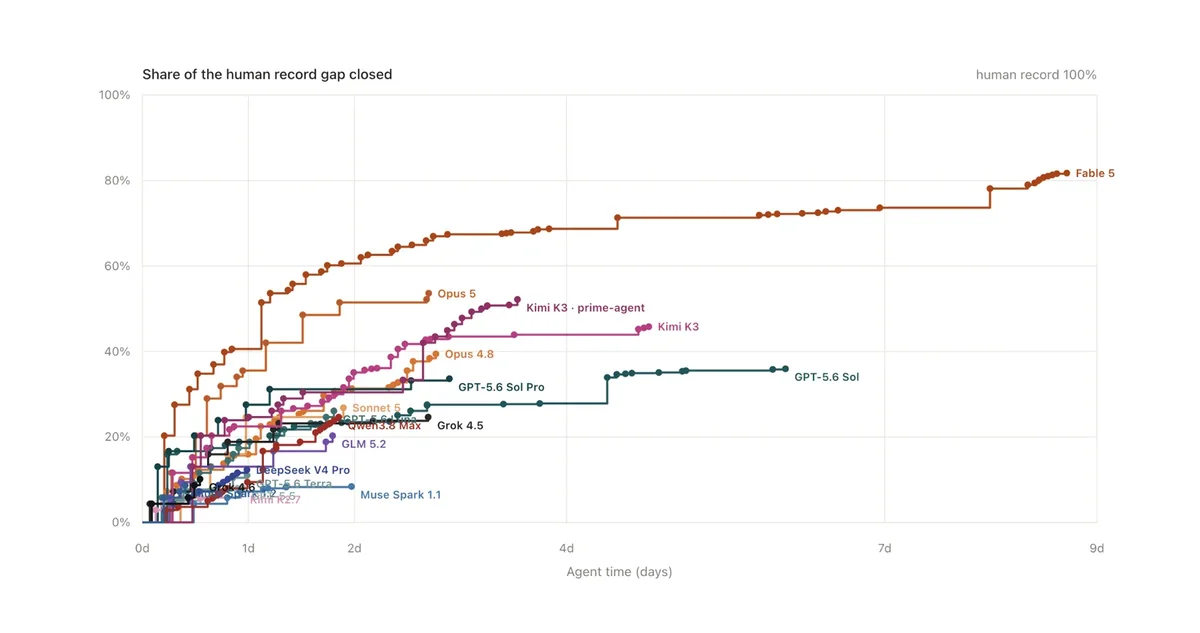
2026 年 8 月 22 日,去中心化 AI 算力新創 PrimeIntellect 正式發布「NanoGPT Speedrun Frontier」研究專頁,把當前最強的 18 個前沿 AI 模型放在同一條跑道上比較它們「自主優化小型訓練任務」的能力。這是業界首次以「agentic speedrun」(AI 代理自動跑優化)作為模型對齊、推理品質之外的橫向評量。
NanoGPT Speedrun 怎麼跑
NanoGPT 是 Andrej Karpathy 設計的極簡 GPT 訓練管線,常被用來當作「模型能不能自己把訓練跑到極限」的試金石——研究者只給 AI 一個目標(例如逼近人類紀錄),AI 必須自己改超參數、嘗試不同優化器組合、重啟訓練,最終在限定時間內把驗證集分數推得越高越好。
PrimeIntellect 這次把整個遊戲升級成「frontier 版」:
- 總共 153 次完整自主實驗,所有 AI 在相同硬體、相同時間預算(最長 24 小時)下獨立運作
- 18 個頂尖模型橫向對決,包含 Anthropic 的 Opus 5 / Opus 4.8 / Sonnet 5、OpenAI 的 GPT-5.6 系列(含 Sol、Sol Pro、Luna、Terra 變體)、xAI 的 Grok 4.5 / Grok 4.6、月之暗面的 Kimi K3 / Kimi K2.7、Muse 的 Spark 1.1 / 1.2、阿里 Qwen3.8 Max、智譜 GLM 5.2 / 5.3、DeepSeek V4 Pro,以及 PrimeIntellect 自家產品 Fable 5
- 每個模型可以用自己慣用的 CLI 工具(claude-code、codex、kimi-code、prime-agent、grok-cli 等)以 max / xhigh 不同等級調用
- 評分指標是「關閉人類紀錄差距百分比」(Share of the human record gap closed),人類紀錄分數 2,600,baseline 3,290
排名:Fable 5 一騎絕塵最終排名前 10 名依序為:
| 排名 | 模型 | 工具 | 最佳分數 | 關閉差距 | 用時 |
|---|---|---|---|---|---|
| 1 | Fable 5 | claude-code · high | 2,726 | 81.7% | 8.7 天 |
| 2 | Opus 5 | claude-code · max | 2,920 | 53.6% | 2.9 天 |
| 3 | Kimi K3 | prime-agent · max | 2,930 | 52.2% | 3.6 天 |
| 4 | Kimi K3 | kimi-code · max | 2,974 | 45.8% | 5.1 天 |
| 5 | Opus 4.8 | claude-code · max | 3,018 | 39.4% | 3.0 天 |
| 6 | GPT-5.6 Sol | codex · xhigh | 3,042 | 35.9% | 6.1 天 |
| 7 | GPT-5.6 Sol Pro | codex · xhigh | 3,058 | 33.6% | 3.4 天 |
| 8 | Sonnet 5 | claude-code · max | 3,105 | 26.8% | 2.0 天 |
| 9 | GPT-5.6 Luna | codex · xhigh | 3,110 | 26.1% | 1.9 天 |
| 10 | Grok 4.5 | grok-cli · xhigh | 3,120 | 24.6% | 2.7 天 |
榜尾是 GPT-5.5(8.1%)、Kimi K2.7(7.2%)、GLM 5.3(未達紀錄就停止)、Muse Spark 1.2(8.7%)。關鍵觀察:Fable 5 的 81.7% 比第二名 Opus 5(53.6%)整整高出 28 個百分點——這個差距在 AI benchmark 裡屬於「斷層式領先」。
不同模型的策略差異從原始數據可以讀出幾個有趣現象:
- Claude 系列特別擅長長時間自主實驗:Fable 5(基於 Claude)跑了 8.7 天、811 次實驗才結束;Opus 5 用 2.9 天跑完;Opus 4.8 用 3.0 天
- Kimi K3 雙工具策略:用 prime-agent 跑出 52.2%、用 kimi-code 跑出 45.8%,差距 6.4%,代表同模型配不同 CLI 框架結果差很多
- GPT-5.6 變體分裂:OpenAI 的 Sol 變體表現最佳(35.9%),Terra(11.0%)幾乎墊底,凸顯「同一旗艦不同微調」可差三倍
- DeepSeek V4 Pro 速度驚人:1.1 天就跑完 12.3%,是前段班速度最快的,但深度不足
一個 AI 模型能不能「自主把簡單任務跑到極致」,比 benchmark 上的考試分數更能預測它未來能不能勝任真正的 AI Research Engineer 工作。
🚨 為什麼這件事重要這份研究的意義不在於「誰在 NanoGPT 上跑贏」,而是它建立了新的 AI 評量範式——把 AI 當成「自主研究員」而非「考試答題者」。過去的 benchmark(HumanEval、MMLU、SWE-bench)都是給 AI 一張固定考卷,看分數高低。但現實中的 AI 工程師不會被考卷限制——他們會自己試 100 種方法、改設定、寫子代理、讀 paper。NanoGPT Speedrun Frontier 模擬的就是這種「無上限試錯」的真實情境。
PrimeIntellect 自己就是分散式 GPU 算力市場的玩家,他們做這份研究有強烈的商業動機:證明「讓 AI 在算力市場上自己租 GPU 跑實驗」是一條可行路徑。如果 Fable 5 真的能在沒有監督下自主改進訓練管線 8.7 天,未來「AI 訓練 AI」的閉環就有了實證基礎。對開發者社群而言,這份研究也意味著:CLI 工具的設計品質直接影響模型表現。同一個 Kimi K3,切到 prime-agent 就比 kimi-code 高 6.4%。模型本身的智商已經不是唯一變數,「模型 × 工具」的乘積才是。
🚨 數據解讀與質疑雖然 PrimeIntellect 是這份研究的發布方,但有幾個值得懷疑的點:
- Fable 5 是 PrimeIntellect 自家模型——他們有沒有針對 NanoGPT 做特化訓練?他們強調「無監督純自主跑」,但訓練資料是否包含 NanoGPT 相關 paper?無法獨立驗證
- 8.7 天的長跑實驗 vs. 2.9 天的 Opus 5——Fable 5 雖然領先 28%,但花費的算力時間也接近三倍。如果換算成「每算力單位分數」,領先幅度可能縮水到個位數
- 24 小時上限偏鬆——大多數模型只用 1.1-6.1 天就跑完,但 Fable 5 跑到 8.7 天。如果統一限制 3 天,Fable 5 跟 Opus 5 的差距可能只剩個位數
- 公開的「41 條精選軌跡」並非全部——153 次實驗只公開 41 條,研究者無法重現完整分布總結:Fable 5 在「單任務長時自主實驗」這個維度確實領先,但「商業 AI 研究助理」的競爭才剛開始。下一輪 benchmark 應該加入「限制算力預算」與「限制時間」兩個變因,才能真正分出高下。
編按:本文綜合整理自 PrimeIntellect NanoGPT Speedrun Frontier 研究頁,並加入 Siami 編輯部觀點與分析。原文所有 18 個模型的實驗數據與 41 條精選軌跡可從 PrimeIntellect 官網直接查閱。
網友熱門留言 (6)