編按:本文綜合整理自 Z.ai 官方部落格、Bloomberg 報導、Hacker News 討論,並加入 Siami 編輯部觀點與分析。
模型概覽:前沿智能打到 Flash 級成本
中國 AI 實驗室 Z.ai 正式發表 GLM-5.3-Flash,這是 GLM-5 系列第一個原生多模態模型。總參數 320B、啟動參數僅 18B,在各項基準測試與真實工作負載上全面超越 GLM-5.2,價格卻只有前代的十分之一,並在編碼與代理(agentic)基準測試上逼近 Claude Opus 4.8。
三層架構革新
GLM-5.3-Flash 採用三項關鍵架構改進:
- 稀疏 + 線性注意力混合架構:首次結合線性注意力捕捉局部依賴、稀疏注意力檢索全域脈絡,大幅降低長上下文服務成本
- Manifold-Constrained Hyper-Connections(mHC):改善擴展效率
- 30T token 多模態預訓練語料:用更少算力產出更高智能
相較 GLM-4.5 系列(總參數 355B、啟動 32B、92 層),GLM-5.3-Flash 啟動參數砍到 18B、層數減半至 45 層,但總參數仍維持 320B。
基準測試表現
在 Artificial Analysis Intelligence Index v4.1.1 上,GLM-5.3-Flash 拿到 57 分,單任務成本僅 0.045 美元(折扣後)——這個智能水準過去要 10 倍價格才能達成。
在六項編碼與代理基準測試上:
| 基準測試 | GLM-5.3-Flash | GLM-5.2 | Claude Opus 4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | 85.0 |
| DeepSWE v1.1 | 63.4 | 46.2 | 58.0 |
| NL2Repo | 56.3 | 48.9 | 69.7 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | 41.0 |
| HLE w/ Tools | 55.3 | 54.7 | 57.9 |
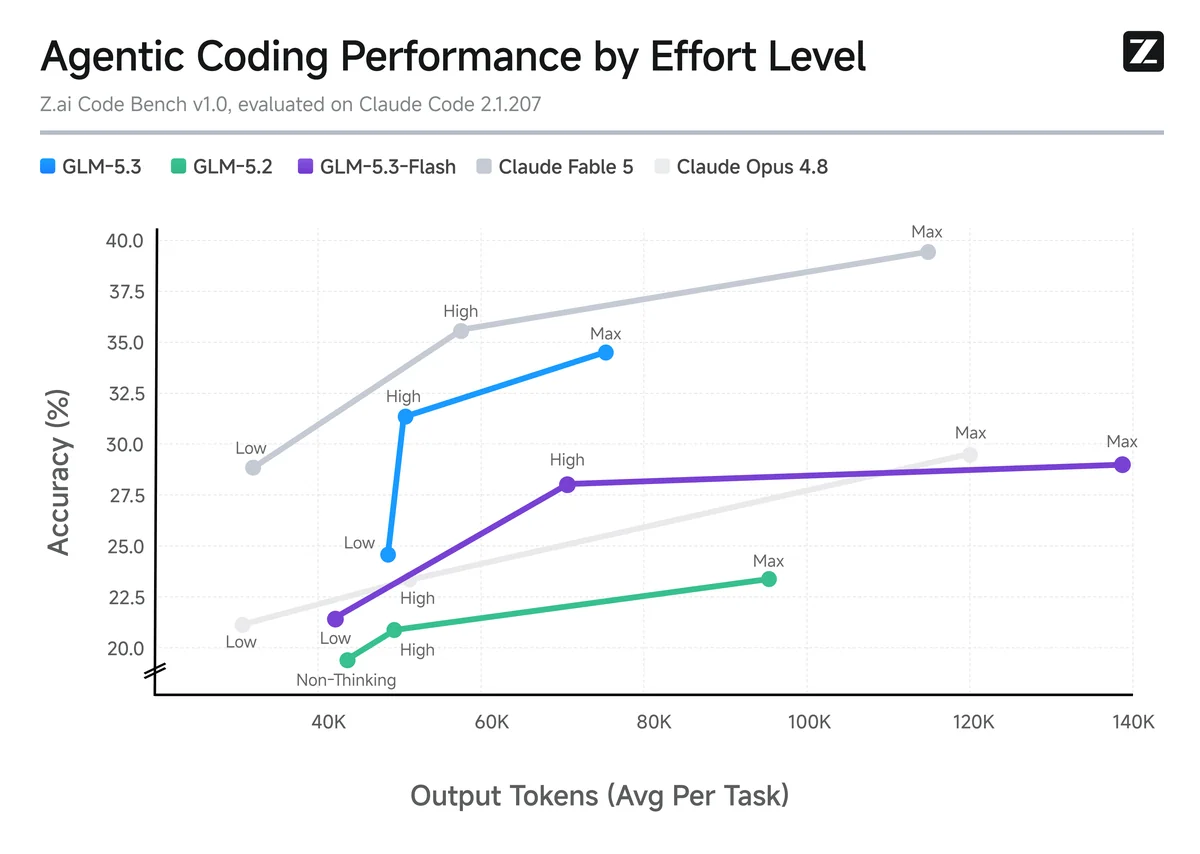
在自家 Z.ai Code Bench v1.0 上(用 Claude Code 2.1.207 評測),最大算力配置下 GLM-5.3-Flash 拿到 29.0 分,與 Claude Opus 4.8 的 29.5 幾乎打平。
視覺智能整合進編碼迴圈
GLM-5.3-Flash 不是只在文字層做編碼,而是把視覺原生整合進模型本體:
- 資料合成管線:模型與環境互動、檢查自己輸出、反覆優化
- 強化學習 + 環境反饋:前端編碼場景中,用代理式驗證強化 GUI 判斷
- 從功能性正確到渲染體驗正確:驗證延伸到「使用者實際看見的產品」
對於前端開發、遊戲開發、3D 模擬這類任務,視覺智能讓模型能觀察渲染結果、互動流程、遊戲試玩,從而修正看不見的錯誤。
為什麼這件事重要
GLM-5.3-Flash 標誌著三個深層結構轉變:
- 前沿智能 ≠ 天價成本:過去要花 0.45 美元才能達到的智能水準,現在 0.045 美元就能取得,等同把邊界往右下推了一個量級
- 中國 AI 晶片已能承載前沿模型生產級推理:全叢集跑在國產加速器上,端到端服務效能達到 NVIDIA GPU 同級,成本可比——這對全球 AI 算力地緣政治是重大訊號
- MoE + 混合注意力已成開源旗艦標配:從 DeepSeek-V4-Flash、Kimi-K3 到 GLM-5.3-Flash,三家中國實驗室在同一個月內相繼發表混合注意力架構,技術路線正在收斂
對開發者最直接的意義:18B 啟動參數 + 18 美元/月等級的 API 價格,讓中小型團隊首次有能力在生產環境部署接近前沿水準的編碼代理,而不必依賴 Anthropic 或 OpenAI 的昂貴 API。
數據解讀與質疑
雖然 Z.ai 的官方數據亮眼,但有幾個值得追問的點:
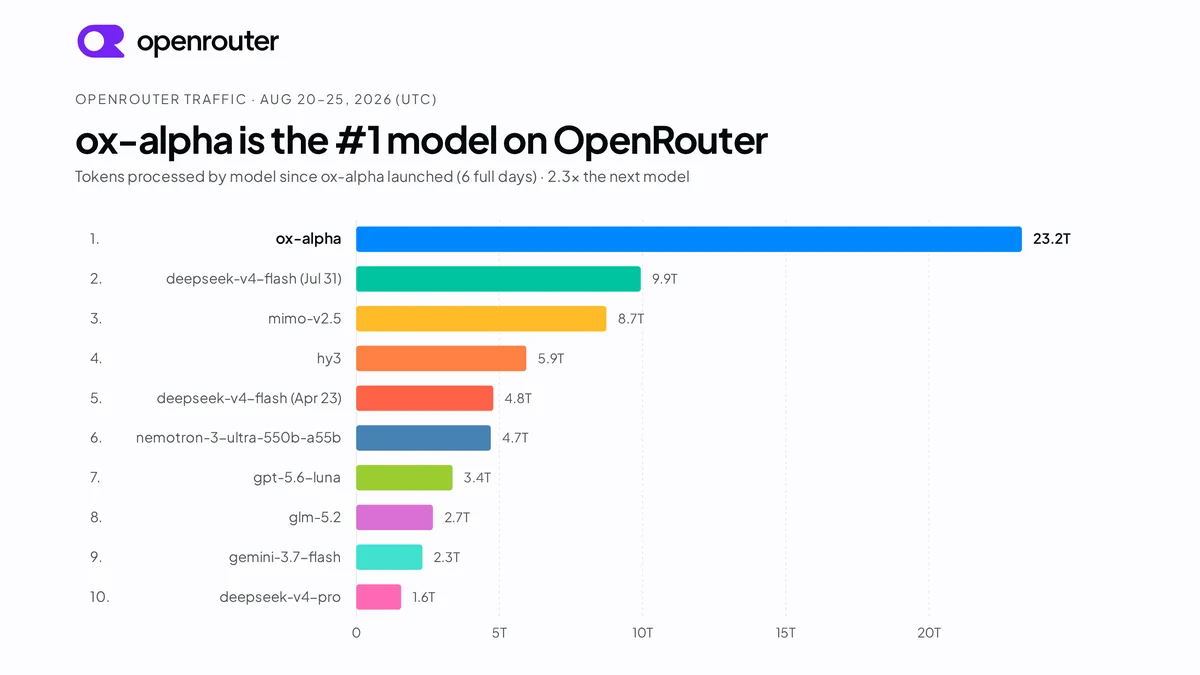
- Bloomberg 揭露的 ox-alpha 謎團:發布前一週以匿名模型身份在 OpenCode、OpenRouter 上收集使用者反饋,迅速成為當週最受歡迎模型。Hacker News 上有 Google 工程師被認為是「模糊爆料者」,但至今無公開澄清——這是否涉及 benchmark 偏差或市場操作?
- 服務條款的疑慮:網友 matheusmoreira 指出 Z.ai 對輸入與輸出擁有「廣泛且永久的授權」,甚至包含使用者姓名與大頭貼。條款中對「可能損害 Z.ai 利益」的禁令相當模糊——企業用戶採用前應仔細審閱
- 中國 AI 晶片的真實成本:官方宣稱達到 NVIDIA GPU 同等成本,但沒有公開 TCO 比較。記憶體頻寬、單卡算力的限制下,叢集規模是否真的能跟 NVIDIA H200/B200 競爭?
- 基準測試的偏誤問題:歷史經驗顯示中國實驗室有 benchmark 灌水前科。這次 mrngld 網友罕見地說「這次官方公告反而低估了」——值得驗證第三方獨立評測(如 Artificial Analysis、lmsys)的一致性
部署與取得方式
GLM-5.3-Flash 已在三個管道同步上線:
- GLM Coding Plan:所有使用者立即可取得,可用額度是 GLM-5.3 的 3 倍
- ZCode:解鎖多模態能力,搭配 Browser Use 與 Computer Use 代理
- HuggingFace 公開權重:本地部署支援 SGLang、vLLM、TokenSpeed 推論框架
🚨 為什麼這件事重要(編輯部觀點)
這不只是「另一個開源模型發表」。GLM-5.3-Flash 代表中國 AI 實驗室第一次在『生產級規模 + 開源權重 + 自研晶片』三個維度同時達到前沿。這條路徑若被驗證可行,將直接挑戰 NVIDIA 在 AI 算力市場的定價權,也會迫使美國前沿實驗室(OpenAI、Anthropic)重新評估模型與晶片的綁定策略。
對台灣與全球開發者最實際的意義:前沿編碼模型的 API 價格戰正式開打。GLM-5.3-Flash 0.045 美元/任務的定價,會直接壓迫 Claude Opus 4.8、GPT-5.6 的同類服務降價,長期看對 SaaS 與 AI 工具鏈是大利多。
業界反應:HN 社群怎麼看?
Hacker News 上 131 則討論中,主流聲音分為三派:
- 實用派(bertili、mmastrac):聚焦在「4 週內從 Kimi K3 到 GLM-5.3,中國開源迭代速度太瘋狂」,以及「18B 啟動參數可以塞進消費級顯卡」
- 質疑派(matheusmoreira、mrngld):關注服務條款的授權風險,以及「ox-alpha 匿名測試是否構成 benchmark 偏差」
- 地緣政治派(sunbum):『所有流量跑在中國 AI 晶片上』這句話的重量——NVIDIA 股東真的要緊張了
Siami 編輯部觀察:社群最關注的不是模型本身,而是『中國 AI 晶片能承載前沿模型』這個地緣政治訊號。技術細節(如混合注意力、IndexPool 索引池)反而被快速帶過——這反映 HN 讀者更在意的是生態系變遷,而非單一模型分數。
網友熱門留言 (8)