編按:本文綜合整理自 calv.info 創辦人 Calvin Fernandez(前 Segment CEO)部落格原文,並加入 Siami 編輯部觀點與數據背景。
小模型已悄悄穿過臨界點
Calvin Fernandez 在部落格發表新文章〈Small Models Have Arrived〉,拋出一個在矽谷創投圈開始發酵的觀察:過去幾週他密集測試了 OpenAI 的 gpt-5.6-luna,赫然發現小型模型的進展已經被大型模型的鋒頭掩蓋。
Luna 的能耐讓他震驚——速度上看見常態約 100 tokens/sec(TPS)的回應品質,能在他自己的 codebase、email、知識庫之間流暢穿梭。更關鍵的是成本:就算是上千封信件的批次搜尋任務,API 帳單也只落在「幾十美分」等級。
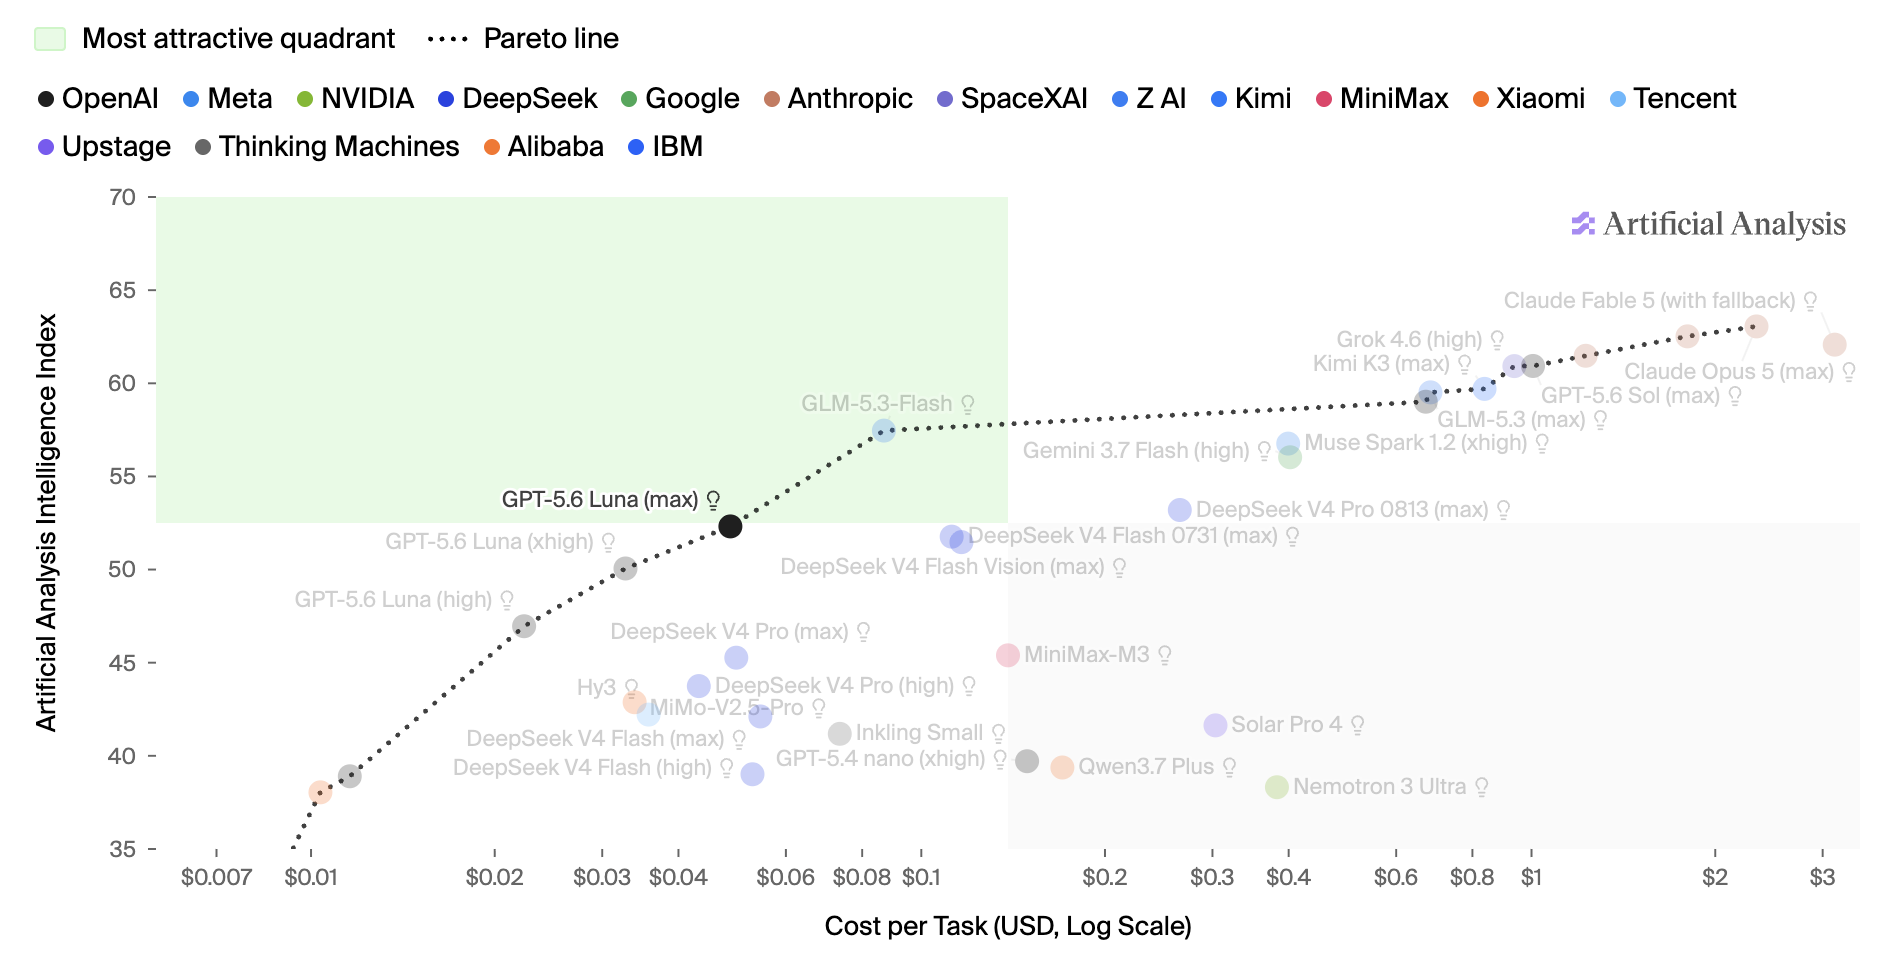
人工分析(artificialanalysis.ai)的智能與成本散佈圖中,GLM 5.3(智譜 AI)也加入了 Pareto 前緣的俱樂部,跟 OpenAI、Google 的中型模型正面交鋒。
消費者 AI 為何一直沒冒出來?
Calvin 跟幾位投資人朋友碰面時,反覆聽到同一個疑問:「為什麼現在還沒看到更多 consumer AI 公司冒出來?」
他的答案很直白:token 成本。
「在 AI 時代之前,consumer app 的腳本很簡單:做個吸引人的網站 → 用病毒行銷拉使用者 → 募資、放大 → 接廣告變現。Google、Facebook、Snapchat 都是這條路。」
但只要產品加進 AI,每一個 request 都有 inference 成本——資本需求瞬間跳一階。他舉了一個私人 side project 的例子:
「我想要的東西是每天生成一份個人化新聞網站:自動研究我的興趣 → 抓 HN、Reddit、X 的素材 → 蓋一個微型網站出來。」
用上一代 Sonnet 等級的模型,光跑一次就要約 1 美元。如果要向使用者收 30 美元/月,根本撐不起來——你必須交付跟《華爾街日報》或《經濟學人》一樣的價值才有道理。
但用 luna 同樣的任務,平均成本只要 0.10 美元。量級差異讓 consumer AI 的算式完全改寫。
商業世界的「IQ 180 vs Token Spewer」二分法
Calvin 跟 Segment 共同創辦人 Peter Reinhard 健行時聊到一個觀察,特別有意思。Peter 同時在經營 Charm Industrial(碳移除新創,募了 1 億美金 Series B)跟 Revoy(卡車節能新創,剛關 Series A),兩邊都看得很清楚。
他把工作分成兩種:
- 「IQ 180」型:某個天才點出你從沒想過的解法
- 「Token Spewer」型:高度回應、不斷推進各條戰線的小事
「Peter 自己說,他做的工作 95% 都落在第二種——接電話、催進度、清掉瓶頸。但他也強調,沒有 IQ 180 的技術腦袋解決深層問題,公司早就倒了。」
這兩種工作對應到 AI 模型世界,邏輯完全相同:
- 前沿大模型(Fable 5、5.6 Sol)→ 持續堆高 IQ 180 的天花板,特別在工程、硬科學、模型訓練這些需要真正突破的領域
- 小模型(luna、GLM 5.3 等)→ 吃掉 95% 的 Token Spewer 工作
為什麼這件事重要
這篇文章的論點之所以值得單獨拆出來講,是因為它把 AI 產業一個長期被忽略的轉折講清楚了——「模型大就是好」已經不是唯一指標。
過去兩年整個產業的敘事都圍繞在 GPT、Claude、Gemini 的 benchmark 對決,但 consumer 端的應用卻一直卡在一個尷尬的位置:做出來能跑,但每個月的 API 帳單比使用者付費還貴。這也是為什麼過去一年大家看到的「殺手級 AI 應用」多半落在企業端(B2B SaaS),因為企業客戶付得起每席每月 50-200 美元的訂閱。
但小型模型成本砍掉 10 倍後,consumer 端的算式突然打平了:
「想想你每天互動的人——同事、廠商、客戶。十次裡有九次,你要的只是那種高度回應、把事情處理掉的普通人。」
Calvin 引用這句話的意思是:消費性 AI 不需要每個互動都是天才等級的回覆,絕大多數時候只要夠快、夠準、夠便宜就好。這跟過去十幾年勞動市場的「hiring skew」一模一樣——企業本來就傾向找「快速、便宜、足夠好」的人。
當這個成本結構被打通,新的消費性 AI 應用會一波冒出來。
數據解讀 / 質疑
幾個值得質疑或補充的點:
-
0.10 美元 vs 1 美元是 10 倍差距,但這只是 API 成本。一個真實 consumer app 還要算 infra、儲存、CDN、客服、退款糾紛,真正的 unit economics 差距會被其他成本稀釋。10 倍的 API 成本下降,未必換得來 10 倍的商業可行性提升。
-
「Luna 是中型模型」的定位不無疑問。OpenAI 把 luna 放在 GPT-5.6 家族底下,介於 mini 跟 pro 之間。它確實小,但跟真正的開源小型模型(Mistral 7B、Llama 3.1 8B、Phi-4)比起來還是大很多。Calvin 沒講清楚的,是「什麼尺度才算 small」——這個定義會直接影響他的論點成立與否。
-
IQ 180 vs Token Spewer 二分法過於乾淨。真實工作中,兩種任務常常混在一起——一個看似簡單的「Token Spewer」任務,可能因為例外狀況冒出 IQ 180 等級的問題。如果小模型在「踩到例外」時要 fallback 到大模型,整體成本優勢可能會被吃掉一部分。
-
GLM 5.3 的 Pareto 前緣地位需要時間驗證。人工分析的 benchmark 是基於公開測試集,這些測試集跟真實 consumer 場景的契合度,永遠是個問號。Calvin 引用這張圖是支持論點,但沒附上 GLM 5.3 在他自己 codebase 的實際表現數據。
接下來會發生什麼?
Calvin 在文末留了個邀請:「如果你也在實驗如何讓小模型變實用,歡迎跟我聯絡。」
這個訊號本身就透露了現實:harness、prompt injection 防護、role / permission 設計這些圍繞小模型的工程基建,目前都還在非常早期的階段。這也是為什麼他強調「我確信產業界會想出辦法」,但沒說已經想出來了。
對讀者來說,這篇文章最重要的一課是:不要再把「AI 應用 = 大模型 API」當預設。未來半年值得關注的,會是哪些 consumer 場景第一個把 token 成本壓到 0.05 美元以下,並且開始賺到錢——這才是小型模型時代真正落地的訊號。