編按:本文綜合整理自 PhiloLabs/fable51-worlds GitHub Repo、Claude Fable 5.1 官方頁面、Hacker News 討論串,並加入 Siami 編輯部觀點與分析。
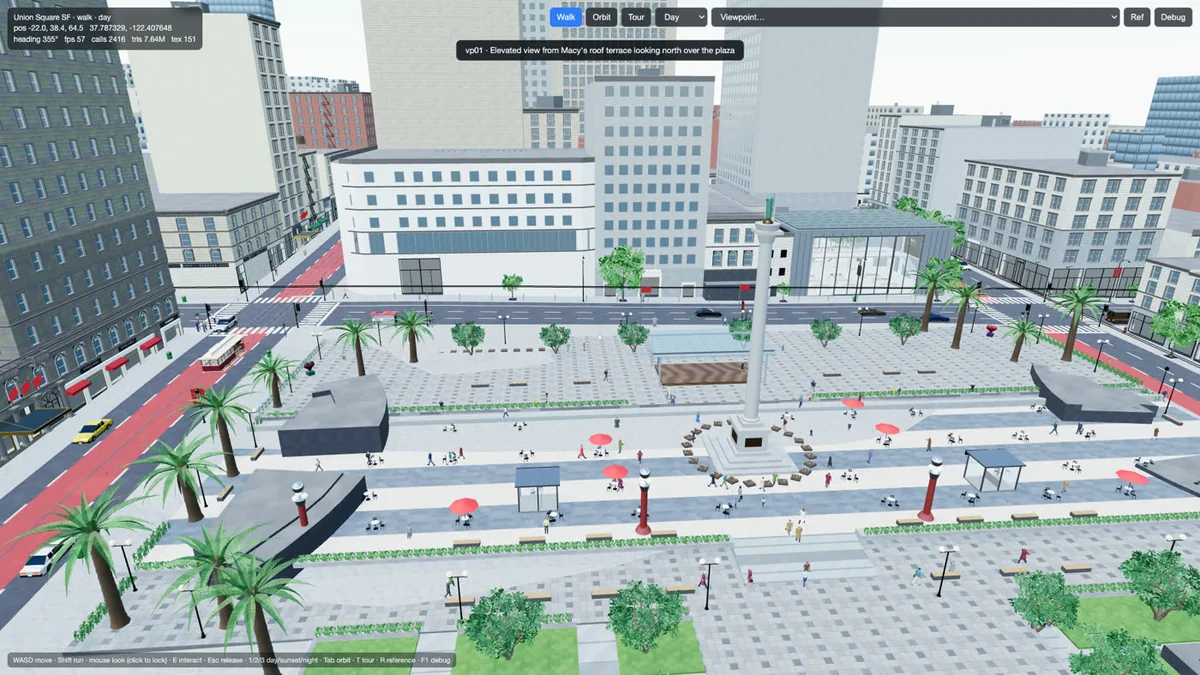
Anthropic 旗下的 Claude Fable 5.1 agent swarm,近日交出首份「世界模型」演示作品——完整重建舊金山聯合廣場(Union Square)方圓數個街區,包含 Apple 與 Nintendo 兩棟內部可逛的場景,全棧由程式碼自動生成、可在瀏覽器即時運行。這個專案於 9 月 2 日登上 Hacker News 即時榜第一,截至發稿累積 167 個 upvote、超過 56 則討論,把同期的 Google 反壟斷案、NYC 學校 AI 禁令都擠到後頭。
什麼是 Fable 5.1 World Modeling
Fable 5.1 World Modeling 是 Anthropic 旗下 Claude Fable 5.1 系列的多 agent 協作系統,目標是用程式碼自動產出可在瀏覽器運行的真實世界 3D 重建。PhiloLabs 在 GitHub 公開整個 pipeline,從研究、素材生成到 QA 校稿全部開源(MIT 授權)。
第一個公開作品「Union Square, San Francisco」覆蓋 Powell、Geary、Post、Stockton 四大街區的真實地理資料,包含 453 棟 OSM 建築底圖、75 棟手作立面、129 家具名店家、220 個行人在 1,398 個節點的導航網格上行走,加上 109 輛車(含纜車)、日夜三種光照模式。兩棟內部可逛空間——Apple Union Square(300 Post St)與 Nintendo SAN FRANCISCO(331 Powell St)——共有 23 個可互動物件。
整個 demo 用 Three.js 寫成、可用
npm run dev跑,不需要遊戲引擎、不依賴任何專屬 3D tiles。每一棟建築、每一個招牌、紅綠燈、路樹都是「從開放資料與公開參考圖,透過寫程式碼的方式產出」。
怎麼做的:四階段 pipeline
每一個世界都遵循相同的四階段流程,每一步都公開在 repo 中:
- 偵察階段(Reconnaissance):平行 research agents 從 OpenStreetMap 抓幾何資料、USGS 拿高程、大眾運輸規格、店家普查;每個事實附引用來源與信心等級。
- 離線素材生成(Offline asset generation):以 Blender 當函式庫(
bpy)批次輸出最佳化的 GLB kits,包含立面模組、街具、車輛、植栽、零售家具、行人身體部位等。 - 執行環境(Runtime):純 Three.js app 從 JSON specs 組裝地形、街道、立面、道具、人群與車流。
- 比對品管(Camera-match QA):Playwright 駛入真實 app、固定拍照點截圖,再用免費授權的實景照片做比對;獨立 reviewer agents(建築師、地理學家、技術美術、互動設計)寫報告,進入下一輪修正循環。
整個 pipeline 內建 34 個相機校對視角、147 份比對表、9 份獨立 reviewer reports。「可重現、可審核」是這個專案與一般 AI demo 最大差異。
Fable 5.1 扮演的角色
Fable 5.1 是 Anthropic 內部用於多步 agent 協作的系統,特色是把研究、生成、品管分工給多個 agent,靠 consensus 機制收斂到可驗證的成果。相較於單 agent 一次性吐程式碼,Fable 5.1 的產出可控性更高,但成本也明顯增加。PhiloLabs 未公開具體成本資料,HN 用戶 @kodefreeze 用 Opus 5 做類似任務指出「Opus 5 效果一樣好、更便宜」,但承認高模需要 retopo 才能變遊戲用 asset。
為什麼這件事重要:世界模型的定義之爭
「世界模型(world model)」這個詞在 2025–2026 年的 AI 圈是兵家必爭之地。從 Wayve、WAIR 到 NVIDIA Cosmos,各家都在定義什麼算世界模型。Fable 5.1 把答案攤開來:它不是單純的影片生成,也不是一個純圖像模型——它是一個「可在瀏覽器即時互動、地理精確、可審核」的世界重建。
HN 用戶 @jaybuff 直接說:「這跟我聽到『世界模型』時預期的不一樣!」@WordNotSee 則從技術定義切入:所謂世界模型應該蘊含更多深度,這其實更像「POV image model」或「第一人稱視角 model」。
但 Fable 5.1 的關鍵是可執行:你不只是看一段影片,而是真的能走進 Apple Union Square、進到 Nintendo 地下室、推一推展示架。這把『世界模型』從『幻覺式生成』拉回『可程式化實體』的範疇。
這對遊戲、城市規劃、自駕訓練、自動導航、虛擬觀光等產業都有直接意義——當世界不再是「生成一段影片」,而是「生成一份可執行的程式碼」,整套下游應用的成本結構會重新洗牌。
數據解讀:這個 demo 真的能用嗎?
從 PhiloLabs 公開的數據來看,這個專案達成的「誠實指標」相當具體:
- 覆蓋面積:Powell / Geary / Post / Stockton 四大街區,真實街廓與地形
- 店家精細度:129 家具名店家(包含 Apple、Nintendo、SAKS、Macy’s 等代表性商家)
- 行人/車流密度:220 個行人在 1,398 節點的導航網格、109 輛車含 Powell St 纜車
- 可互動內裝:Apple + Nintendo 兩棟共 23 個互動物件
- QA 強度:34 個相機校對視角、147 份比對表、9 份獨立 reviewer reports
- 授權:MIT 開放源碼(含生成的素材);幾何資料衍生自 OSM(ODbL)、USGS 3DEP(public domain)
但要注意幾個還沒驗證的面向:
- 未公開成本:沒有 token 數、花費金額、運算時數。對想複製的開發者來說是最大黑箱。
- 未公開失敗率:多少比例的店家內裝是要人工介入修改的?需要 babysitting 嗎?
- 擴展性未驗證:4 個街區的 Union Square 已經很漂亮,但「更多城市」「整個國家」「整個地球」的擴展性還沒人試過。
@avdelazeri 的批評很到位:「我希望你們能多透露一些資訊,特別是時間、成本、可靠度(失敗率多少?需要人工監督嗎?),這些對評估可行性至關重要。」
與主流世界模型路線的差異
| 路線 | 代表玩家 | 產出形式 | 可互動? | 可審核? |
|---|---|---|---|---|
| 純影片生成 | Sora、Veo、可靈 | 預錄 MP4 | ❌ | ❌ |
| 可即時互動遊戲引擎 | NVIDIA Cosmos、Decart | 端到端神經輻射場 | ✅ | 有限 |
| 程式碼生成式重建 | Fable 5.1 / PhiloLabs | 可執行的 Three.js 程式碼 | ✅✅ | ✅✅ |
| 遊戲素材生成 | Meshy、Tripo3D、Rodin | 獨立 3D 資產 | ❌ | ❌ |
Fable 5.1 切入的是中間最稀缺的一塊:既像遊戲引擎那樣可即時互動、又像開源程式碼那樣可審查可修改。不依賴神經輻射場的隱式表示、不依賴商業 3D tiles 授權——每一行程式碼都在 repo 裡。
還有更多世界即將釋出
PhiloLabs 在 README 直接寫下「More worlds coming.」,但未透露下個目標地點。從程式碼結構看,pipeline 是 template 化的,任何 OSM 資料豐富的城市理論上都能套用。紐約、東京、台北、香港這些 OSM 覆蓋完整的城市,都是合理候選。
從 Siami 編輯部角度觀察,這個專案驗證了一件事:「世界模型」的價值不在能不能產生擬真影像,而在能不能變成「可被工程師修改、可被玩家遊玩、可被研究者審核」的程式碼。一旦這個成本結構被打通,後續衍生應用(教育訓練、城市規劃模擬、AR 導航)會出現大量二創。
編按:本文綜合整理自 PhiloLabs/fable51-worlds GitHub Repo、Claude Fable 5.1 官方頁面、Hacker News 討論串,並加入 Siami 編輯部觀點與分析。
網友熱門留言 (5)