編按:本文綜合整理自 ARC Prize 官方部落格、ARC Prize 結果頁、Hacker News 討論串(148 則留言),並加入 Siami 編輯部觀點與分析。
GPT-6 Astra 在 ARC-AGI-3 Semi-Private 測試中,使用 ARC Prize 標準介面(Standard harness)拿下 62.7% 分數、耗資 26,000 美元;若改用 Provider Adapter 介面(保留內部推理狀態、透過壓縮延長對話),則衝到 99.9%、耗資 19,000 美元——同一個模型,分數差距竟達 37.2 個百分點。
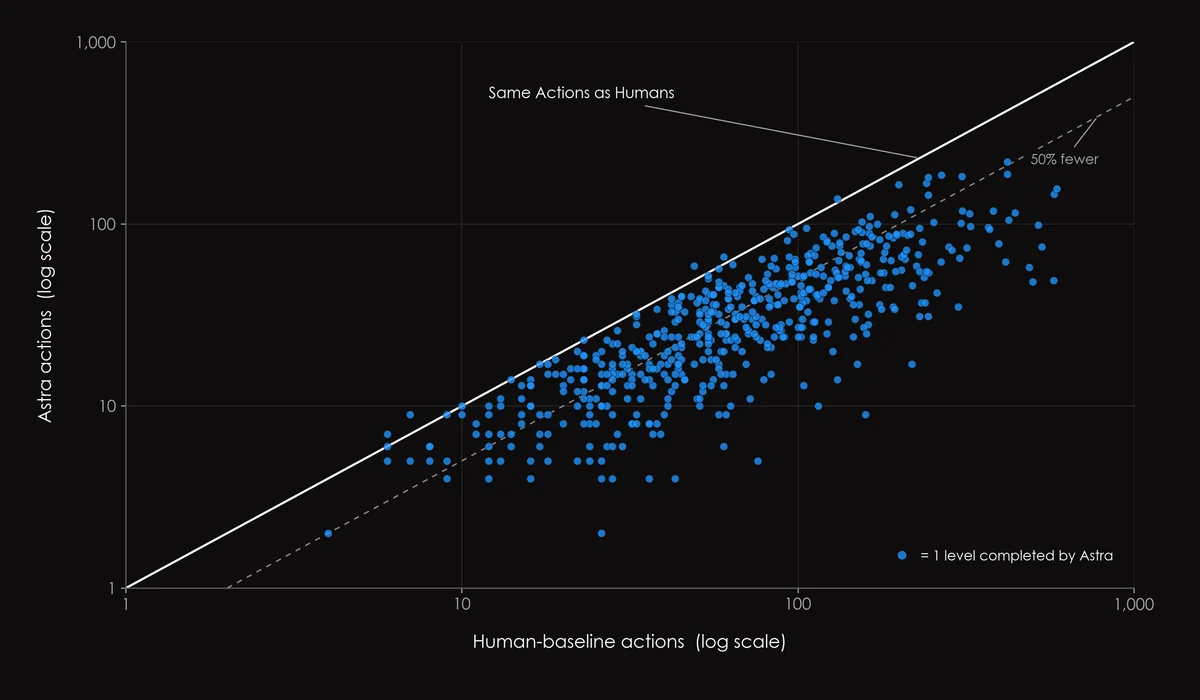
GPT-6 Astra 在 ARC-AGI-3 的「行動效率」上已經超越人類基準。它在 96% 的關卡中,使用步數比受測人類的中位數還要少。GPT-6 Astra 展現出最關鍵的一個行為是:它會把陌生的環境,壓縮成精簡的符號化世界模型。它把遊戲機制寫成邏輯規則,還自己發明了一套領域專用的速記語言,來追蹤狀態、規劃下一步動作。
兩種介面,兩個完全不同的分數
很多人看到 OpenAI 發表 GPT-6 Astra 時喊「AGI 到了」,依據的是 98.5% / 99.9% 這個數字。但 ARC Prize 這篇部落格把場景拉回來:他們自己設計的兩個介面,跑出來的結果差距極大。
Standard 介面讓模型可以自行選擇要保留哪些筆記、帶到下一輪環境互動中。
Provider Adapter 介面會在 API 請求之間保留不透明的內部推理狀態,並在對話拉長時透過 compaction(壓縮摘要)保留先前的工作,讓模型可以重複使用先前的成果。
Standard 介面:Astra(max)拿下 62.7%、耗資 26,000 美元。
Provider Adapter 介面:Astra(max)衝到 99.9%、但只花 19,000 美元。
也就是說,介面設計本身就是成績的一部分。這跟 OpenAI 自己七月發表的〈How enabling two settings tripled our scores on the ARC-AGI-3〉那篇研究是同一條線——光是「保留推理」+「對話壓縮」兩個設定,就讓 GPT-5.6 Sol 在 ARC-AGI-3 public 集從 13.3% 拉到 38.3%。
符號化世界模型:模型自發的「代數速記」
Astra 在玩 s5i5 這關時,它開始為環境發明自己的速記語法。這類行為在過往其他模型也曾出現,但 Astra 的筆記在精準度與資訊密度上特別突出。它把整個場景濃縮成一段精簡的「類程式碼」符號模型:物體在哪裡、彼此怎麼互動、接下來該依什麼順序做哪些動作。
這是一種「即興代數速記」,而不是一套完整的程式語言。幾個範例:
Game state: L8: hub q2 (8↓). Lengths: 14=1…記錄關卡編號、本地旋轉索引、以及機制長度。
Multi-step plans: extend8 to3; retract10 to2; shorten8 to1記錄對 color-8 與 color-10 機制依序要做的一連串改動。
Controls and coordinates: 9−=(39,4), rotate=(49,18), 14+=(59,11)把操作對應到執行它們的控制點座標。
Time and position: Turn 5: P=(24,20), empty, facing west把回合計數、玩家位置、攜帶狀態、還有朝向綁在一起。
這顯示一個關鍵能力——模型不只是「解題」,而是把環境抽象成可操作的內部符號系統。
行動效率:96% 關卡贏過人類中位數
在 ARC-AGI-3 上線前,ARC Prize 請了大約 500 位一般民眾做測試,建立「人類行動效率基準」——也就是:人類平均花多少步數解出每個關卡?參與者並未經過解題經驗或能力的篩選。
每一關的「人類基準」定為「完成該關的人類中位步數」。在 Provider Adapter 介面下:
- Astra(max)在 96.0% 的關卡用的步數比人類基準少
- 平均每關少用 51.7% 的步數
這是一個實質的里程碑。也就是說,以 ARC-AGI-3 的行動效率指標來看,Astra 已經追上、甚至超越人類水平。
順帶一提,ARC Prize 自己原本的假設是「行動效率會一直是人類與 AI 的界線」,結果前沿 AI 反而呈現「一旦理解,就直接落到人類效率範圍」這種二元式型態。
Agent 介面裡的自製工具
研究團隊也在 PRO-LONG 介面(ARC-AGI-3 早期紅隊合作夥伴開發的論文)下評估 Astra——在這個進階設定中,Astra 可以存取一個能跑自訂程式碼的沙盒。Astra 展現出為每一款遊戲自製工具的能力:盤面解析器、遊戲狀態模型、搜尋演算法、規劃器、還有持久化的筆記。在更複雜的關卡裡,Astra 甚至會產出小型、針對單一遊戲的軟體庫。
例如在 tu93——一款有守衛與巡邏兵的迷宮遊戲——Astra 從導航開始,建立了 maze_solver.py。它在 combat_solver.py 加上戰鬥規則,在 patrol_solver.py 為巡邏兵建模,再用 sync_state.py 把預測跟觀察對起來檢查。
這比「解題」更深一層——是模型自主生成針對單一問題的軟體工程產出。
為什麼這件事重要
99.9% 不是終點,介面才是關鍵。OpenAI 自己 7 月就公開承認,單純打開「保留推理」+「對話壓縮」兩項設定,分數就直接翻三倍。如果把同一邏輯攤開來看,「基準測試分數」這個概念本身正在被重新定義:未來任何模型廠商要宣稱某個 benchmark 拿到 SOTA,都必須同時公開介面、推理預算、還有是否允許 opaque state retention。
行動效率這個維度,比「會不會解」更有意義。過去多數基準只測「成本效率」(用了多少運算資源),但 ARC-AGI-3 測的是「需要多少跟環境互動的經驗」。Astra 在 96% 關卡上贏過人類中位數,這代表它學得比人類更有效率——這是 AGI 定義裡的核心指標之一。
NVIDIA 早已達標 100%。在 Astra 之前,NVIDIA 的 AVO 已經在 ARC-AGI-3 拿到 100%,但用了一個高度客製化的 agent 架構。所以「99.9% vs 100%」這場比較,要回到介面一致性才有意義——ARC Prize 這次把兩種介面都跑出來,就是為了讓這個比較變得公平。
數據解讀與質疑
- 99.9% ≠ 100%:99.9% 看起來逼近天花板,但 ARC-AGI-3 本質上設計成人類 100% 可解。在「還有 0.1% 沒解」這個差距上,要繼續壓榨分數的成本會急速上升。
- 介面是模型能力的一部分還是作弊? HN 上 @an0malous 提出質疑:OpenAI 有沒有事先拿到題目,才能針對特定關卡客製介面?ARC Prize 部落格沒有完整回答這個問題,但公開的測試環境是盲測的 Semi-Private set——這個保證需要進一步檢視。
- $19K vs 人類 $12.78:每場遊戲 Provider Adapter 花 19,000 / 167 ≈ $114,跟人類約 $12.78 的報酬比起來還貴了將近 9 倍。但若以「模型 + 工具」這個組合的整體表現計算,搭配 token 用量年減 49% 的趨勢,兩年內跌破人類成本是合理預期(HN @modeless 已經算了)。
- 為什麼用 Erdős 開放問題當另一個量尺? 因為開放問題無法「背答案」,可以避免模型在訓練資料上 leak 已公開解法。GPT-6 Astra 在 68 題中只解了 2 題(其中一個用反例推翻),這才是真的能力檢驗——不是 benchmark 數字遊戲。
- AGI 的定義被悄悄改寫:OpenAI 自己把 AGI 定義成「以人類效率學會任何人類能學會的技能」,然後 Astra 已經在行動效率上贏過人類中位數——但這距離「學會所有人類能學會的技能」還非常遠。距 AGI 還有多遠,目前數字本身沒有給答案。
網友熱門留言 (5)