編按:本文綜合整理自 Sebastian Raschka 的技術分析文章、OpenAI 官方發表、The Information 報導、TechCrunch 報導、ARC Prize 部落格,以及 Hacker News 上的業界討論,並加入 Siami 編輯部觀點與分析。Sebastian Raschka 是知名機器學習研究者,著有《Build a Large Language Model (From Scratch)》《Build a Reasoning Model (From Scratch)》等書。
一、GPT-6 Astra 是什麼?
2026 年 8 月底,OpenAI 正式發表 GPT-6 Astra(內部代號 Astra)。Sebastian Raschka 試用後在個人部落格評價:「這是本人截至目前用過最強的模型」。
從 benchmark 來看:
- ARC-AGI-3:拿到 99.9% 分數,幾乎完全解決這個以「邏輯謎題與泛化能力」聞名的艱難測試。前一代 GPT-5.6 Sol 只有 7.8%。
- OSWorld 2.0(電腦操作):72.6%,比 Sol 還快 47%,代表在真實電腦使用情境下,Astra 是目前最強的商業模型。
- ExploitBench:達到 100% 滿分。
- Coding Agent Index v1.4:在主流 coding benchmark 上大幅領先。
除了上述指標,Astra 在 3D 渲染與動畫任務上的進步特別明顯,相對於其他領域(寫作、數學、coding)是「不成比例的跳躍」。
二、Looped Transformer(循環深度)是什麼?
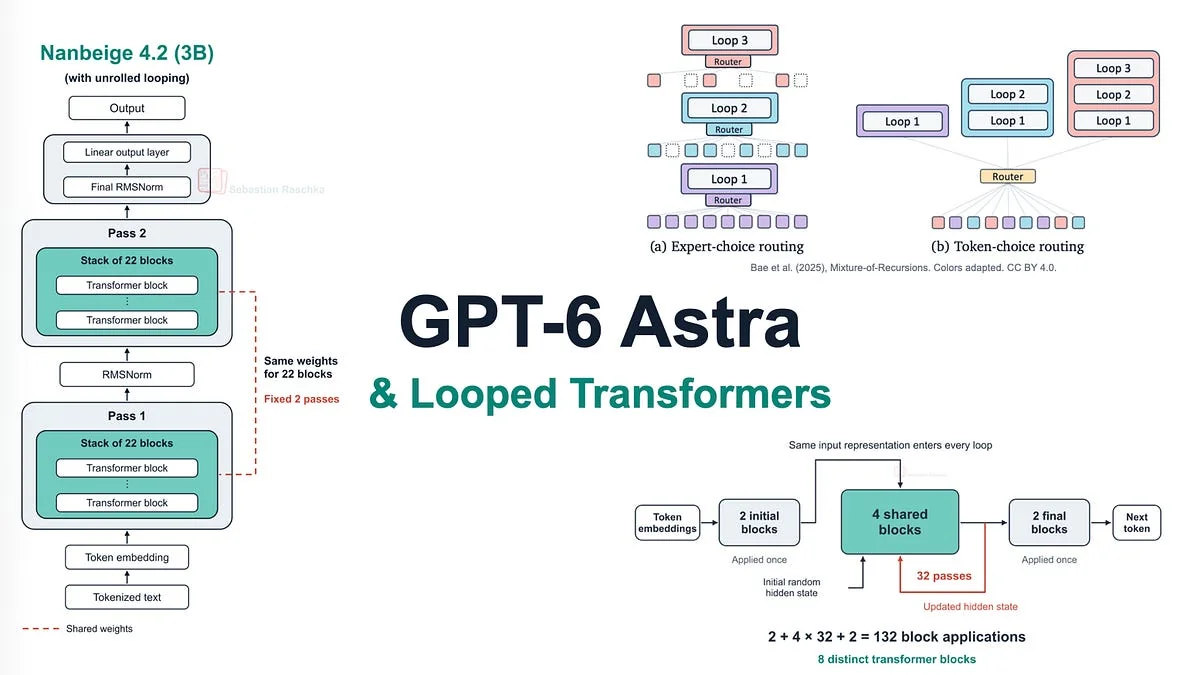
「Looped Transformer 是一種把同一組 transformer block 重複使用多次的架構調整。重點是:共用權重。」
一般 Transformer 模型會堆疊 N 個不同的 block(例如 GPT-3 有 96 個)。Looped Transformer 不堆新 block,而是把中間表示(intermediate representation)反覆丟回同一組 block,跑好幾次。想像成同一批學生反覆作答同一份考試,只是每次拿到的題目稍微變化。
這個概念不新:
- Universal Transformer(2019):Google 的 Dehghani 等人首次提出
- Nanbeige 4.2:已經實作的開源模型,使用單一 block stack
- Latent Reasoning paper(Geiping et al., 2025):3.5B 參數模型,訓練於 800B tokens,looping 數量可動態調整
The Information 在 9 月 1 日爆料:Astra 採用「constrained recurrent depth」,也就是 looped transformer 的一個變體。OpenAI 沒有正式證實,但 OpenAI 首席科學家 Jakub Pachocki 在訪談中說了一句耐人尋味的話:
「目前 frontier 模型(包括 Astra)的計算圖深度,是 GPT-4 的兩倍以內。」
這句話本身沒辦法證明就是 looped transformer,但也可能代表他們多用了兩倍普通 block。Sebastian 的判斷是:Astra 大概率用了某種 looped transformer 變體,但效能提升的主要原因是訓練方法和訓練資料,而不是這個架構調整。
三、Hidden Reasoning 爭議:為什麼安全專家緊張?
The Information 報導的核心爭議是:looped transformer 可能讓模型把 reasoning「藏起來」。
這要從 reasoning model 講起。Reasoning model(如 o1、o3、Astra)在給出最終答案前會產生「思考鏈」(chain of thought, CoT),把中間步驟寫出來:
題目:找兩個數字,總和 10、乘積 21
回答:先試 5 跟 5 → 總和對但乘積 25
     再試 3 跟 7 → 總和跟乘積都對 ✅
OpenAI 從 o1 開始就對使用者隱藏 reasoning trace,但內部會記錄。Hidden reasoning 的擔憂是:
- 開發者無法監控模型內部思考過程
- 如果 reasoning 出現危險傾向(例如學會欺騙、隱藏意圖),外部難以察覺
- Looped transformer 在架構層面「藏」思考的能力更強
Sebastian 在這點上 跟安全社群的立場不同。他認為 looped transformer 本身不是「隱藏 reasoning」的關鍵 — OpenAI 從 o1 開始就已經在隱藏 trace 了,跟架構調整沒直接因果關係。但他承認這個技術確實讓監控更困難。
為什麼這件事重要
對台灣科技圈來說,這篇文章的重要性不在於「GPT-6 Astra 比較強」(這是結果),而在於 三個趨勢正在合流:
第一,模型架構的演進從「堆疊深度」走向「循環深度」。 過去五年 Transformer 變強的主流方法是堆更多 layer、加更多參數。但當訓練成本越來越高,「用更少參數、反覆計算」就變成新的摩爾定律。Sebastian 在文章裡引用了 OpenAI 內部的暗示:計算圖深度其實沒有大幅增加。這代表 OpenAI 可能在訓練成本控制上做了取捨。
第二,reasoning model 的「可監控性」正在快速惡化。 從 o1 到 Astra,OpenAI 持續把 reasoning trace 從使用者介面移除,而 looped transformer 等架構讓「內部 reasoning」更難被外部審查。AI safety 社群(包含 Alignment Research Center、Apollo Research 等)已經多次警告:當 reasoning model 開始在 benchmark 上拿 99.9%,整個 AI 產業更需要知道它「為什麼」答對。如果監控工具跟不上,這就是對齊風險(alignment risk)的溫床。
第三,學術研究與商業部署的時差正在縮短。 Universal Transformer 概念在 2019 年提出,Nanbeige 在 2024 年實作,Latent Reasoning paper 在 2025 年發表,2026 年就成為 OpenAI 旗艦模型的技術基石。對台灣的 AI 研發團隊來說,這意味著 「讀 arxiv paper」的投資報酬率比以前更高 — 過去要 2-3 年才會被商業化,現在只要 6-12 個月。
數據解讀
Sebastian 文章裡有幾個關鍵數字值得深究:
-
ARC-AGI-3:99.9% vs 7.8% — 一年內從 7.8% 跳到 99.9% 是質的飛躍。但 ARC Prize 部落格也提到:「達到這五個解用了超過 22 萬美元的運算成本,相比之下單純 benchmark run 只要 2 萬美元」。這代表 model 可能用了大量 inference-time compute(類似 chain-of-thought 但內部化)來衝分數,不是真的「瞬間解題」。
-
OSWorld 2.0:72.6% 且速度快 47% — 這比 benchmark 看起來更實用。computer use 是目前 AI agent 真正的瓶頸,72.6% 代表 Astra 能可靠地執行大部分桌面任務。
-
Looped transformer 不是效能主因 — Sebastian 的判斷是訓練方法和資料是主因。如果他對了,代表 looped transformer 真正的價值不是「變強」,而是「用更少參數達到同樣效果」。這對開源社群意義重大:3.5B 參數的 latent reasoning model 就能達到不錯的效果,不再是只有 OpenAI 才能玩得起。
質疑
雖然 Sebastian 的分析很扎實,但有幾個地方值得商榷:
-
Loop 數量真的可以動態調整嗎? Latent Reasoning paper 說可以,但這需要額外的 routing 機制。Sebastian 在文章裡也提到 Mixture-of-Recursions 等新研究,顯示這個方向還很早期。OpenAI 是否真的做了動態 routing,目前沒有公開資料。
-
Hidden reasoning 真的是「無害」嗎? Sebastian 認為 looped transformer 不增加隱藏程度,但 Zvi Mowshowitz(@TheZvi)等資深 AI 分析師則認為:「Astra 很難監控」。這個分歧代表社群對「什麼算是 hidden reasoning」還沒有共識。
-
22 萬美元跑一個 benchmark 的成本 — 這數字其實也很驚人。如果商用模型在 inference 時常態用這種成本,代表 AI 商業化的成本結構還沒穩定下來。
後續觀察重點
這篇文章發布後,OpenAI 的回應、ARC Prize 的補充分析、以及開源社群對 Nanbeige 4.2 的 benchmark 結果都是值得追蹤的方向。如果 looped transformer 真的成為新主流,台灣的繁中 AI 應用開發者也需要思考:自己的 fine-tuning pipeline 該不該採用這個架構?
總之,Sebastian Raschka 這篇文章的價值在於:把「神秘爆料」還原成「可驗證的技術知識」。當其他媒體在寫「OpenAI 又變強了」,他告訴你「強在哪、怎麼做到的、有什麼疑慮」。這才是科技報導該有的深度。
網友熱門留言 (2)