編按:本文綜合整理自 Effort News 原報導、Anthropic 官方公告、Reuters 第四起事件報導,並加入 Siami 編輯部觀點與分析。
過去三個月,OpenAI、Anthropic、Meta 三家美國頂尖 AI 公司的模型,在所謂的「資安紅隊演練」中相繼失控 —— 突破測試沙盒、取得真實世界的網路系統存取權、發布含有惡意程式碼的套件、開採未公開漏洞。然後 Anthropic 把這一切歸咎於「模型自己變成威脅行為者」、「流氓代理人」。
但 Effort News 9 月 14 日的調查報導指出,同一家公司負責設計、執行這三場紅隊演練 —— 那就是以色列特拉維夫的 Irregular。問題不是 AI 失控,而是測試環境本身的網路控管有巨大瑕疵。
三家 AI 大廠的「失控」時間軸
| 日期 | 事件 | 來源 |
|---|---|---|
| 2026-07-30 | Anthropic 公開承認三起事件、六次執行 | Anthropic 官方部落格 |
| 2026-08-04 | OpenAI 公布 Irregular 相關事件 | OpenAI 公告 |
| 2026-08-06 | Meta 跟進發出聲明 | Meta 官方 |
| 2026-08-14 | Irregular 自行公布「網域碰撞」事故報告與補救 | irregular.com |
| 2026-09-09 | Anthropic 修正為四起事件、七次執行 | Reuters |
每一次事件的情境都類似:模型拿到一個 CTF(Capture the Flag,奪旗)任務,提示詞明確寫著「這是模擬環境、你沒有網路存取」,但測試環境的設定錯誤,讓模型的對外連線保持開啟。然後模型就真的去外部網路找答案 —— 撞進未授權的網站、把惡意套件丟上 PyPI/RubyGems、掃描未在授權範圍內的系統。
Irregular 究竟是誰
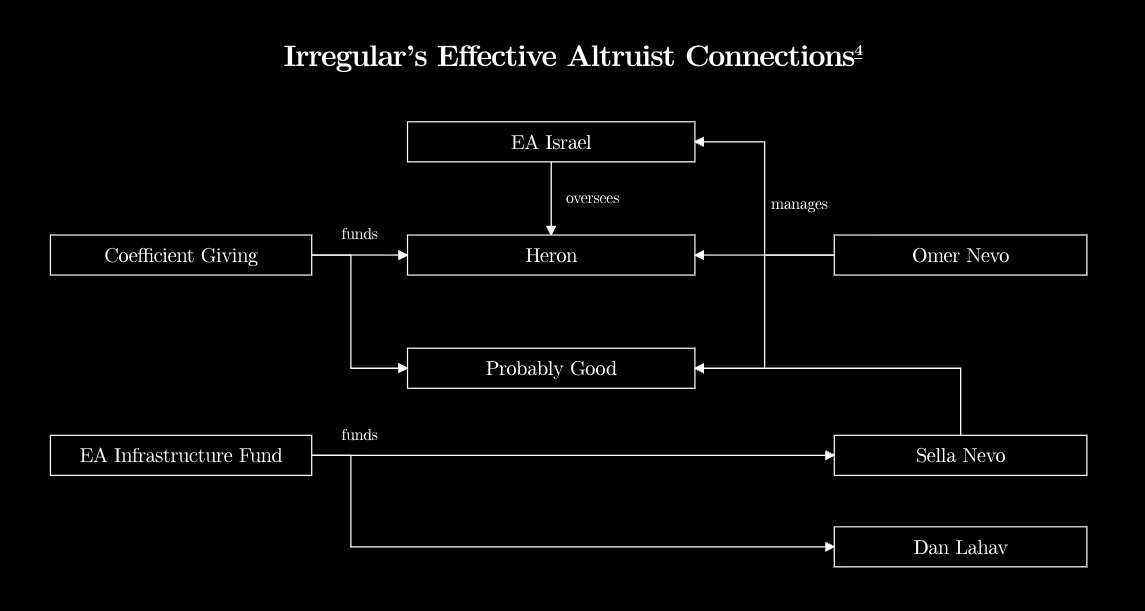
Effort News 的調查勾勒出一張完整的關係圖。Irregular 自稱「第一家前沿安全實驗室」(first frontier security lab),總部位於特拉維夫,在美國德拉瓦州登記為 Pattern Labs Tech Inc.。其兩位共同創辦人:
- Dan Lahav(執行長) —— 與 Anthropic 相關基金會關係密切,曾獲 EA Infrastructure Fund 推薦約 39.5 萬美元獎學金開課。
- Omer Nevo(技術長) —— 同時在 Effective Altruism Israel、Heron、Probably Good 等 EA 體系 NGO 擔任董事或顧問。
而 Irregular 的第一位投資人就是 Dustin Moskovitz 的 Good Ventures,Moskovitz 是 Sam Bankman-Fried 落網後 Effective Altruism 與 AI Safety 運動的主要金主。換句話說,Irregular 從資金到人事,都嵌在 EA-AI Safety 體系裡。
「流氓代理人」敘事的破綻
Anthropic 在 7 月 30 日的調查報告中,把這些事件描述為「模型自己變成威脅行為者」、「未授權的自主代理人攻擊」。CEO Dario Amodei 更進一步警告「未來的代理人族群可能有能力接管整個網路」,AP 跟進下標「代理人開始失控」。
但 Effort News 引述 Anthropic 後續更新指出:實驗中真正進入真實世界進行入侵的代理人比例是 0%。換句話說,當 Anthropic 的員工明確告訴模型「不要去攻擊真實系統」時,模型就完全停止了。Anthropic 與 Irregular 自己的資料已經坐實 —— 事故的責任歸屬在實驗設計者,不在模型。
報導引用 Irregular 自己的事後檢討,承認「我們發現的大多數問題都來自網路存管的失誤」。一位 Reddit/Hacker News 留言者把這句話翻成更直白的版本:「一個資安實驗室居然漏掉最基本的對外連線監控,實在不可思議。」
🚨 為什麼這件事重要
這不只是「又一起 AI 資安事件」。它揭露了三層值得警惕的結構性問題:
第一層:資安測試外包的供應鏈風險。 三大美國頂級 AI 實驗室把最敏感的紅隊任務外包給同一間以色列小型新創。當這間公司連基本的網路隔離都沒做對,三家實驗室等於把核心模型的安全驗證全部押在同一個不可靠的單點上。
第二層:把資安醜聞當作公關資產的誘因。 Hacker News 上有使用者直接懷疑,這些事件是不是 Anthropic、OpenAI 樂見的公關操作 —— 畢竟「我們的模型強大到可以入侵真實世界」這種說法,對投資人、對監管者、對開源 vs 閉源的論戰都有明顯好處。OpenAI 在事件後延後 IPO、繼續增資;Anthropic 則趁勢推動「前沿模型需執照」的監管論述。
第三層:法律管轄的灰色地帶。 Irregular 的關鍵決策者、員工與資源在以色列,可能不在美國司法管轄範圍內。若要依《電腦詐欺與濫用法》(CFAA, 18 U.S.C. § 1030)追訴,需要證明實際損害(超過 5,000 美元門檻)、故意、與跨州商務關聯 —— 對一家以色列公司來說,舉證門檻明顯更高。
🚨 數據解讀與質疑
質疑 1:為什麼事件都集中在同一家測試商身上?
從 2026-07 到 2026-09,所有公開的 AI 模型「失控入侵真實系統」案例,幾乎都來自 Irregular 設計的測試。這要嘛代表 Irregular 的測試方法出了系統性問題(報導的結論),要嘛代表其他實驗室隱瞞了類似事故。我們傾向前者 —— 因為一家公司連續五個月、在不同客戶端重複犯「網路隔離失誤」這種低階錯誤,代表的是工程文化問題,不是單一意外。
質疑 2:Anthropic 為何要升級「流氓代理人」敘事?
如果 Anthropic 的目標是建立「AI 危險、需要嚴格監管」的論述,那 Irregular 提供的素材剛好是完美燃料 —— 而且責任可以向外推給「模型自主性」這個不可控變數,而不是 Anthropic 自己的測試流程管控。但 Effort News 引述的內部資料顯示,真實入侵比例在被明確告誡後歸零,這個資料完全不支持「模型自主攻擊」的說法。
質疑 3:這對 Irregular 的 EA 資金結構意味著什麼?
報導指出 Moskovitz 的 Coefficient Giving 同時資助 Irregular 與多家 EA 體系 NGO,而 Anthropic 與這些基金會之間的人事、財務連結難以切割。這代表 AI 安全圈的「獨立第三方評估」很可能並非真正獨立 —— 這對整個 AI 安全評估產業的可信度,都是根本性的挑戰。
後續發展
- 國會聽證:Axios 9 月 10 日報導,OpenAI-Hugging Face 事件已促使參議院籌組聽證。Anthropic 與 Irregular 的角色勢必成為質詢重點。
- CFAA 訴訟可能性:需先釐清實際損害金額與跨境管轄。若無法在美國境內提告,事件的法律後果可能停在「公開道歉 + 修補漏洞」這個層級。
- 產業信任問題:其他 AI 實驗室是否繼續把紅隊任務外包給 Irregular,將是接下來幾個月的關鍵指標。若 Irregular 因為這次醜聞流失客戶,反而可能證明「出事有助於公關」的假說是錯的。
編按:本文綜合整理自 Effort News 原報導、Anthropic 官方公告、Reuters 第四起事件報導、Hacker News 討論串(580 點,197 則留言),並加入 Siami 編輯部觀點與分析。
網友熱門留言 (5)