編按:本文綜合整理自 Rohan Bansal 原文部落格、Hacker News 討論串、AI/TLDR 報導,並加入 Siami 編輯部觀點與分析。
一個 4B 模型能打敗資料庫嗎?
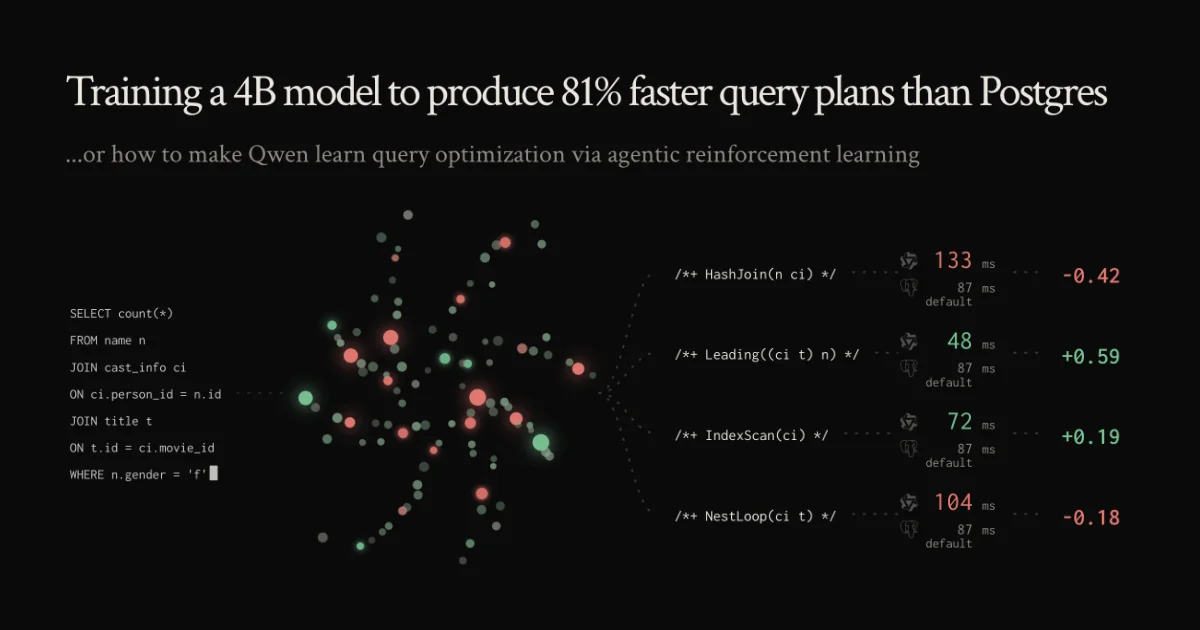
獨立開發者 Rohan Bansal 在 Recurse Center 休假期間,完成了一件多數人認為不可能的實驗:用一個 40 億參數的開源小模型,把 Postgres 預設查詢計畫的執行速度提升了 81%。
這個計畫叫做 QORL(Query Optimization with Reinforcement Learning),程式碼全部公開在 GitHub。整個實驗的硬體成本只有:
- 自架 GPU「FLOPper」跑 Postgres 容器
- Lambda 租的 2×H100 SXM 跑 vLLM + 訓練
- OpenAI API(生成 500 條 GPT-6 Astra agent 軌跡做蒸餾)
總花費約 1,200 美元,耗時約 95 小時。
這件事解決了什麼問題?
Postgres 的查詢規劃器(query planner)有個老毛病:對 join-heavy 查詢的成本估算常常失準。VLDB 2015 與 2025 兩篇經典論文(Leis et al.)相隔十年追問同樣的問題——「查詢規劃器到底行不行?」——結論依然是不行。
更糟的是,join ordering 在數學上是 NP-hard 問題,無法用暴力法窮舉。
Rohan 的切入點很聰明:不去解 join ordering,而是訓練模型給 Postgres「提示」(hint),讓它跳過糟糕的計畫、走更好的實體路徑。模型本身只負責給 hint,真正執行查詢的還是 Postgres。
這就像在說:這個小模型不去重寫規劃器,而是教會一個「顧問」如何提醒規劃器走哪條路更快。
怎麼訓練的?三階段拆解
第一階段:監督式微調(SFT)
先用 OpenAI GPT-6 Astra agent 跑出 500 條高品質的「查詢→提示」軌跡,這些軌跡作為訓練資料,讓一個基於 Qwen 的 4B 模型學會:
- 怎麼讀 Postgres 的統計資訊(relation size、column histogram)
- 怎麼產出
Leading(...)、MergeJoin(...)、HashJoin(...)等 hint - 怎麼在
enable_sort=off、random_page_cost=1.1等參數間取捨
SFT 階段結束後,模型從「完全無法輸出有效計畫」(113 個 JOB 查詢中只能跑 14 個)提升到「可以穩定產出有效 hint」。
第二階段:強化學習 GRPO(客製版)
直接套用 DeepSeek 提出的 GRPO 演算法失敗了——模型學會「裝死」:為了避免被嚴重懲罰,乾脆每次都輸出 Postgres 預設計畫拿小獎勵。
Rohan 改寫了獎勵函數與相對優勢計算:
| 舊 GRPO 問題 | 新設計(Anchored GRPO) |
|---|---|
rollout 比平均好 → 正分,導致模型被「自己比同儕好」的平庸計畫強化 | rollout 比「同儕品質中位數」好 → 正分,基準線更嚴格 |
| 沒產生有效計畫 → 扣 3 分(過於嚴厲) | 沒有效計畫 → 扣 0.1 分(鼓勵探索) |
速度比 clip(0.1, 10) → 直接 log,極端值會 dominate | 速度比先 clip 再 log,並加 soft threshold |
這個新設計叫做 Anchored GRPO——意思是「相對於錨點(baseline)算優勢,而非相對於同儕」。
第三階段:硬體分離(vLLM + Trainer + Postgres 各自獨立)
92% 的 rollout 時間其實花在 vLLM 推論上,只有 8% 在量測查詢。Rohan 把架構拆開:
[Lambda 2×H100]                    [FLOPper 自架桌機]
├─ H100 #1: vLLM 推論              ├─ 4 個 Postgres 容器(用 Tailscale 連)
└─ H100 #2: Trainer 算 loss/更新    │

Rollout 只在「需要量測時」租用 Postgres worker,其他時間讓 vLLM 飽和。
這個設計讓 4 個 Postgres worker 同時支撐 20 個並行 rollout,把 GPU 利用率從不到 30% 拉到 70%+。
數據解讀
最終評估跑在 JOB benchmark(Join Order Benchmark)這套業界標準的 113 條 join-heavy SQL 查詢上:
| 評估方式 | 1.81x 幾何平均加速 | 整體工作量加速 | 勝場:敗場 |
|---|---|---|---|
| 模型自己選(每次 1 條軌跡) | 1.40x | 1.24x | 11 : 7 |
| 每條軌跡內選最佳候選 | 1.44x | 1.29x | 12 : 9 |
| 跨 3 條軌跡選最佳(best-of-15) | 1.81x | 1.81x | 6 : 0 |
1.81x 幾何平均加速 = 44.7% 延遲降低——這是最佳成績,但前提是「每個查詢跑 3 次 rollout、從 15 個候選裡挑最好的」。
模型學會了什麼
從 339 條軌跡分析,模型的「最愛招數」:
Leading(...)改 join 順序:用了 917 次(佔 68%)Parallelhint 強制平行掃描:572 次(42%)- 強制 nested loop 取代 hash join:是它最常贏的場景
enable_sort=off:當排序成本被高估時關掉排序
它不太用的招數:Rows(...) 修正(只用了 146 次)——說明對模型來說,改 join 順序比改成本估算更有效。
為什麼這件事重要
這個實驗不只是「又一個人用 LLM 做 side project」。它驗證了三個正在改變 AI 工程界假設的命題:
1. 小模型不再是「過時的權重」
OpenAI、Google、Anthropic 都在做 100B+ 的 frontier model,但企業真正部署的往往不是它們。Rohan 的 4B Qwen 模型在高度專業的領域任務上打敗了運行數十年的 Postgres 規劃器——這證明:特定領域的強化學習,可以讓小模型發揮超出體型的實力。
2. 強化學習環境的門檻比想像低
整個 GRPO 訓練環境花 1,200 美元搞定,包含 GPU 租賃與 API 成本。對比 DeepSeek-R1 訓練花費數百萬美元,這是兩個數量級的差距。Rohan 在文章裡直接推薦了 Prime Intellect、Tinker、River AI、Baseten 等開箱即用的 RL 訓練平台,門檻已經降到「一個獨立開發者 + 一個信用卡」。
3. 「AI 顧問」比「AI 替代者」更務實
QORL 沒有試圖取代 Postgres 規劃器,而是給它「提示」。這是個非常成熟的設計哲學——用 LLM 補足傳統系統的盲區,而非從零重寫。這個模式可以套用到無數場景:搜尋引擎排序、編譯器最佳化、Linux 核心排程器。
質疑與限制
Hacker News 討論串裡有不少理性的質疑,整理三個最重要的:
質疑 1:基準太小,且刻意壓低 Postgres
JOB benchmark 的 IMDb 資料集只有約 8GB,完全塞得進現代伺服器的 RAM。Rohan 自己也承認把 shared_buffers 設成較小值來模擬「規劃器在沒快取幫助下做決策」的真實情況。
但這代表:在生產環境(TB 級資料、需要 disk I/O)的場景下,Plan 的好壞差異不會像 8GB 資料集這麼顯著。Postgres 的預設計畫在資料完全 in-memory 時本來就會偏保守。
質疑 2:113 個查詢是「同質」任務
JOB 的查詢雖然 join 重,但 schema 固定(IMDb 模式)。QORL 模型沒在其他 schema(如金融、電商、IoT 時間序列)測過。
質疑 3:Rollout 的成本被低估
$1,200 是「訓練成本」,但實際部署時每個查詢要跑 3 次 rollout 再挑最好的——這等於把查詢延遲乘以 3 倍。如果單次查詢只要 10ms,3 次 rollout 可能要花 30ms+ 才決定用哪個計畫,反而比直接跑預設計畫慢。
後續發展與資源
- 程式碼:github.com/polyphilz/qorl
- 作者 X 帳號:@polyphilz
- 延伸閱讀:Bao: Learning to Steer Query Optimizers(Marcus et al.,SIGMOD 2021)—— 用監督式學習做 hint steering 的經典論文
- 延伸閱讀:DeepSeek-R1: Incentivizing Reasoning in LLMs via RL—— Rohan 自承他的 GRPO 設計靈感來自這篇
- 延伸閱讀:On-Policy Distillation—— Thinking Machines 對「為什麼 on-policy 比 off-policy 蒸餾更好」的解釋
Rohan 在文末列出他想嘗試的下一步:
- 把 hint sweeping 結構化(Bao 風格)看是否比 4B 模型更有效
- 試 on-policy 蒸餾(vs 他這次用的 off-policy)
- 在專用 EC2 box 上量測「被獎勵函數欺騙」的雜訊
Siami 編輯部觀點
這篇文章最值得科技圈注意的是 「強化學習民主化」的訊號。
2024 年 DeepSeek-R1 讓大家看到 RL 可以激發推理能力,但那需要國家級算力。2026 年 QORL 證明:即使是一張信用卡、一個獨立開發者,也能用 RL 把開源小模型訓練到「特定領域專家」等級。
這對企業 IT 的意義是——那些曾經以為「必須用 frontier model 才能做好」的場景(SQL 優化、log 分析、客服分流、文件摘要),現在可以用 1% 的成本、5% 的參數量,達到 80% 的效果。
Siami 會持續追蹤這類「小模型 + RL + 領域專家」的故事,因為它代表 AI 產業的下個階段:不是更大的模型贏,而是更精準的微調贏。
網友熱門留言 (3)