編按:本文綜合整理自 NVIDIA Developer Blog、arXiv 論文 2606.15991、NVlabs/cuda-oxide GitHub、nvlabs/cutile-rs GitHub、RustConf 2026 議程,並加入 Siami 編輯部觀點與分析。
2026 年 9 月,NVIDIA 正式宣布全面擁抱 Rust 進行原生 GPU 程式設計。CUDA C++ 與 CUDA Python 已是成熟的企業級工具鏈,NVIDIA 將把 CUDA Rust 培育成熟,目標是 2027 年之後。這一步,等於把 GPU kernel 開發從「CUDA C++/Python 包裝 Rust」的舊思維,推進到「直接寫 Rust、原生編譯成 PTX」的新紀元。
為什麼 NVIDIA 要做這件事?
AI 系統層由推論引擎、服務基礎設施、驅動程式、agent runtime 組成——這些東西隨著模型與技術迭代而不斷翻新。越來越多是用 Rust 寫的,因為 Rust 能在編譯期就擋下一整類 bug,又不犧牲效能。NVIDIA 自己也是這個趨勢的一部分:Nova Linux driver 是 Rust 寫的,NVIDIA Dynamo 以 Rust 為核心,NVTX 也有 Rust binding。
唯一例外是 GPU kernel。你可以從 Rust launch kernel,但 kernel 本身往往得用別的語言寫。NVIDIA CUDA Rust 把這個缺口補起來——GPU kernel 可以直接用 Rust 寫、原生編譯成 PTX,不再是「包裝別人程式碼」的呼叫介面。
「The GPU kernel is the exception. You can launch kernels from Rust, but the kernel itself often has to be written in another language. NVIDIA CUDA Rust closes that gap.」—— NVIDIA Developer Blog
兩條平行軌道:SIMT 與 Tile
NVIDIA 把 Rust 對應到 CUDA 自己的兩條軌道:
- SIMT:你寫的是「單一執行緒做什麼」,然後 launch 數千個。這是 CUDA C++ 與 numba-cuda 的既有典範。
- Tile:較新的典範(C++/Python 也有),你寫的是「一個 tile 的資料做什麼」,Tile IR 編譯器處理剩下的對應。NVIDIA 建議優先選 Tile,因為編譯器決定 tile 怎麼對應到各種架構,原始碼不需要寫死架構專屬決策。需要精細控制或手動管記憶體時再退回 SIMT。
兩個專案都還在早期階段,都不是 production-ready:
| 專案 | 對應典範 | Rust 版本 | 工具鏈需求 | 成熟度 |
|---|---|---|---|---|
| cuda-oxide | SIMT | Pinned nightly | 需要 CUDA 12.x+、clang + libclang、可選系統 LLVM | early alpha |
| cutile-rs | Tile | Stable Rust 1.89+ | CUDA 13.3、無需自訂 LLVM | 已上 crates.io,被 HuggingFace Grout 與 mistral.rs 採用 |
cuda-oxide:自訂 rustc codegen backend
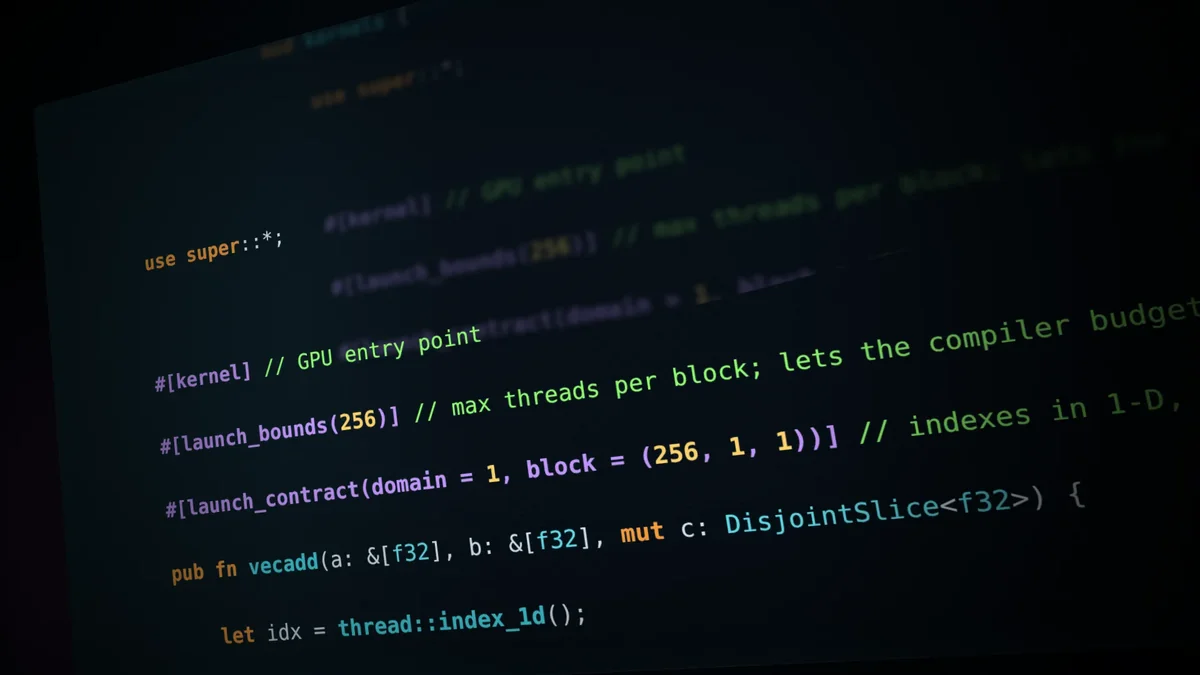
cuda-oxide 是自訂的 rustc codegen backend。它攔截編譯、把 #[kernel] 函式路由經過 Rust MIR、社群的 Pliron IR 框架、再到 LLVM IR,最後輸出 PTX;其他非 kernel 程式碼交給標準 backend。GPU dialect 全程留在 Rust,直到標準 LLVM backend 接走。安裝流程:
cargo +nightly-2026-04-03 install --git https://github.com/NVlabs/cuda-oxide.git cargo-oxide
cargo oxide new vecadd_demo
cd vecadd_demo
cargo oxide doctor
cargo oxide run
第一次 cargo oxide run 會編 codegen backend,會比較慢;之後會重用 cache。它會印出 PASSED: all 1024 elements correct。
cutile-rs:Tile 典範、stable Rust
cutile-rs 走 Tile 典範,用 stable Rust(1.89+)、CUDA 13.3、不需要自訂 LLVM。它已發布到 crates.io,被 NVIDIA 之外的專案採用:
- HuggingFace Grout 推論引擎
- mistral.rs 推論引擎
記憶體安全:兩種做法的差異
兩個專案都能在編譯期抓到 aliasing 錯誤,但畫線位置不同:
- cuda-oxide:
DisjointSlice型別保證每個 thread 拿到自己元素的「獨佔寫入權」,並用#[launch_contract]在每次 launch 時檢查啟動配置。&mut [f32]是錯的形狀——多 thread 對同一 slice 寫會 race。 - cutile-rs:ownership 直接跟著 tensor 跨過 launch 邊界——這是更強的保證。Tile block 是單一邏輯執行緒,沒有 shared memory 與 thread indexing 可以寫錯。
SIMT 保留對 shared memory 的控制權,但目前 shared memory 仍需要
unsafe。Shared memory 是高效 SIMT kernel 的基石,把這條路徑變安全是「active work」。
🚨 為什麼這件事重要
NVIDIA 把 CUDA 帶進 Rust 不是單純「加一個 frontend」,而是 GPU 程式設計十年來最重要的典範轉移之一。三個層面的影響:
1. 把 Rust 的安全保證推進到 GPU 最後一哩
過去 Rust 在 GPU 棧上只涵蓋 driver 與 framework——kernel 本身仍是 CUDA C++ 的天下。CUDA Rust 把 Rust 的編譯期檢查延伸到最關鍵、最容易出錯的環節:thread 對記憶體的存取。這對 AI 推論引擎、自動駕駛、醫療影像等高可靠性場景的意義,遠超過「換個語言寫 kernel」本身。
2. 兩條軌道給開發者選擇權
NVIDIA 明確表示「優先選 Tile,需要時退回 SIMT」。這不是「一刀切換掉 CUDA C++」,而是給既有 C++/Python 開發者一條平滑的 Rust 遷移路徑。並規劃 inter-language interop,未來 Rust kernel 跟 CUDA C++/Python kernel 可以互相呼叫。
3. NVIDIA 跟 Rust 社群的合作模式
rust-cuda、rust-gpu、cudarc 都是社群主導的專案。NVIDIA 在這次公告中明確點名這些專案(包含 VectorWare 團隊),表示未來會「合作而非取代」。對 Rust 社群來說,這是 GPU 程式設計從「愛好者專案」走進「企業級基礎建設」的訊號。
🚨 數據解讀與質疑
| 指標 | 數據 | 觀察 |
|---|---|---|
| cutile-rs 效能 | 在 NVIDIA B200 上達到 7 TB/s element-wise、2 PFlop/s GEMM(96% cuBLAS) | 已逼近 cuBLAS 原生效能,證明「安全 ≠ 慢」 |
| rust-cuda 生命週期 | 超過 5 年,曾沉寂 2 年,現已重啟運作 | NVIDIA 選在此時公告不是巧合 |
| Hacker News 熱度 | 437 分、157 回應,發文 1 週內衝上 HN Top 1 | 開發者社群高度關注 |
| reddit/r/rust 討論度 | 「期待 LLM 還沒訓練過的新技術」 | 暗示 Rust GPU kernel 將成為新一波學習熱點 |
幾個值得質疑的點:
- AI 代筆疑慮:HN 上
@nicebyte直接批評「NVIDIA 沒人在乎這個專案,才會讓 AI 代筆公告」。但 NVIDIA 在公告中標註「Powered by NVIDIA Nemotron」,是刻意的——AI 摘要 + 人工內容是企業 blog 的新標準,文章正文仍由 NVIDIA 員工撰寫。 - 預期不穩定期:兩個專案都「early-stage」,API 會動、coverage 不完整。生產環境建議觀望,學習與 POC 階段現在就可以開始。
- 生態系分散:rust-cuda、Rust-GPU(SPIR-V 路線)、CubeCL、cudarc 並存,各有取捨。NVIDIA 的兩個專案填補「官方原生 CUDA 對應」,但不是「唯一的 Rust GPU 路線」。
RustConf 2026 演講
Melih Elibol(NVIDIA 資深研究科學家,cutile-rs 的創造者)於 RustConf 2026(2026 年 9 月 8-11 日,蒙特婁)發表演講「Fearless Concurrency on the GPU」,介紹如何把 Rust 的安全保證帶進 GPU kernel 程式設計。arXiv 論文 2606.15991 已於 2026 年 6 月公開。
現在可以做的事
- 跑 SIMT 範例:
cargo oxide new→cargo oxide run(cuda-oxide) - 跑 Tile 範例:clone cutile-rs →
cargo run -p cutile-examples --example hello_world - 讀文件:cuda-oxide book 與 cuTile Rust documentation
- 讀論文:「Fearless Concurrency on the GPU」(arXiv 2606.15991)
- 回報 issue:在 cuda-oxide 或 cutile-rs 的 GitHub repo
- 參加討論:兩邊的 GitHub Discussions、cuda-oxide Discord
- 現場交流:RustConf 2026(蒙特婁,9/8-11),NVIDIA 團隊會在現場
網友熱門留言 (5)