感謝 IT 之家網友西窗、補藥吖、不一樣的體驗、iasky 的線索投遞!
IT 之家 9 月 18 日消息,華為 9 月 17 日在上海發布 AI 時代的全新計算架構 Peerium,稱該架構可實現百萬級處理器作為一台計算機協同工作,以滿足持續增長的 AI 算力需求。
華為介紹稱,Peerium 計算架構基於巢狀平行、統一記憶體尋址和平等互聯,實現百萬級處理器的強擴展能力,徹底突破了馮·諾依曼單機架構的限制。
同時,該架構提出 Nested BSP(巢狀批次同步平行,一種將平行計算任務分層遞迴組織的計算範式),突破了傳統圖靈範式的限制。
華為表示,Peerium 架構顛覆了長久以來的主從架構。馮·諾依曼體系結構要求計算機按程式順序執行,運算器、控制器、儲存器、輸入與輸出系統各司其職,主從關係貫穿其中。
其中,靈衢是實現 Peerium 架構的關鍵互聯技術。華為介紹稱,靈衢基於一個開放協議,可無限擴展地聯接 CPU、NPU、記憶體、SSD、網卡和交換器,實現計算、儲存與網路的平等互聯。
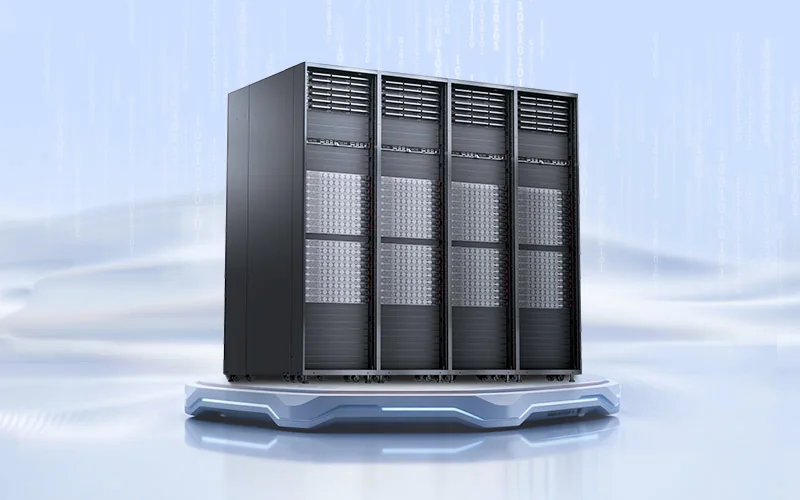
Atlas 950 超節點是 Peerium 計算架構的首代產品。華為稱,25.6 萬卡 Atlas 950 超節點叢集已在部署中,基於 NPO 的 Atlas 960 系統正在測試中。
華為輪值董事長徐直軍表示:「AI 時代,華為基於開創的 Peerium 計算架構,持續打造滿足客戶訓練和推理需求的超節點和叢集,讓算力無處不在,讓智慧無所不及。」
IT 之家附論文網址:https://doi.org/10.48550/arXiv.2609.16787
編按:本文綜合整理自 IT 之家(ithome.com)2026 年 9 月 18 日報導〈華為開創 Peerium 計算架構:突破傳統圖靈範式與馮·諾依曼單機架構的限制〉,並加入 Siami 編輯部觀點與分析。原文連結:https://www.ithome.com/1/003/910.htm。其他參考來源:路透社 https://www.reuters.com/world/asia-pacific/chinas-huawei-launch-two-new-ai-chips-2027-2026-09-17/、華為官方新聞 https://www.huawei.com/cn/news/2026/9/new-computing-architecture-peerium。
什麼是 Peerium 架構
Peerium 並非單一晶片,也不是新一款 NPU 的命名,而是華為在「算力成為 AI 時代瓶頸」這個命題下,提出的一整套叢集級運算藍圖。
傳統 AI 訓練叢集依賴馮·諾依曼架構的延伸:每台伺服器是一台完整的電腦,內含 CPU、記憶體、加速卡;伺服器之間再用乙太網路或 InfiniBand 連接,靠 NCCL 之類的集體通訊函式庫維持同步。這種模式在數千張加速卡等級還算順暢,但規模拉到萬卡以上時,效能與擴展性都會遭遇瓶頸。
華為在發布會上把這道瓶頸命名為「馮·諾依曼單機架構的限制」,並提出三項對應的解法:
- 巢狀平行(Nested BSP):把整個叢集切成多個「超節點」,每個超節點內部執行 BSP 同步,跨超節點再做鬆耦合同步,避免同步成本隨整體規模失控。
- 統一記憶體定址:整個超節點共用一個邏輯記憶體空間,開發者像寫單機程式那樣分配 tensor,不必擔心資料實際落在哪張加速卡。
- 平等互聯(靈衢 UnicomLink):CPU、NPU、記憶體、SSD、網卡、交換器對等通訊,沒有主從關係。
這三項加在一起,目標是把「一台電腦」的邊界從機櫃擴大到整個叢集。
為什麼這件事重要
AI 算力競爭的焦點,已經從「誰能買到最多 GPU」轉向「誰能把更多 GPU 串起來還能穩定跑」。NVIDIA 真正的護城河不是 H100、Blackwell 這些晶片本身,而是 NVLink、NVSwitch、InfiniBand、CUDA、NCCL 這整套叢集級基礎設施。
華為這次出手的訊號有三個:
- 不再單獨賣 NPU,而是賣整套叢集:Atlas 950 不是加速器,而是 25.6 萬張卡綁在一起的「一台電腦」。
- 擁抱開放協議:在中國半導體被制裁的當下,自己定義標準才能不被人卡脖子。
- 時間點很微妙:9 月 17 日選在上海華為全聯接大會前一天,明顯是衝著 NVIDIA 9 月底 GTC Washington 而來。
對台灣與全球 AI 供應鏈而言,這代表兩件事:
- 客製化 AI 晶片 + 自有互聯架構正在從實驗室概念變成客戶願意付錢的產品。鴻海、廣達、緯穎這些幫 NVIDIA 與 AMD 做白牌伺服器的廠商,未來可能也會接到「全套方案」訂單。
- CUDA 的護城河被侵蝕的速度可能比預期快。當華為、Tenstorrent、Cerebras 都推出自己的叢集抽象層,開發者被迫重新思考「模型平行 + 硬體平行」的介面該長什麼樣。
數據解讀與質疑
幾個必須誠實面對的問題:
1. 25.6 萬卡這個數字是怎麼算的?
華為沒有公布單顆 NPU 的具體型號與算力(TOPS 或 FLOPS)。所謂 25.6 萬卡,是指 Ascend 系列加速卡的總數量,不是直接拿來跟 NVIDIA Blackwell B200 對標。實際叢集利用率、訓練吞吐量、與 H100/MI300 的等效比較,華為目前沒有公開 benchmark 數據。
2. Nested BSP 並非全新學術概念。
BSP 模型在 1990 年代由 Valiant 提出,Google 的 Pregel、Apache Giraph、華為自家的 MindSpore 都用過 BSP 變體。華為的創新在於把 BSP 巢狀化並硬體化到互聯層,這的確是工程突破,但學術原創性有限。
3. 靈衢的「開放協議」是什麼標準?
目前沒看到華為提交 IETF、IEEE 或其他標準組織的紀錄。沒有第三方路由器、白牌交換器可以互通,這個「開放」目前只是相對於 NVIDIA 的「封閉」而言。等到真正有合作廠商加入(Broadcom、Mellanox 之外的玩家),才能驗證「開放」是不是行銷用語。
4. 學術論文 arXiv:2609.16787 的可重現性。
IT 之家附了 arXiv 連結,但論文 9 月 17 日才上架,目前沒有獨立的第三方重現實驗。要等 ICLR、NeurIPS 2026 的審稿結果出爐,才能判斷 Peerium 的設計是否禁得起學界檢驗。
短中期時間表
| 時間 | 預期事件 |
|---|---|
| 2026 Q4 | 華為首批 Atlas 950 商用交付(中國客戶為主) |
| 2027 Q1 | 昇騰 960 提前發布(華為輪值董事長汪濤已宣布) |
| 2027 H1 | 靈衢協議可能提交 IEEE / OCP 標準組織 |
| 2027 下半年 | NVIDIA Vera Rubin(200GW 級)正面對決華為 Peerium 叢集 |
結論
Peerium 不是「中國版的 NVIDIA」,而是華為押注「叢集即電腦」這個典範轉移的具體實踐。它的成敗不在單顆晶片的峰值算力,而在互聯、記憶體一致性、軟體棧三個層面的整體工程能力。
短期內,華為的主要客戶仍在中國(受制裁限制下別無選擇);中期若靈衢真的走向開放,這條路線有可能成為 NVIDIA 之外,第二條可規模化的 AI 算力底層。
參考資料
- IT 之家原文:https://www.ithome.com/1/003/910.htm
- 路透社報導:https://www.reuters.com/world/asia-pacific/chinas-huawei-launch-two-new-ai-chips-2027-2026-09-17/
- 華為官方新聞稿:https://www.huawei.com/cn/news/2026/9/new-computing-architecture-peerium
- 華為全聯接大會 2025 主題演講(Atlas 950 基礎):https://www.youtube.com/watch?v=QT88jvg3AYg
- arXiv 論文:https://doi.org/10.48550/arXiv.2609.16787