編按:本文綜合整理自 Laya 官方網站、GitHub 開源專案、Hugging Face 模型卡、作者 Dev.to 長文、arXiv 論文 2503.23303 與 2510.01237,以及 Hacker News 討論串(1251 分、71 則留言)。內容包含 Siami 編輯部觀點與分析。
一週前默默誕生、三天內衝上 HN 第一名
2026 年 9 月 18 日,印度 AI 開發者 Nandakishor M(Convai Innovations 創辦人、前 IIT Palakkad Technology IHUB Foundation 主研究員)在 GitHub 開源了一個叫 Laya 的專案。Apache 2.0 授權、Python 實作、三個模型權重全部上 Hugging Face。三天後,這個專案衝上 Hacker News 第一名,拿下 444 分、102 則留言(後續滾到 1251 分、71 條頂層討論)。標題很直接:「Laya the open source version of Jev」。這個標題背後的故事,比技術本身更值得談——因為它牽涉到一位前 OpenAI 共同發明人創辦的新創公司、一份被忽略一年的開源研究、以及「做對的事卻沒人看見」這個 AI 圈的老問題。
Laya 是什麼?把 LLM 換成「決策專用」的引擎現代 AI 系統每天都會做大量「反射決策」:客服信件進來要分到哪個部門、這段 prompt 是不是 jailbreak、這則留言是不是釣魚訊息、這個客訴多緊急。傳統做法是呼叫一個 8B 或 70B 的大型語言模型,等它生成幾百個 token,再寫 regex 把答案挖出來。這個流程至少有四個毛病:
- 慢:單次呼叫 500 到 2000 毫秒,因為要等 token 一個個生成
- 貴:每次推理都要付完整 LLM 的錢
- 不準:要 parse 自由格式文字才能拿答案
- 會幻覺:LLM 說「信心 0.95」只是選了聽起來自信的 token,背後沒有數學依據
Laya 不一樣。它是 System 1 決策引擎:輸入一段狀態(email、ticket、JSON)和幾個「有型別的問題」,單次 forward pass 同時回答所有問題,只花 33 毫秒。它不生成文字,所以沒有 hallucinate 的空間,輸出永遠是結構化的 JSON。三種輸出型別:
| 型別 | 輸出 | 用途 |
|---|---|---|
choice | 從字典選一個 label + 每個選項的機率 + 信心分數 | 部門分流、intent 分類、主題標註 |
score | 0–3 之間的 ordinal 評分 + 分布 + 信心 | 客戶挫折感、ticket 緊急度、prompt 傷害嚴重度 |
noul | 校正過的布林機率 P(true),0.0 到 1.0 | 釣魚偵測、垃圾訊息過濾、jailbreak 偵測、流失風險 |
關鍵是它的訓練方式叫 RLCD(Reinforcement Learning for Calibrated Decisions)——用強化學習搭配嚴格正確的評分規則(log + spherical + ranked probability score)來訓練模型。誠實回報機率是唯一能拿滿分的策略,所以信心分數不是後加工,是數學上的校準結果。
三個 checkpoints + 一個會自動選的 Router
Laya 一次發了三個模型:
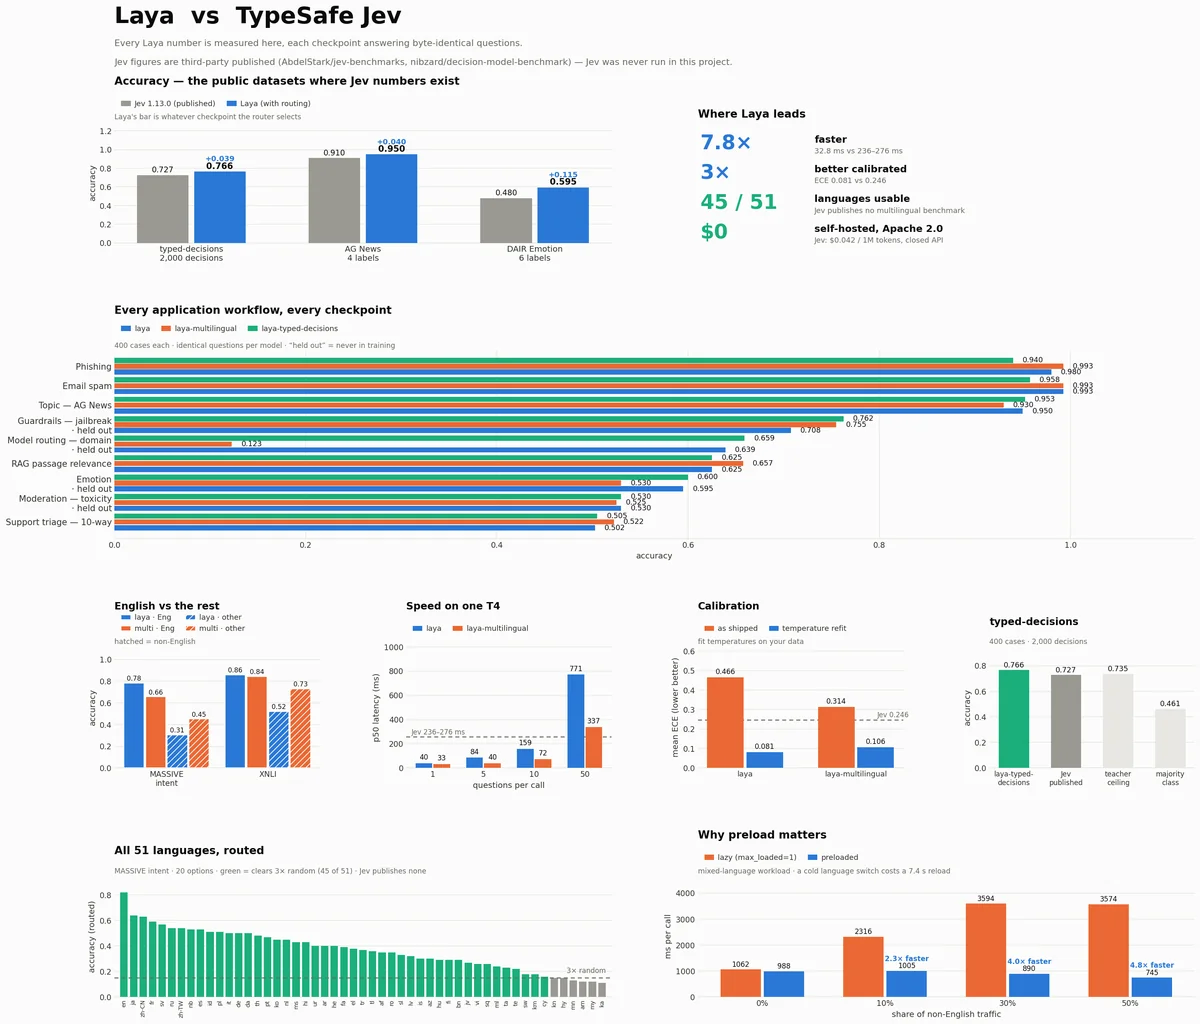
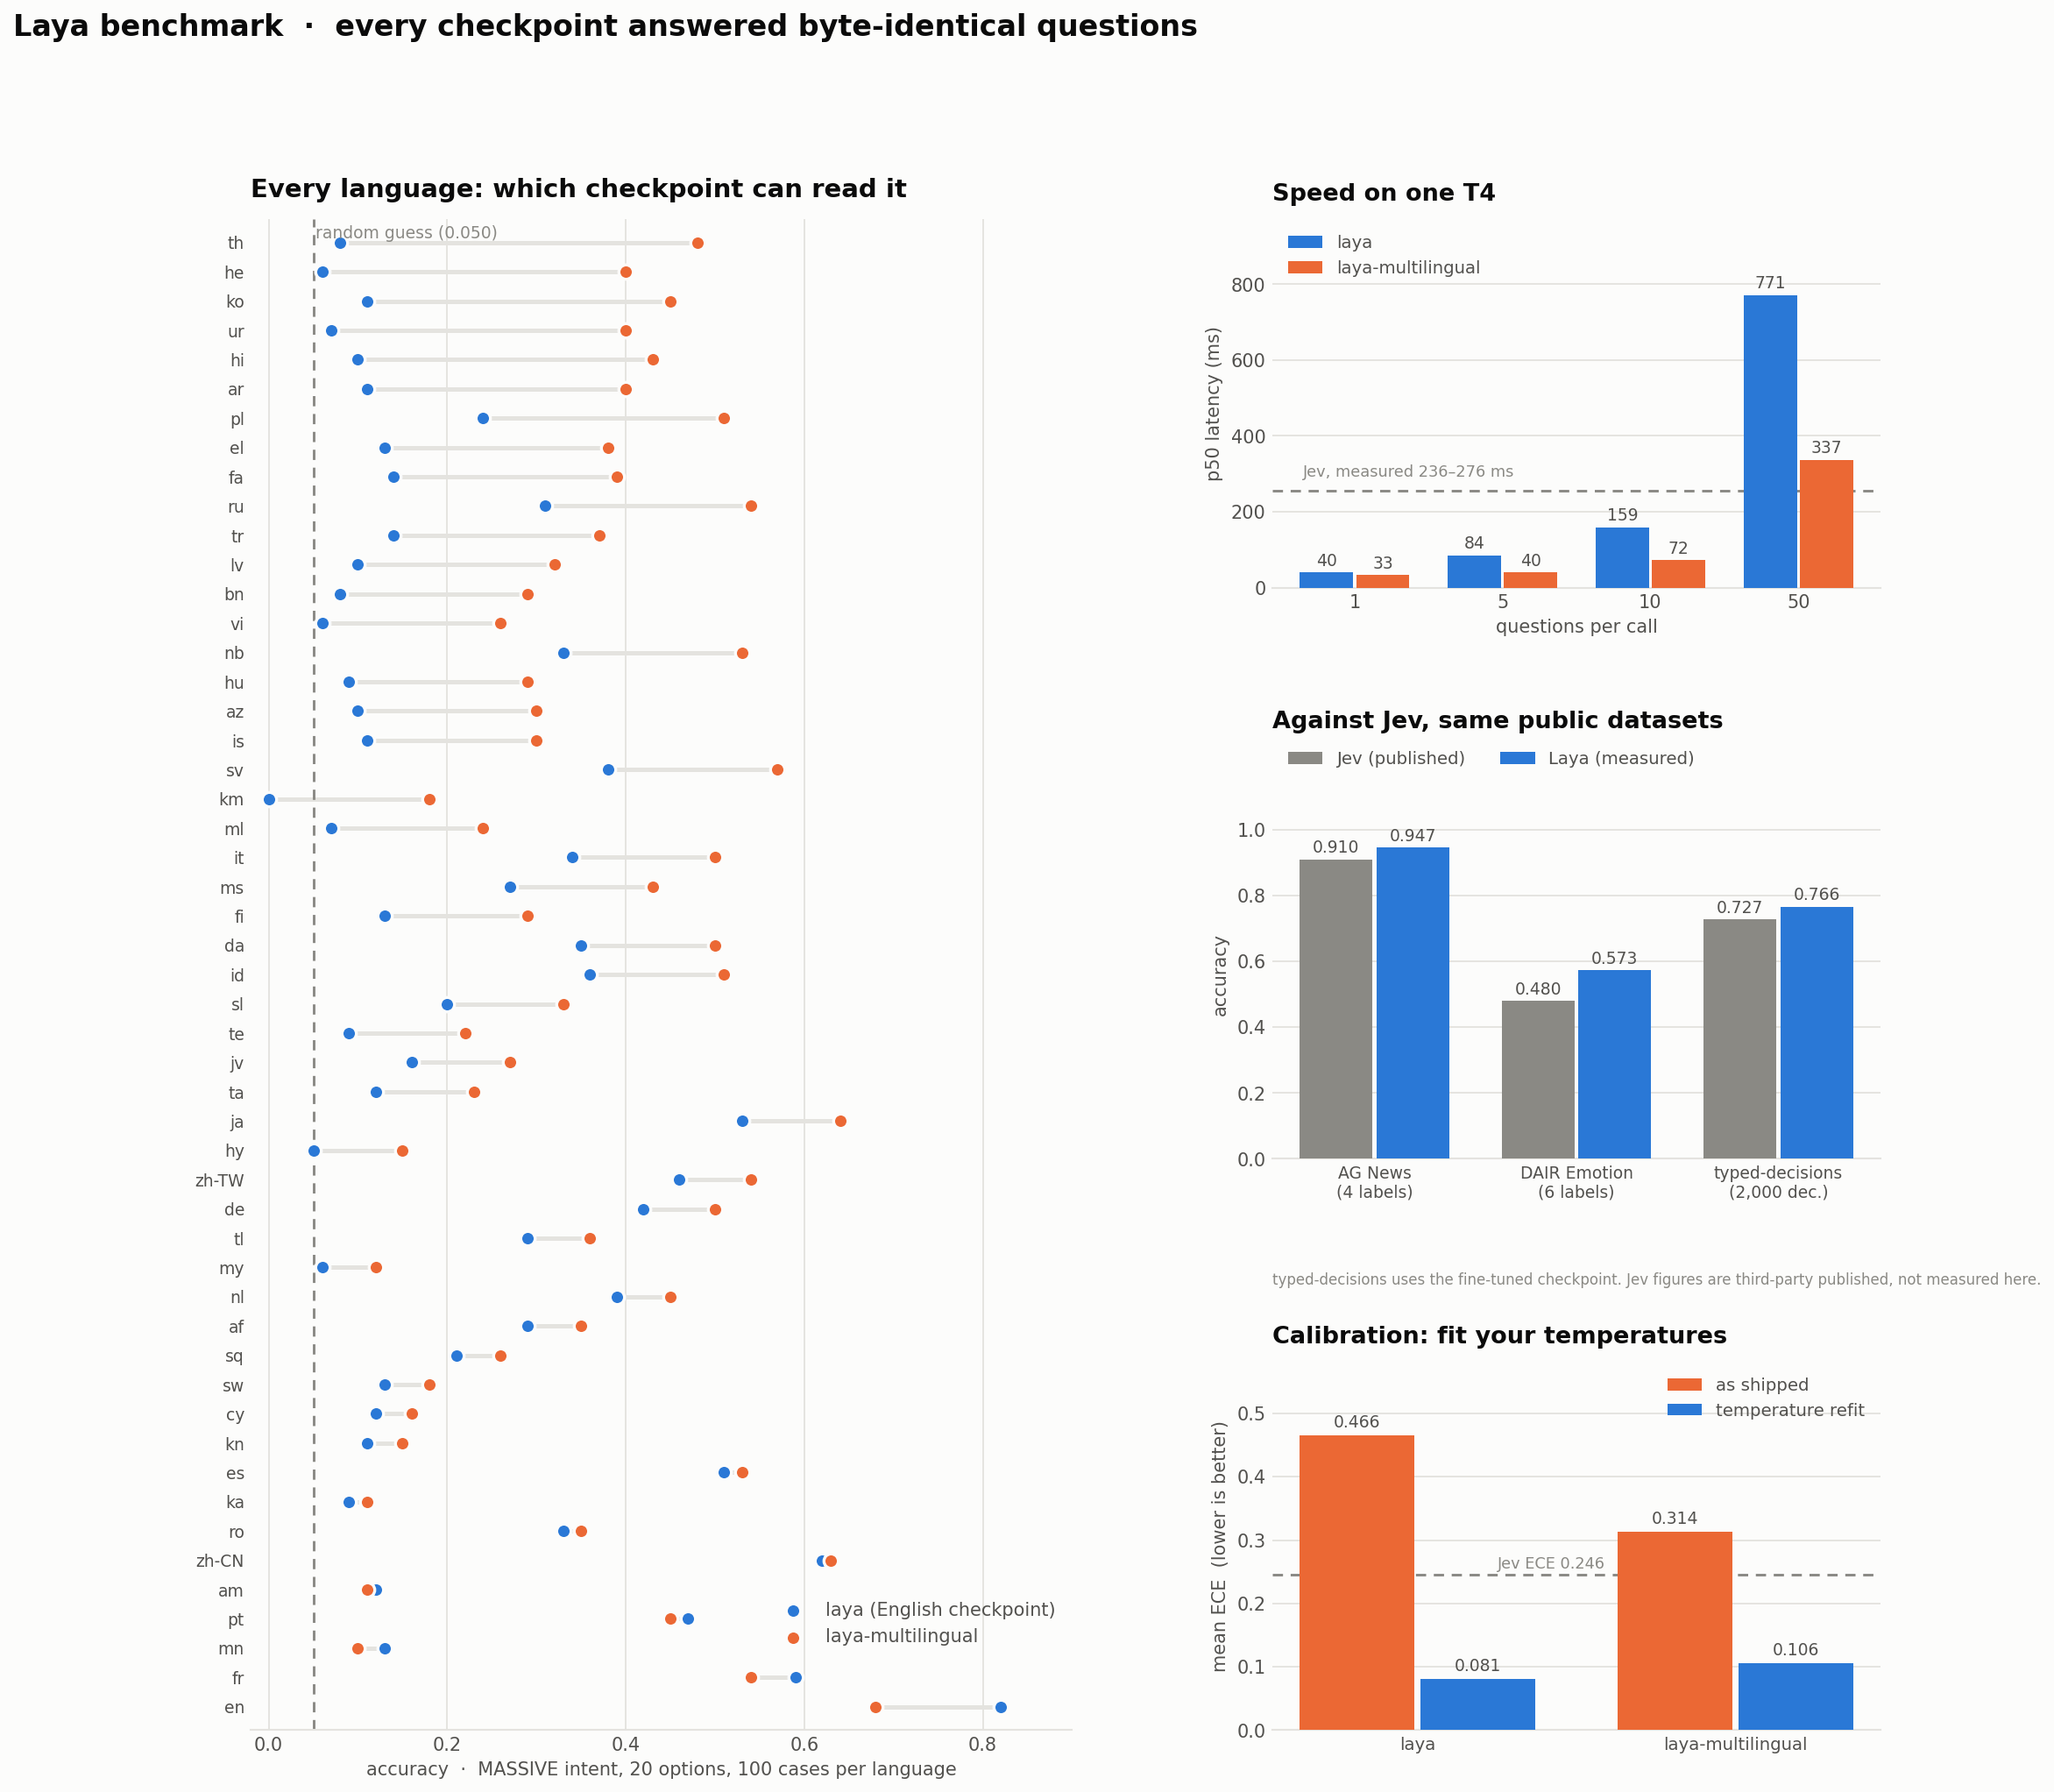
convaiinnovations/laya:ModernBERT-large 骨幹,421M 參數,512 token context,英文最強convaiinnovations/laya-multilingual:mmBERT-base,322M 參數,1024 token context(可到 8k),支援 100+ 種語言,比英文版快 2.2 倍convaiinnovations/laya-typed-decisions:ModernBERT-large,421M 參數,1024 context,針對四種典型工作流(發票處理、安全事件、客服、agent 追蹤)做過微調外加一個 Router——它在 forward pass 前先用 Python 偵測輸入語言(< 0.5 毫秒),然後選最適合的 checkpoint。官方數據:英文版碰到高棉語時會給出「95.2% 信心但正確率 0.000」這種災難,Router 可以在錯誤發生前提早避開。
為什麼作者說這是「被偷走的點子」?
Laya 的故事要從 2025 年 3 月說起。
Nandakishor M 那時發了第一篇 arXiv 論文(2503.23303),標題是「SalesRLAgent: A Reinforcement Learning Approach for Real-Time Sales Conversion Prediction and Optimization」——用強化學習預測銷售對話的轉換率,把每個對話當 sequential decision problem,輸出 0.0 到 1.0 的機率。同年他開源模型權重(Hugging Face 上的 sales-conversion-model-reinf-learning)、發了開源資料集、發了 PyPI 套件、在 r/LocalLLaMA 發文。
2025 年 9 月,他發了第二篇論文(2510.01237),把框架擴展成「schema-based decisions guided by reinforcement learning」。然後 2026 年 9 月,一家叫 TypeSafe AI 的新創公司——由 OpenAI ChatGPT 共同發明人 Diogo Almeida 創辦——推出了 Jev。他們把同樣的概念包裝成「突破性新架構」,聲稱是「非自回歸、不會幻覺的 System 1 思考模型」,用了 Laya 作者原創的術語「RLCD」,沒有發技術論文、沒有開源模型權重、沒有開源訓練資料,每百萬 input token 收 0.042 美元,延遲約 150 毫秒。作者在 Dev.to 的長文裡說得直接:
「在開源圈,這就是你預期會發生的事 🙂。所以我決定把 2025 年 3 月和 9 月學到的所有東西、把舊方法的所有架構限制都修掉,做成一個完全開源的、水平的 System 1 決策模型。結果是它跑在 GPU 上只要 33 到 38 毫秒,比 Jev 公開的 150 毫秒快了 4 倍,而且是 100% 開源。」
Laya vs Jev:不是 PR 稿,是有數字的比較官方 README 給了 Laya(用 Router)跟 Jev 1.13.0 的直接比較。所有 Laya 數字是「Router 真的吐出來的」——也就是根據輸入語言自動選的那個 checkpoint,不是挑最好看的。Jev 的數字是他們自己公開的(沒有 TypeSafe API 可重現測)。
| 指標 | Jev 1.13.0 | Laya (routed) | 差異 |
|---|---|---|---|
| typed-decisions, 2,000 決策 | 0.727 | 0.766 | +0.039 |
| AG News, 4 labels | 0.910 | 0.950 | +0.040 |
| DAIR Emotion, 6 labels | 0.480 | 0.595 | +0.115 |
| Banking77(72 vs 77 labels) | 0.870 | 0.425 | Jev 在 >20 選項時領先 |
| ECE(越低越好) | 0.246 | 0.081 | 校正後好 3 倍 |
| p50 延遲(單題) | 236–276 ms | 32.8 ms | 快 7.8 倍 |
| 支援語言 | 未公開 | 51 種 | — |
| 權重 | 閉源 API | Apache 2.0 | — |
| 成本 | $0.042 / 1M tokens | $0 自架 | — |
重點不是「Laya 在所有項目贏」——它在高基數選項(Banking77, 77 個 label)輸,因為 token budget 被切散;在 soft distribution matching 略輸(Jev 的分布更貼近教師模型)。但它在延遲、價格、開源、校正度、英文以外語言這些地方全面碾壓。
為什麼這件事重要這篇文章有兩層意義,技術面跟產業面要分開看。
技術面:開源圈多了一個實用的「System 1 替代品」。如果你今天在做客服分流、jailbreak 偵測、ticket triage、內容審核這些任務,以前你可能為了圖方便呼叫 LLM,現在 Laya 給你一個 33 毫秒、自己 host、Apache 2.0 的替代方案。三小時部署時間、pip install laya 就能用、Colab 也有 notebook。對一個印度獨立開發者來說,這是相當完整的工程交付。
產業面:這個事件戳到 AI 圈一個反覆發生的痛點——「同一個概念,誰先講好故事誰就贏」。原作者 Nandakishor 2025 年就發了論文、open-weight、open dataset,但因為他做的是「垂直的銷售轉換率」(用詞冷僻、場景單一),沒人轉發;TypeSafe 把同一個概念水平化、重新命名成「System 1」「RLCD」「non-autoregressive decision model」,配上「OpenAI 共同發明人」的創辦人敘事,立刻被封為「突破」。
HN 留言串(71 則頂層)裡最有共鳴的一則(@johnfn,15 則子留言)說得很直白:「這是一個老故事——人們不理解行銷和品牌的重要性。Jev 的網頁讓任何人看一眼就懂,OP 的『行銷』只是一篇標題叫『Predicting sales conversion probability from conversations using pure Reinforcement Learning』的 Reddit 貼文。」另一則(@Oras,12 則子留言)則從 NLP 老兵的角度補刀:「這東西本質就是 BERT 加更多資料。我相信很多實驗室都能複製出來。」
數據解讀:開源真的能追上閉源嗎?這次事件有三個數字值得單獨看:
第一個數字:3 天 2540 顆星、232 個 fork。Convai Innovations 9 月 18 日開源,到 9 月 21 日就拿到這個成績。對比一下,Stable Diffusion XL 開源三個月後也不過這個量級的早期動能。社群是真的對「LLM 之外的決策模型」有需求。
第二個數字:32.8 毫秒。這是 Laya multilingual 在 T4 GPU 上單次推理的 p50。對比 Jev 公開的 236–276 毫秒、GPT-4 的 3000–5000 毫秒——快了 10 到 100 倍。這個延遲差距對即時應用(客服自動分流、prompt guardrails)來說不是「稍微舒服」,是「能不能做」的差別。
第三個數字:HG Likes 849、Downloads 0。Hugging Face 上的 laya 模型已經有 849 個讚,但 download 數顯示為 0——這是因為 README 引導使用者用 laya 套件自動下載,不是直接從 HF 拉權重。這是行銷設計的問題,不是產品力的問題。唯一要誠實講的,是 0.766 這個看似漂亮的數字其實是微調後的成績。原版的 base checkpoint 在 typed-decisions benchmark 上只有 0.362(剛好高於 0.318 的隨機基準線)。官方也很老實:「Treat Laya as a fast base to specialise, not as a zero-shot decision engine.」它不是丟下去就能用,是要針對你的工作流微調的——這個微調在 2 顆 T4 GPU 上約 4–5 小時。
為什麼現在是這種「非自回歸決策模型」的好時機
2026 年的 AI 業界有個矛盾:大家都說 LLM 是萬靈丹,但實際在 production 跑的工程師都知道,90% 的「智慧型任務」其實是決策任務,不是生成任務。把客服信件分到「帳務」或「技術」部門——這是分類(decision),不是生成。判斷一段 prompt 是不是 jailbreak——這是分類(decision),不是生成。判斷一個客戶是不是要流失——這是迴歸(decision),不是生成。當你把這些任務塞給 LLM,你就在為「會寫詩的能力」付錢,結果只用它的「讀信件的能力」。這在成本跟延遲上都不划算。
Laya 跟 Jev 想解決的是同一件事:回頭用強化學習跟 BERT 類的 encoder 做專門的決策模型,不靠自回歸生成。這個方向上其實有很長的研究血統(Sentence-BERT、MiniLM、DeBERTa、SetFit 都在做類似的事),但大家都沒包裝成一個「產品」過。
TypeSafe 的 Jev 把這個概念變成產品的故事,是用 PR 跟封閉 API 跑的。 Laya 把同樣的概念做出來,是用開源論文、open-weight、open dataset 跑的。現在這兩個東西並排在 HN 上,社群可以自己選。
實際安裝一行指令:
pip install laya然後照 README 範例:
import laya
from laya import Router

router = Router(preload=True)

state = {
    "from": "[email protected]",
    "subject": "Duplicate charge on invoice #4411",
    "body": "Hi, we were billed twice for March. Please refund the duplicate today or we will cancel our plan."
}

questions = {
    "department": {
        "type": "choice",
        "instructions": "Which department should handle this request?",
        "criteria": {
            "billing": "invoices, payments, refunds",
            "technical": "bugs, outages, system errors",
            "sales": "pricing, new contracts",
            "other": "everything else"
        }
    },
    "urgency": {
        "type": "score",
        "instructions": "How urgent is this request?",
        "criteria": ["not urgent", "soon", "critical deadline or blocking issue"]
    },
    "churn_risk": {
        "type": "noul",
        "instructions": "Does the user threaten to cancel or leave?"
    }
}

result = router.predict(state, questions)
print(result["answers"]["department"]["choice"])  # → billing (信心 0.94)
print(result["answers"]["urgency"]["score"])     # → 1.84 / 2.0
print(result["answers"]["churn_risk"]["noul"])    # → 0.892
print(result["routing"]["model"])                # → 自動選 english 或 multilingual
模型權重自動從 Hugging Face 下載,第一次執行時需網路,之後可離線。
這個故事的後續會怎樣?短時間(一個月內)值得追蹤的有幾件事:
- TypeSafe 會怎麼回應。Jev 已經是收費產品,$0.042/1M tokens。Laya 是免費的。這對 TypeSafe 的商業模式是直接衝擊。預期可能看到 Jev 降價、開源部分權重、或發技術論文(被罵了之後)。
- 社群會 fork 出什麼。GitHub 上 232 個 fork 中,已經有人做 Apple Silicon 移植(mizorewww/laya-mlx),也有人開始做特定產業的微調(醫療、法律、教育)。
- 類似的開源項目會跟進。Hacker News 上 @dwa3592 已經在做 OpenDecision;@kamranjon 提到 GLiNER(arxiv 2507.18546)是更早的同類工作,只是沒被包裝成「decision engine」。如果你正在做產品、客服、security、content moderation,這是值得花一個下午評估的開源項目。即使最後不用 Laya,至少你會重新想一下:哪些任務真的需要 LLM,哪些任務其實只要一個 33 毫秒、$0、Apache 2.0 的決策引擎。
資料來源
- Laya 官方網站 — laya.convaiinnovations.com
- GitHub 開源專案 — NandhaKishorM/laya(Apache 2.0、2540 stars、232 forks、Python)
- Hugging Face 模型 — convaiinnovations/laya、convaiinnovations/laya-multilingual、convaiinnovations/laya-typed-decisions
- 作者 Dev.to 長文 — I built non-autoregressive decision models a year ago, then a frontier lab called it a “breakthrough”
- arXiv 論文 — 2503.23303 SalesRLAgent、2510.01237 Confidence-Aware Routing
- Hacker News 討論 — I built non-autoregressive decision models with RL a year ago(1251 分、71 則頂層留言)
- AIWeekly 簡報 — Convai Ships Laya
網友熱門留言 (6)