編按:本文綜合整理自 IT 之家原文、arXiv 論文、羅福莉 X 推文、36 氪報導 與 智東西報導,並加入 Siami 編輯部觀點與分析。
小米 MiMo 大模型負責人羅福莉於 9 月 24 日發文,宣布 MiMo-V3 將採用全新架構。核心組件 HySparse 2 同步公開技術論文,瞄準長上下文智能體(Agent)推理的兩個最大瓶頸:KV 緩存大小與預填成本。
一、HySparse 2 做了什麼:兩級 KV 共享
HySparse 2 的核心是「兩級 KV 共享」(two-level KV sharing),從外到內分兩層處理長上下文:
- KV 橋接(KV Bridging):外層採用 YOCO 式自解碼器 + 交叉解碼器結構,但只橋接全注意力層。自解碼器用混合滑動窗口注意力(SWA),交叉解碼器用混合稀疏注意力;交叉解碼器中全注意力層的 KV 緩存,直接從自解碼器的隱藏狀態生成。
- KV 重用(KV Reuse):內層保留 HySparse 的 KV 重用設計,但做了兩項細化——把「塊級」稀疏換成「Token 級」稀疏(更精細的長上下文檢索),並把稀疏層原本獨立的 SWA 分支移除,改為強制把近期 Token 滑動窗口納入稀疏選擇。
這套設計的關鍵效果是:所有交叉解碼器的 KV 緩存都來自自解碼器,因此預填充可以在自解碼器結束時就停止,跳過所有交叉解碼器層。
二、關鍵數據:在 80B MoE 上實測
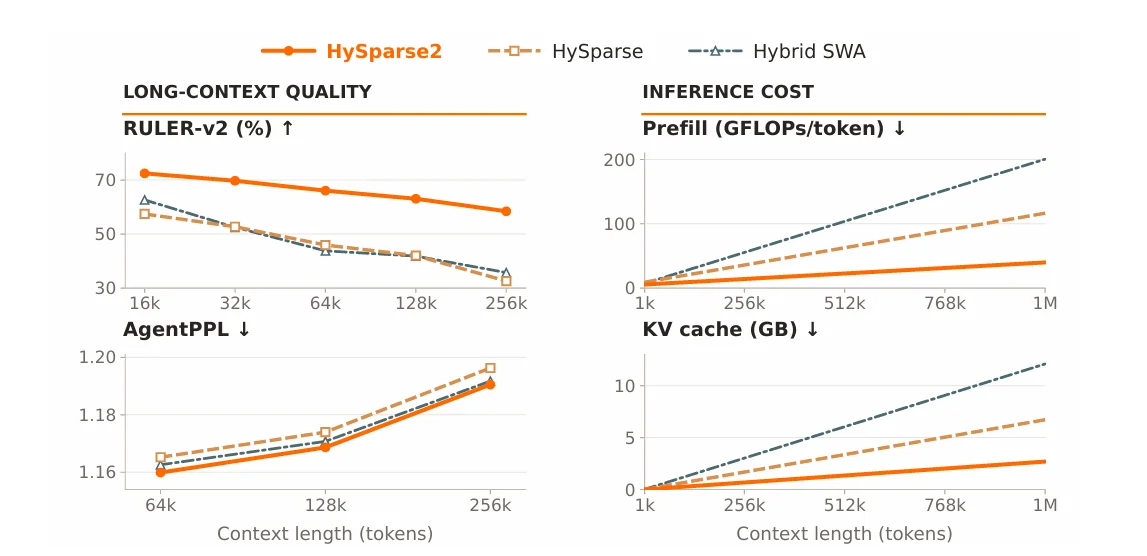
論文 HySparse2: Hybrid Sparse Attention with Two-Level KV Sharing(作者包括 Yizhao Gao、Shimao Chen、Bo Yang、Gang Wang、Fuli Luo 等)在 80B-A3B MoE 模型上測試,得到以下結果:
- 在 1M(100 萬)Token 長度下,預填計算量(FLOPs)降至原來的 1/5.02
- 在 1M Token 長度下,KV 緩存縮小至原來的 1/4.5
- MRCRv2 與 RULER-v2 長上下文檢索評分更高
- AgentPPL 與 LongPPL(困惑度,越低越好)更低
相較前一代 HySparse 與 Hybrid SWA 基準,HySparse 2 在長上下文檢索與多輪智能體任務上都明顯勝出,同時預填運算與 KV 緩存都大幅縮小。
三、為什麼這件事重要
HySparse 2 不是普通的「稀疏注意力改良」,而是瞄準了長上下文智能體推理的兩個具體瓶頸:
- KV 緩存隨上下文線性膨脹——過去做 1M Token 推理,光 KV 緩存就要吃掉數十 GB 顯存,這也是為什麼本地跑 1M 模型至今仍是難題。HySparse 2 把 KV 縮到 1/4.5,等同於把 80GB 的需求壓到 18GB 左右,讓 1M 上下文本地推理變得真正可行。
- 預填(prefill)成本是智能體工作流的隱形大坑——智能體每一輪互動,一個簡短動作可能會返回需要預填的長文本觀察結果。HySparse 2 把預填成本砍到 1/5.02,等同於把「每次工具呼叫的延遲」壓到原來的兩成。這對長時間運行的 Agent / Coding Agent特別關鍵。
對照 Siami 先前關注的幾個趨勢——KV cache quantization、prefix caching、KV blending——這些都是「在現有架構上補丁」,而 HySparse 2 是從架構層級重設計,意義完全不同。
四、技術細節補充
論文中還提到兩項細節改進:
- Token 級選擇取代塊級選擇:原本 HySparse 用塊(block)等級做稀疏,HySparse 2 改為 Token 等級,能對長上下文檢索做更精細的選擇。
- 近期 Token 強制窗口:原本稀疏層有獨立的 SWA 分支,HySparse 2 改為強制把近期 Token 滑進稀疏選擇裡,讓本地和全域 Token 共享同一個 KV 緩存,省下額外儲存。
作者群裡的 Fuli Luo(羅福莉)——前 DeepSeek 研究員、2025 年 11 月加入小米擔任 MiMo 大模型團隊負責人——是這次新架構的核心推手。
五、數據解讀與質疑
官方公布的「1/5.02」與「1/4.5」是在 80B-A3B MoE 模型上、1M Token 上下文長度的極端情境下測得,日常任務(128K 以下)不會有這麼戲劇化的差距。但這正好說明 HySparse 2 的真正戰場:長上下文 + 多輪 Agent——而這正是 2026 年 AI 競爭的主戰場。
另一個值得關注的點是「預填可提前退出」這個設計。當所有交叉解碼器 KV 都源自自解碼器後,預填階段就不必再跑後面的交叉解碼器——這對部署成本的影響遠超模型本身的 benchmark 分數。對雲端推論服務商來說,等同於同樣硬體可以服務 3-5 倍的請求。
唯一的小疑問:論文目前釋出的只有 HySparse 2 架構說明 + 80B-A3B MoE 的實驗結果,MiMo-V3 的完整模型權重、訓練資料、實際 benchmark 數字都還沒釋出。「架構好」不等於「模型好」,業界仍在等 MiMo-V3 正式發表。
六、影片與延伸閱讀
- 📄 HySparse2 論文(arXiv 2609.26368)
- 🐦 羅福莉官方 X 推文
- 📰 36 氪:羅福莉劇透小米 MiMo v3 架構
- 📰 智東西:小米羅福莉扔出 MiMo-V3 新架構
- 📰 Pandaily:Xiaomi Details HySparse2 for MiMo-V3
- 💬 Reddit r/LocalLLaMA 討論
- 📖 MiMo 官方文檔:V2.5 推理全鏈路優化
姊妹消息:小米於 9 月 23 日凌晨同步開源 MiMo-V2.6 系列(Pro + Flash),主打原生全模態,並聲稱是其探索 RSI(遞迴自我改進)路徑的關鍵一步。MiMo-V3 新架構若能延續這個開源節奏,將直接挑戰 DeepSeek、Qwen、Kimi 在開源大型語言模型領域的主導地位。
網友熱門留言 (2)