編按:本文綜合整理自 arXiv 原始論文、explainx.ai 深度分析、36Kr 報導,並加入 Siami 編輯部觀點與分析。
DeepSeek 把 agent 訓練用的沙盒系統 寫成 31 頁白皮書公開
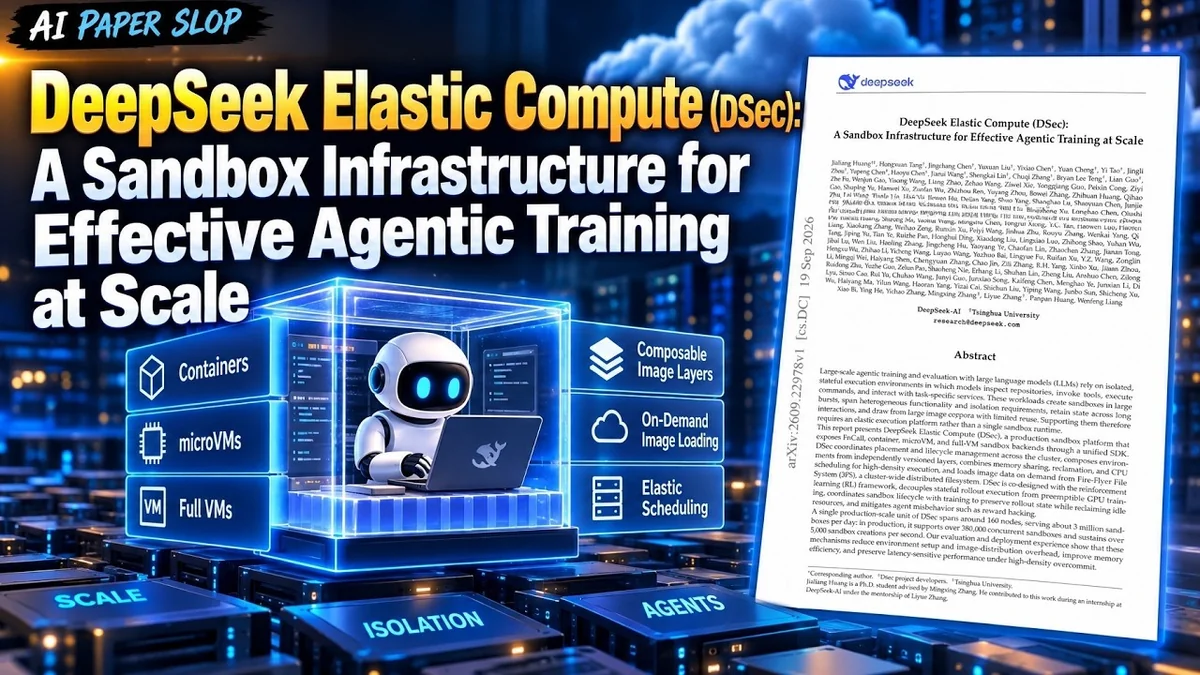
2026 年 9 月 19 日,DeepSeek 在 arXiv 丟出一份 31 頁的技術報告,掛 130 多位作者、創辦人梁文鋒親自掛名——主角不是新模型,而是 DSec(DeepSeek Elastic Compute),一套支撐 DeepSeek 訓練 AI 代理(agent)的沙盒平台。
一個生產級的 DSec 單位約 160 個 CPU 節點、3 萬核心、約 250 TB 記憶體,每天服務約 300 萬個 sandbox 實例,穩定撐住 38 萬個並行沙盒,建立速率超過 每秒 5,000 個。
對比目前公開的 agent 沙盒服務(E2B、Modal、Anthropic 內部棧),這些數字高出好幾個量級。DSec 不是單一沙盒實作——它是把 DeepSeek 自家檔案系統 3FS、GPU 排程器、RL 訓練迴圈全部重新整合在一起的系統。
四種隔離等級 單一 SDK 對外
DSec 的核心設計是一套 SDK 統一對外、底下掛四種沙盒後端:
| 等級 | 用途 | 取捨 |
|---|---|---|
| FnCall | 單次工具呼叫、輕量隔離 | 速度最快,隔離最弱 |
| Container | Docker-style 程序級隔離 | 大多數編碼任務適用 |
| MicroVM | Firecracker-style 輕量虛擬機 | 隔離更強,開機成本中等 |
| Full VM | 完整 VM | 最重最慢,但需要完整 OS/核心功能時唯一選擇 |
任務需要哪個就調哪個——把所有任務丟進 full VM 是浪費,把所有任務塞 container 又會忽略風險。
影片導讀
為什麼這件事重要
🚨 Siami 觀點:DSec 不是「另一個 Kubernetes」,它是把「agent 訓練」當成一等公民設計的系統。
過去 AI agent 訓練一直被基礎設施拖著走:模型在 GPU 上跑完一次 rollout,agent 要在沙盒裡實際執行 code、編輯檔案、跑測試——這段執行時間跟 GPU 計算時間是脫鉤的,傳統排程器不知道怎麼協調。
DSec 的解法是 「GPU-cluster-coupled sandbox scheduler」——沙盒系統跟 RL 訓練框架一起設計:
- GPU 訓練被搶佔時,rollout state 保留在 CPU 記憶體——下次恢復不用重跑
- agent 思考時,沙盒釋出 CPU 給別人用——報告指出 90% 的沙盒實際只用請求資源的 5% 以下
- 雲端暴衝(cloud bursting)兜底——單任務要 32,000 個沙盒時,溢出的丟到雲端 VM
這是第一次有 AI 實驗室把「GPU 集群」與「agent 沙盒」當成同一個問題寫論文公開。
對整個生態系而言,這套設計模式很快就會變成標竿。Hacker News 開發者 calebkaiser(做過 ML inference 排程器開源版)點出重點:
「Agent 沙盒需求很特別:任務是爆發性的,但又很長壽;需要低延遲的暫停/恢復;checkpointing 要考慮很多細節;天真做法通常很浪費,但過度最佳化又會犧牲持久性、隔離性與效能一致性。這是現在 agent swarm 的新熱門基礎建設議題。」
數據解讀
DSec 公布的數字要分兩層看:
看起來很猛的部分
- 300 萬 sandbox/day、38 萬並行、5,000 建立/秒
- 規模化時不打折(concurrency、throughput、creation rate 三項全達標)
- 跟自家 3FS 檔案系統深度整合——image layer 不下載整顆,用 3FS 按需載入 block(EROFS on-demand load)
需要打折的部分
Hacker News 上 redat00 留言直言:
「他們就是描述自己蓋出來的工作負載排程平台。再想一下,其實沒那麼神,也不值得炒作。AWS Lambda、任何跑 SLURM 集群的人基本上都是同樣架構。」
這個批評點出關鍵:「30 萬並行」這數字是因為 agent 工作負載特性(模型思考時 CPU 閒置、共用 image layer、共用 KSM 同頁合併)。如果把同樣設計拿去跑 GPU-bound 的 training workload,密度立刻掉下來。
換句話說:DSec 之所以能跑出這個規模,是因為它把 agent workload 的特性吃乾抹淨,而不是沙盒技術本身有突破性。
但這不影響它的重要性——這是第一次有 AI 實驗室把這個 workload profile 量化公開,未來其他實驗室要設計 agent 沙盒時,DSec 是基準線。
質疑與未驗證部分
報告沒有公開的:
| 項目 | 報告處理 | 待釐清 |
|---|---|---|
| Cache layout / prefetch 策略 | 未提 | image 載入的具體快取設計是黑盒子 |
| Layer 格式 | 未提 | 各 layer 之間的差異化儲存格式不明 |
| 三個密度機制(記憶體共用、CPU 排程、reclamation)各佔多少 | 未拆分 | 38 萬並行的「水分」來源不明 |
| Reward hacking 防禦機制的實際觸發率 | 未提 | 「agent 可能改寫 reward 訊號」如何量化阻擋 |
另外,報告的開放態度值得肯定——明確寫「沒有任何單一機制能防止所有 agent 錯誤行為」,主張用分層與可觀測性來補強,這比很多 AI 安全報告動不動就說「我們解了問題」更誠實。
後續觀察重點
- DeepSeek 是否會把 DSec 開源? 之前 3FS 已經開源,但 DSec 涉及商業 agent 訓練的核心排程,開源機率不高
- 其他中國 AI 實驗室(Kimi、Qwen、智譜)會不會跟進出類似報告? 對中國 AI 公司而言,這類「我們也很會搞 infra」的信號會變成常態
- 美國實驗室(OpenAI、Anthropic)的反應——他們內部一定也有類似系統,但沒有公開技術細節的習慣。DSec 等於把底牌掀了
- AI agent 訓練成本是否會被壓低? 如果 DSec 設計模式擴散,整個產業的 agent 訓練單位成本會顯著下降
網友熱門留言 (5)