編按:本文綜合整理自 Cerebras 官方技術部落格、Cerebras WSE-3T 晶片規格頁、Cerebras CS-4 官方頁、Cerebras Kimi K2.6 企業推論公告(5 月 19 日)、The Next Platform 報導(8 月 19 日)、arXiv:2503.11698 WSE-3 與 NVIDIA GPU 對比研究、Kimi K3 官方技術部落格、Hugging Face Kimi K3 模型卡、Cerebras 官方 X 貼文、Sarah Chieng 的 X 貼文 與 Hacker News 討論串(139 分、46 則回覆),並加入 Siami 編輯部觀點與分析。
2026 年 10 月 22 日,Cerebras 工程師 Sarah Chieng 在官方部落格放出一篇技術長文,標題是「How we deploy Trillion-parameter frontier models on Cerebras」。這不是行銷稿——它把一個被整個產業迴避的問題攤開來講清楚:一個兆級參數的模型,物理上到底要怎麼放進晶片裡?
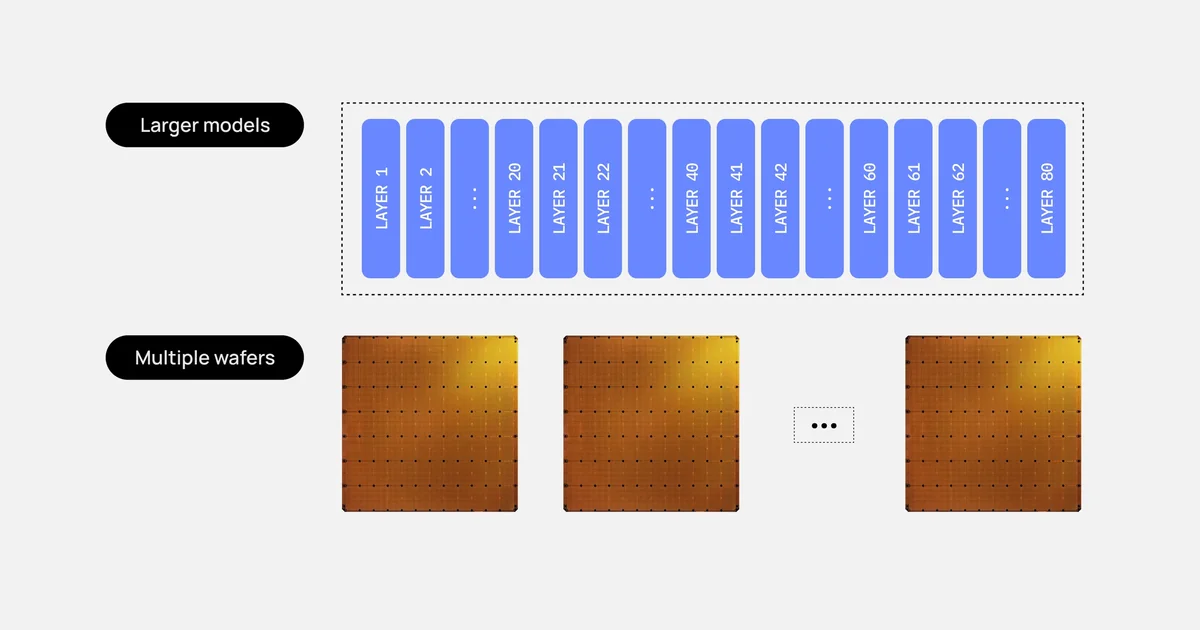
答案的骨架是:切成一片片 wafer,串成流水線,權重原地不動,只有啟發值在晶圓之間跑。官方用 Kimi K3 當範例,算出一個具體到可以照著複算的數字——59 片晶圓。
Hacker News 討論串累積 139 分、46 則回覆,官方 X 貼文 18.3 萬次瀏覽。這篇文章值得細讀,因為它是少數把「萬億參數推論」從行銷語言還原成算術的技術文件。
59 片晶圓是怎麼算出來的
先講硬體前提。Cerebras WSE-3T 是全球最大的 AI 晶片:46,225 mm² 的面積、4 兆顆電晶體、90 萬個 AI 核心、250 petaflops 算力,採用台積電 5 製程。官方數據是電晶體數是 NVIDIA B300 的 19 倍、運算能力是 56 倍。
關鍵在記憶體:每片晶圓有 44 GB 的 on-chip SRAM。
一整片 300mm 晶圓大小的晶片,只有 44 GB 記憶體。Hacker News 上網友 mlmonkey 的第一反應是「晶圓這麼大,記憶體才 44 GB?不是太少了一點嗎?」——網友 bubblethink 的解釋很精準:**那是 SRAM,相當於 44 GB 的 CPU 快取。**這正是它快的原因,也是它貴的原因。
接下來是模型側。Kimi K3 官方公布是 2.8 兆參數(Moonshot 自稱「全球第一個開放的 3T 級模型」),Cerebras 的部落格則以「約 3 兆參數」估算。架構取自 Hugging Face 模型卡:93 層(69 層線性注意力 + 24 層稠密全注意力)、隱藏維度 7168、96 個注意力頭、896 個專家每 token 啟用 16 個、最大上下文 1,048,576 token。
官方給的部署前提是:4-bit 權重量化、8-bit KV cache、假設平均請求大小 256k token。
於是計算可以逐步走:
- 總權重負載:3 兆參數 × 4 bit ÷ 8 = 1.5 TB
- 每層大小:1.5 TB ÷ 93 層 = 約 16.13 GB
- 線性注意力層:不需要 KV cache(每個請求只保留固定大小狀態),一片 44 GB 可以放 2 層(32 GB),69 層 → 35 片
- 稠密全注意力層:需要為每個 token、每個並行請求存 key 與 value,一層佔 16 GB、剩下的 SRAM 要留給 KV cache,所以 一片只能放 1 層,24 層 → 24 片
- 合計:35 + 24 = 59 片,總 on-chip SRAM 容量 2.54 TB
這個數字對參數量估算相當穩健:用官方 2.8 兆參數重算,每層變成 15.05 GB,線性層仍是每片 2 層,總片數一樣是 59 片。
管線平行:權重不動,啟發值流動
Cerebras 的執行模型跟 GPU 叢集完全不同。GPU 是「一層一層往下算」;晶圓級晶片是空間排布的流水線。
Cerebras 編譯器先把模型層映射到不同晶圓的區域,runtime 再把 token 流動的路徑畫出來。關鍵設計是:
只有啟發值(activations)需要在晶圓之間傳遞,模型權重幾乎永遠不需要移動。
因為每片有 44 GB SRAM、每層只佔 16 GB,整層可以直接放進晶片裡,不必跨晶圓切層。跨晶圓的傳輸走乙太網上的 RDMA,每一跳約 2 微秒。
具體來說,第 1 片跑第 1–2 層並把啟發值送給第 2 片,第 2 片跑第 3–4 層再往下傳,接到最後一片產出下一個 token。
HN 上最容易引發誤解的一個問題是:「一個 token 要依序經過每片晶圓,那每片豈不是多數時間都在等?系統實際上等於 batch size 1?」官方與網友的回答是:整條流水線永遠塞滿不同請求。**第 3 階段在處理請求 A 的 token 時,第 2 階段同時處理請求 B,第 1 階段處理請求 C。**因為模型本來就被切成流水線階段,每個階段可以同時處理不同請求;生產環境的階段切分比「一層一階段」細得多,連 micro-batch 都算進去。
網友 bubblethink 把這件事講得最清楚:這是管線平行(pipeline parallelism),而不是 GPU 常用的張量平行或專家平行。GPU 一次算一層,管線平行在 GPU 上做推論沒有意義——但對晶圓級架構來說,這是唯一可行的排法。網友 mmoskal 補上原因:晶圓邊緣的 IO 接點面積有限,資料平行需要太多頻寬,所以只能走管線平行;GPU 只有在單一高速網域塞不下模型時才會這麼做,而那已經是 NVIDIA 72 張 GPU 的規模了。
併發 189 個請求、每 token 4.1 焦耳
官方技術文檔裡最實用的一段,是「能同時服務多少請求」的推算。限制因素是 KV cache——每個飛行中的請求,在每一片稠密層晶圓上都要占一份 KV cache,所以片上的 SRAM 直接決定併發上限。
用 Kimi K3 的實際架構重算(MLA 潛向量結構:kv_lora_rank 512 + qk_rope_head_dim 64 = 每 token 每層 576 bytes,8-bit):
- 一片稠密層晶圓扣除權重後剩餘:44 − 16.13 = 27.87 GB
- 一個 256k token 請求在每片稠密層上的 KV:256,000 × 576 bytes = 約 147 MB
- 併發上限:27.87 GB ÷ 147 MB ≈ 189 個並行請求
HN 網友 eulgro 在沒有官方併發數字的情況下自行估算,用的是同一組數據,得到的結果是 190——兩個獨立計算對得上。
功耗面同樣可以外部交叉驗證。以每片 WSE-3T 約 20 kW 計算,59 片合計約 1.18 MW;若滿載 189 併發、每請求 1500 tok/s,聚合吞吐約 283,500 tok/s,對應 每 token 約 4.1 J。eulgro 算出的數字是 4.1 J/token,與上述一致。
把 1.18 MW 放進尺度感:相當於 約 9.8 個 120 kW 的 GPU 機櫃。網友 shrubble 的提醒更直白——「功耗差不多是 10 個 GPU 機櫃,就當作參考。」
在效能對照上,Cerebras 官方引用 Artificial Analysis 的實測:跑 Kimi K2.6 時達到 981 output tokens/s,比次快的 GPU 雲快 6.7 倍、比中位數推論供應商快 23 倍;一個 10,000 token 的輸入請求(含提示處理、推理、生成 500 token),Cerebras 5.6 秒回完,官方 Kimi 端點要 163.7 秒,端到端時間改善 29 倍。
為什麼這件事重要
為什麼這件事重要
第一,它把「萬億參數推論」從行銷語言還原成算術。過去兩年關於晶圓級晶片的爭論幾乎都停留在宣稱數字——多少倍 GPU、每秒多少 token。這篇長文第一次把中間步驟攤開:每層 16 GB、一片放 2 層或 1 層、35 + 24 = 59、每跳 2 微秒、KV cache 147 MB、併發 189。任何人都能照著複算,任何人也都能在任一步驟提出質疑。這種「可被推翻的技術宣稱」本身就比宣稱本身更有價值。
第二,它揭露了一個被忽略的架構紅利:線性注意力層是關鍵。Kimi K3 有 69 層線性注意力、24 層稠密全注意力。線性注意力不需要隨上下文長度膨脹的 KV cache,這讓 93 層裡有 74% 可以兩層塞一片;真正被 KV cache 綁住的是剩下 24%。換言之,Moonshot 的模型架構選擇與 Cerebras 的硬體形態意外地互相咬合——稠密層比例越低,能塞進去的參數量就越多。這是硬體商與模型商之間策略耦合的罕見案例。
第三,它讓「每 token 多少焦耳」成為可比較的指標。官方在文中明確點出:評估推論系統,concurrency 或 batch size 都不是好指標,真正有意義的是在相同輸出生成速度下的「每秒 token ÷ 每兆瓦」。這是把硬體競賽從「峰值算力」拉回「單位電力的有效產出」的思維轉換,而且它直接對應企業客戶真正在意的 TCO。
第四,它把 Cerebras 的商業位置說清楚了。The Next Platform 指出,CS-4 系統搭載的不是外界預期的 WSE-4,而是超頻版的 WSE-3——同樣的 90 萬核心、同樣的 44 GB on-wafer SRAM、同樣的台積電 5 製程。官方對 CS-4 的說法是「比 GPU 快最多 30 倍、每瓦吞吐比 CS-3 提升最多 10 倍、可在超過 50 兆參數的模型上維持超過 1000 tokens/s」。這意味著在可預見的未來,「兆級參數模型 + 即時互動」這個組合,只有晶圓級架構做得到,而 Cerebras 目前是唯一把這件事寫成公開規格書的廠商。
數據解讀與質疑
數據解讀與質疑
一、benchmark 用的是全精度,部署用的是 4 bit——這中間有一段沒人交代。 部落格引用 Kimi K3 的 Terminal-Bench 2.1 分數 88.3%(GPT-5.6 Sol 為 88.8%)、BrowseComp 91.2%(GPT-5.6 Sol 為 90.4%),但這些是模型的原始全精度成績;部署章節卻明明白白寫 4-bit 權重量化。HN 網友 tgtweak 一針見血:「引用全精度 benchmark,結果卻直接改用 4 bit 量化。」量化後的精度損失、以及 Kimi K3 官方那份 88.3% 到底是在什麼精度下測的,官方沒有在這篇文裡說明。
二、59 片晶圓的故障域是一個真問題,不是杞人憂天。 網友 zhyblife99 的提問至今沒有官方回答:GPU 部署可以損失一個節點然後降級運作,但這裡「模型本身就是機櫃」,一片壞掉的晶圓就是整個模型下線;而且必須全程保持活著的流水線,沒辦法做滾動升級——你無從「排空」它。59 片的規模意味著故障率不是線性而是相乘。Hacker News 上還有網友 (@Future_Ripples) 順帶問了一句更尖銳的:「Cerebras 到底有沒有投資人關係部門?這在 IPO 時就是個議題……股價掉了 280 美元之後才開始談這個?」The Next Platform 也記錄了這條時間線:10.1 億美元的募資輪是在 2025 年 10 月、且在公司於 2026 年上市之前完成的。
三、「1000–2000+ tokens/s」到底是一個請求還是整台機器?這是全篇最大的模糊地帶。 部落格寫「run multi-trillion parameter models at 1000-2000+ tokens per second」,但沒有說明這是單一請求的輸出速度還是整系統的聚合吞吐。對照官方另一篇文章引用的 Artificial Analysis 數據——Kimi K2.6 的「981 output tokens/s」——那個指標在業界慣例裡指的是單請求輸出速度。如果 59 片真的能在 189 併發下各自維持 1500 tok/s,聚合吞吐會是 28 萬 tok/s 以上;但官方從未如此宣稱,也沒有第三方位元能量測 59 片規模的 3T 模型。兩者差了三個數量級,不能混著讀。
四、上下文長度會讓併發數字崩塌,而 1M 上下文正是 Kimi K3 的主打功能。 用同樣的 MLA 結構重算:32k 上下文約 1570 併發、128k 約 392、256k 約 189、524k 約 95、1M 上下文只剩約 47。也就是說,官方用 256k 假設算出的 189 併發,套用到 Kimi K3 真正能跑的 1M 上下文時要打個對折再對折。官方並未聲稱 59 片能撐 1M 上下文的滿載併發,但這個數字落差在宣傳時容易被略過。
五、使用者端的實際體感跟「萬億參數」沒有直接關係。 網友 keyle 的經驗是:Cerebras 紙面上很好,但實際能取得的模型只有 GPT-OSS 120B 與 Qwen 3.8 27B,「速度快得飛起,但答案大多不太對」;網友 2001zhaozhao 補充,Qwen 3.8 現在在成本與效能上都被 Mercury 3 壓著打,除了拿到企業客製合約之外沒什麼理由用。網友 cfn 也說,他本週試了 Cerebras,27B 模型跑 2000 tok/s 對他的專案是完美的,但「它就是跑不到我需要的 2k tokens/s」。
六、速率本身的邊際效用正在快速遞減。 網友 lifeisloving 的說法:「比較像是用光速在你自己的程式碼裡放火。沒有人需要這個,而且他們部署的模型、或所有 LLM,產出都需要大量人工審查。」另一位補充:「我最多花 10 分鐘就能判斷 LLM 花一小時生出來的解案不夠好、必須整個丟掉。」但同一串裡也有人反駁:「在這種 token 速率下,你完全可以把 LLM 當成編譯器,每週從頭重建整個軟體——那會是 AI 爛CODE的終結。」兩種判斷都成立,取決於工作性質。
接下來該看什麼
Cerebras 在文末沒有給出承諾式的 roadmap,只有一句邀約:對部署模型或使用其推論雲有興趣的人,可以從免費 API 開始。真正值得追蹤的觀察點有三個:
- 59 片規模的第三方量測。 目前所有數字都來自 Cerebras 自己的部落格與 Artificial Analysis 對 Kimi K2.6 的測試。3T 級模型在 59 片上的實際輸出速度、精度損失與每瓦吞吐,目前沒有獨立第三方驗證。HN 討論裡有網友提到某個第三方工具網站已經在解析這篇文章(explainx.ai),但那類站點本身也需要獨立驗證。
- 4-bit 量化後的實際成績。 Kimi K3 官方那份 Terminal-Bench 88.3% 與 BrowseComp 91.2% 在 4-bit 下還剩下多少,是「萬億參數即時推論」這整個敘事的關鍵變數。
- 故障域與維運模式。 一個 59 片、1.18 MW、模型即機櫃的系統,其冗餘設計、壞片替換流程與升級策略,目前沒有公開資料。CS-4 的 Nexus 平台把運算、電源與 I/O 拆成三個模組化元素、或許是答案的一部分。
從競賽角度看,NVIDIA 這邊的 Rubin 世代、AMD 的 MI 系列、Google 與 Amazon 自研晶片都還在跑,而 Cerebras 在 2026 年 8 月才把 CS-4 推向市場、10 月才第一次把部署方法學攤開。這場競賽真正的分水嶺,不是誰的晶片更大,而是誰能把「萬億參數 + 互動延遲 + 每瓦成本」三個條件同時滿足——而這一次,Cerebras 終於讓外界有足夠的資料自己算,而不是只能相信。
相關延伸閱讀:Cerebras 官方技術部落格原文|WSE-3T 晶片規格頁|CS-4 官方頁|Cerebras Kimi K2.6 企業推論公告|The Next Platform:CS-4 為何是超頻 WSE-3 而非 WSE-4|arXiv:2503.11698:Cerebras WSE-3 與 NVIDIA GPU 系統對比|Kimi K3 官方技術部落格|Hugging Face Kimi K3 模型卡|Cerebras 官方 X 貼文|Hacker News 討論串(139 分、46 則回覆)
網友熱門留言 (6)