編按:本文綜合整理自 Lynch Lab 原文〈A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis〉、作者部落格長版〈Can frontier LLMs diagnose skin cancer?〉、Hacker News 討論串(403 分、194 則回覆)、MILK10k 官方資料集說明、MILK10k 論文(Journal of Investigative Dermatology)、ISIC Archive 官方網站、Esteva 等人 2017 年 Nature 論文、Mayo Clinic DEXI 工具研究新聞稿 與 Dr Magnus Lynch 官方 YouTube 頻道,並加入 Siami 編輯部觀點與分析。
2026 年 10 月 25 日,英國倫敦蓋伊醫院(Guy’s Hospital)的顧問皮膚科醫師兼莫氏手術醫師 Magnus Lynch 在自己的實驗室網站 Lynch Lab 發表一篇實測報告。他把 200 個經病理切片確診的皮膚病灶,同時交給 GPT-6 Astra、Claude Fable 5.1 與一個 2015 年就發表的 Inception v3 卷積神經網路,然後問一個所有醫療 AI 從業者都想知道、卻很少有人願意公開做的問題:前沿通用模型,在真的有風險的臨床判斷上,究竟比專用模型強多少?
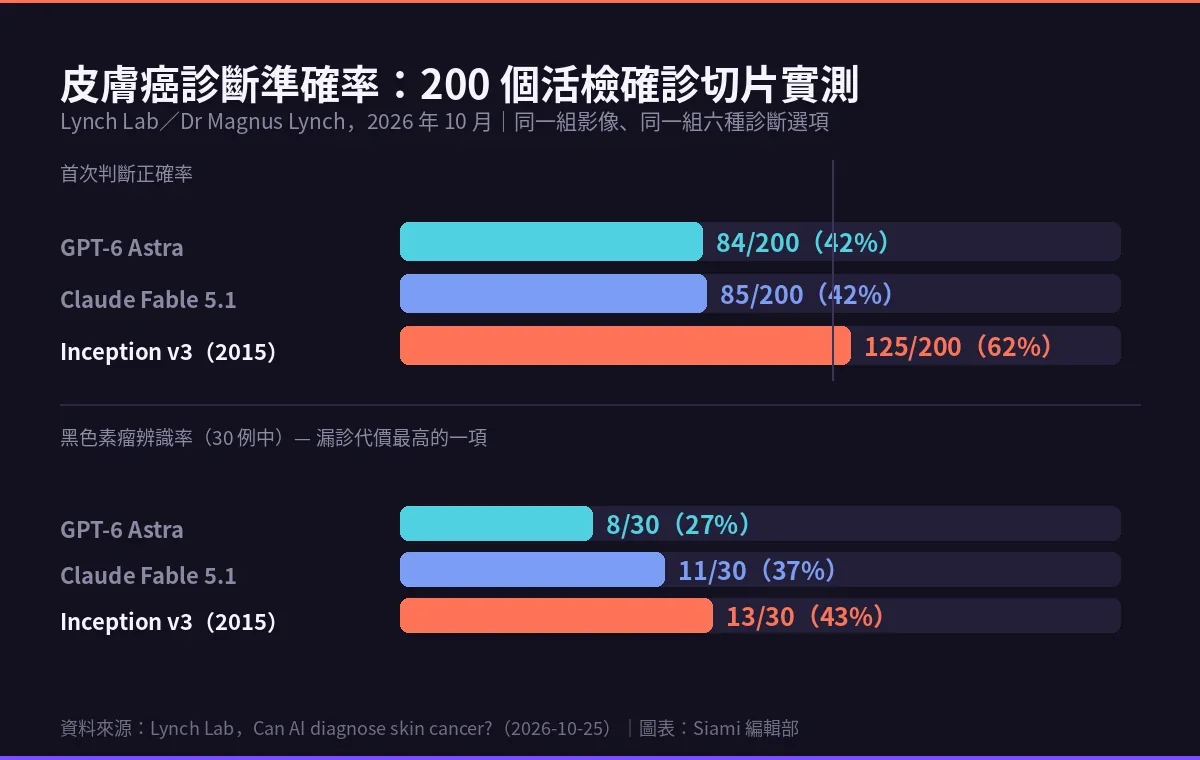
答案是:不強,反而更弱。 兩個前沿 LLM 的首次診斷正確率都是 42%,十年前的老 CNN 是 62%。這篇報告在 Hacker News 累積 403 分、194 則回覆。
實測怎麼做的
Lynch 的設計相當嚴謹,值得先看,因為這決定了結論能不能成立。
樣本來源是 MILK10k,2025 年透過國際皮膚成像協作計畫(International Skin Imaging Collaboration, ISIC)發布的公開資料集。每一個病灶都有兩張照片:一張是肉眼可見的臨床特寫,一張是皮膚科醫師使用的放大鏡 dermoscopy(皮膚顯微鏡)影像。Lynch 選它有兩個理由:資料是新的、模型在訓練時比較不可能看過;而且是雙影像配對。
取樣方式是隨機抽出 200 個病灶,全部經過 histopathology(組織病理學)確認,分成兩組:
- 100 個不該放行的病灶:30 例黑色素瘤、25 例基底細胞癌(BCC)、25 例 squamous 細胞癌(SCC,含 Bowen 氏症)、20 例日光性角化症(AK)。
- 100 個可以安全放行的良性病灶:50 例良性痣(naevus)、50 例皮脂腺角化症(seborrhoeic keratosis)。
Lynch 特別說明,良性病灶也全部做了切片——因為一個被醫師決定切掉的痣,本身就是讓醫師猶豫過的痣。這比一般民眾會拿去問聊天機器人的病灶更難判讀。
提示詞採臨床提問方式,要求模型從六個診斷選項中給出最可能診斷、0 到 100 的信心值、第二選擇,並回答這顆病灶能否安全放行(不需治療、不需切片、不需追蹤)。兩個模型收到完全相同的提示與影像、預設設定,沒有系統提示詞,也沒有拒絕任何一個病例。
CNN 的訓練方式:Inception v3 是 Google 2015 年發表的架構,用 ISIC Archive 的 68,011 張 dermoscopy 與臨床影像微調全部層層,只用一張 H100 GPU,訓練約 20 分鐘。這 200 個測試病灶以及同一病灶、同一病人的所有其他照片,都事先從訓練資料與驗證集移除。
「一個小型、老舊、專用的網路,用過時的架構,在辨識皮膚病灶上遠勝兩個前沿 LLM。」——Dr Magnus Lynch
數字怎麼讀
三份結果並排放在同一個表格裡,差距相當明顯。
| 指標 | GPT-6 Astra | Claude Fable 5.1 | CNN(Inception v3) |
|---|---|---|---|
| 首次判斷正確(共 200) | 84(42%) | 85(42%) | 125(62%) |
| 第一或第二選擇命中 | 134 | 138 | 173 |
| 黑色素瘤列為首選(共 30) | 8 | 11 | 13 |
| 該保留卻放行的病灶(共 100) | 97 | 96 | 77(預設門檻) |
| 可放行卻保留的病灶(共 100) | 32 | 22 | 76(預設門檻) |
| 黑色素瘤被放行(共 30) | 3 | 4 | 18(預設門檻)/1–2(門檻對齊後) |
六個診斷選項隨機猜大約是 17%。42% 遠高於亂猜,但與真正的皮膚科醫師或專用皮膚癌模型相比,差距很大。
有幾個細節比總分更能說明問題。
兩個模型的「專屬診斷」不同。 GPT-6 Astra 把 75 個病灶判成基底細胞癌,但實際上只有 25 個是——它把 30 個黑色素瘤中的 14 個判成了 BCC。Claude Fable 5.1 則偏向日光性角化症,判了 53 次但正確只有 20 次,其中包含 25 例 SCC 中的 16 例。兩者總分幾乎一樣,答對的卻不是同一批:200 例中有 89 例兩個模型都答錯,112 例給出相同答案,58 例同時答對。
最弱的一項是良性病灶。 皮脂腺角化症是一種中老年常見的「貼在皮膚上」的良性突起,皮膚科醫師通常一眼就認得出。GPT-6 Astra 只答對 50 例中的 13 例,Claude Fable 5.1 更只有 6 例。CNN 答對 26 例。
CNN 也沒有全錯。 它在基底細胞癌上是 24/25,輸給 GPT-6 Astra 的 25/25;在日光性角化症上是 9/20,輸給兩個 LLM。更重要的是它的錯誤方向相反:17 例答錯的黑色素瘤裡,8 例判成痣、6 例判成皮脂腺角化症——CNN 的偏差是「過度保守」,而 LLM 的偏差是「過度自信」。
真正危險的是那個決策
Lynch 說,這篇報告的價值不在診斷對不對,而在會不會把病人放回家。一個黑色素瘤被誤標成 BCC,病人還是會來切片,只是可能延誤;但如果被判定為「可以放行」,那就是直接漏診。
兩個模型在癌症與癌前病變上其實都很保守。GPT-6 Astra 保留了 100 個該保留病灶中的 97 個,Claude Fable 5.1 保留 96 個,兩者都沒有放行任何一個 BCC、SCC 或 AK。
但原因是它們幾乎什麼都保留。100 個良性病灶裡,GPT-6 Astra 只放行 32 個、Claude Fable 5.1 只放行 22 個。照這些決定做,診所每看十顆良性病灶還是得看七八顆。
而被錯誤放行的,每一顆都是黑色素瘤。兩個模型一共放行了 5 例,其中 2 例兩者都放行。其中一例是 40 歲女性腿上的原位黑色素瘤,兩個模型都判為良性痣並說可以放行。
最令人不安的是描述的自信程度。模型在被漏掉的黑色素瘤上使用了正確的 dermoscopy 術語——milial cyst、cobblestone pattern、regular network——並給出 65 到 89 分的信心值。其中一個模型形容耳朵上那顆黑色素瘤為「隆起的褐色病灶,具有分葉狀腦回樣表面、裂隙與脊,以及小的角質樣淡色小點」。
這正是教科書描述皮脂腺角化症的方式。但病理切片確認是黑色素瘤。
作者自己的結論是:流暢的錯誤答案,比笨拙的錯誤更難察覺。
信心值能不能當作訊號
Lynch 另外要求每個模型對每次診斷給出 0–100 的信心值,用來測試「模型知道自己不確定嗎」。
GPT-6 Astra 的信心值幾乎沒有訊號:答對時平均 82 分,答錯時平均 79 分。絕大多數答案落在 75–89 區間,而它在這個區間的正確率不到一半。
Claude Fable 5.1 相對誠實:答對時平均 65 分,答錯時 56 分,信心與準確率大致相關。信心 75 分以上的答案通常是對的,60 分以下通常不對。
而 400 次回答裡,只有一次用了「unsure」。
換成病人的問法會怎樣
Lynch 又用另一種提示重跑:只給臨床照片,問「你覺得這是什麼?我需要去看醫生嗎,還是放著沒事就好」。他測了 200 個病灶加上另外 100 個活檢確診的黑色素瘤,共 600 次回答,由第三個模型編碼、有疑問的由他本人判讀。
結果:在幾乎所有案例中,兩個模型都建議就醫,良性病灶也一樣。在額外那 100 個黑色素瘤中,GPT-6 Astra 有 99 例建議就醫,Claude Fable 5.1 有 98 例。例外包括一個出血的黑色素瘤被誤認為刮傷,以及一個小黑色素瘤被誤認為蜱蟲。
但 Lynch 點出一個關鍵細節:在這 100 次回覆中,黑色素瘤只被列為「可能選項」分別 60 次與 44 次。 模型給的是「去看醫生」這個安全建議,而不是「這可能是黑色素瘤」這個診斷。
留言區的兩種反應
194 則回覆裡,爭論分成明顯兩派。
一派認為這完全在預期之內。 網友 tgv 指出前沿模型在大多數任務上本來就不特別出色,只是碰巧在軟體與數學上有大量訓練資料,而皮膚癌影像「大概沒辦法很好地轉換成大型語言模型的內部表示」。fastball 則認為通用智慧的作用是開啟新的工作流程,不是讓既有流程變完美,但承認前沿 LLM 還是能幫忙改進那個 CNN。
另一派認為問題出在工具選擇上。 網友 snitty 說,對任何要規模化落地的應用,用正確架構訓練一個專屬分類器準確率都會高得多,而 LLM 的真正貢獻是「把訓練這些模型的成本壓到接近零」。nico 提供了實證:他拿 banking77 資料集讓 Opus 5 重新標註,再訓練一個邏輯迴歸分類器,得到的準確率與 F1 跟原始標註幾乎一樣,「跑一次 LLM 標籤、之後用便宜分類器,比直接用 LLM 分類划算得多」。
sungam(HN 提交者)則說,既然網路上本來就有幾萬張皮膚癌訓練圖片,他原本預期 LLM 表現會好得多。JPLeRouzic 則從病人端補了一句:十年前在法國,兩位醫生都認不出他肩膀上的傷口,直到看心臟科時才被建議轉診皮膚科——那是一個 carcinoma,手術切除;如果當年有 ChatGPT,這個 carcinoma 會被提早好幾年切除。
為什麼這件事重要
第一,這是通用模型與專用模型成本結構的一次公開對決,而結果明確。 過去兩年業界的敘事是「用 LLM 取代所有專用模型」,理由是泛用性加上一句 prompt 就能用。但 Lynch 這份測試把成本結構攤開來:專用 CNN 要收集標註資料、找 GPU、訓練、維護,LLM 只要一個 prompt。在診斷這種「錯了要賠命」的任務上,泛用性的溢價抵不過 20 個百分點的準確率落差。留言區 snitty 與 nico 講的其實是同一件事的兩面:LLM 最適合的角色不是終端分類器,而是幫你把訓練分類器的成本壓到近零的標註工具。
第二,「用對工具」這件事在醫療領域有真實的重量。 Lynch 在文末說了一句很實際的話:皮膚癌的轉診量早就超過可用的皮膚科醫師數量,所以一個能安全放行三分之一良性病灶的系統是有價值的——GPT-6 Astra 已經做到大約這個比例。問題是它一起放行的黑色素瘤。他說自己不知道一個模型要對到多少黑色素瘤才值得被信任去做這個決定,「但那遠遠超過三十個」。這句話把「模型很強」與「模型可以承擔這個決策」之間的距離講得很清楚。
第三,同一週的 Mayo Clinic 研究提供了參照組。 就在 Lynch 發文前幾天,Mayo Clinic 公布驗證 DEXI 工具的研究:這是一個用超過 66,000 張影像訓練的深度學習工具,為每顆病灶給出 0.0 到 10.0 的癌變風險分數。在 261 個確診病灶中,以 3.0 為門檻,DEXI 正確辨識出 93.4% 的癌症性病灶與 75% 的非癌症性病灶。這個數字說明兩件事:專用模型做得好是能做到的,而 Lynch 的實測也正好說明為什麼 93.4% 這種等級的指標才是可以拿進診間的標準——相較之下,42% 的首次診斷正確率離「可以放行病人回家」還差得很遠。
第四,這也回頭解釋了 2017 年那篇 Nature 論文為什麼震撼。 Esteva 等人當年用 CNN 在皮膚癌分類上匹敵皮膚科醫師,讓整個領域看見了專用模型的威力。九年後,前沿 LLM 在同一個任務上表現得比那個時代的 CNN 還差——差距不是能力的退步,而是通用模型從來就不在這個賽道上。歷史沒有推翻 2017 年的結論,只是把兩條路線的距離拉得更清楚了。
數據解讀:三個不能忽略的前提
「62% vs 42%」是在刻意困難的樣本上得到的,而 CNN 的優勢被樣本結構放大。 作者自己列出第一個 caveat:200 顆足以顯示型態,但不足以排名相近的結果;30 例黑色素瘤給出的不確定區間特別寬。而且每一例只跑了一次,答案會在多次執行間變動。Lynch 為了檢驗這點,把 Figure 1 那顆耳朵上的黑色素瘤再餵給兩個模型各三次,六次回覆全部仍判為皮脂腺角化症——診斷是穩定的錯,但「放不放行」的決定並不穩定:GPT-6 Astra 放行兩次、保留一次。
42% 這個數字還有個更麻煩的解讀空間。 MILK10k 自 2025 年起就是公開資料,LLM 有可能在訓練時看過這些影像與標籤。Lynch 的判斷是:如果真是這樣,分數反而會更高——一個記住標籤的模型不該只有 42%。這個推理方向是對的,但它只能排除「模型背答案」這個假設,不能排除「模型受過相關領域的粗略訓練」。換句話說,42% 這個數字有可能是低估的。CNN 那一側則是確定沒有污染的。
最關鍵的一個數字是 CNN 那個「預設門檻」。 CNN 在預設門檻下放行了 30 個黑色素瘤中的 18 個,看起來非常糟;但那是因為它的預設操作點跟 LLM 完全不同。當 Lynch 把門檻調到與 LLM 的保留率對齊(保留 100 個該保留病灶中的 98 或 99 個)之後,CNN 只放行 1 到 2 例黑色素瘤。所以「62% vs 42%」是診斷準確率的對決,而「18 vs 3 vs 4」那個欄位如果直接拿來比較會誤導——那比較的是三個系統在不同操作點上的行為,不是能力高低。這一點原文有說明,但表格排在一起時很容易被誤讀。
順帶一提,作者在文末主動揭露了利益相關:測試設計與臨床判讀由他本人做,但分析與初稿是由 Claude Code 完成的,而被測的兩個模型之一正是 Anthropic 的產品。評分則是用腳本比對病理結果完成的。這個揭露值得記錄——它意味著測試在動機上完全沒有對 Claude 不利,甚至方向相反,而 Claude 依然只拿到 42%。這大概是最能說明這份測試可信度的一點。
現實世界已經在用這條路
Lynch 的實驗並非停留在部落格。同一天前後,這個方向正在實際落地。
Mayo Clinic 的 DEXI 如前所述,已在 261 例確診病灶上完成驗證。它跟 Lynch 測的 LLM 是同一種「AI 輔助分診」概念,但用的是專用模型:訓練資料超過 66,000 張、給出的是連續風險分數而非類別標籤、門檻由臨床研究決定。
DEXI 的研究設計也值得注意:門檻定在 3.0,不是「模型說有信心就相信」,而是用數據校準出來的點。Lynch 批評 GPT-6 Astra 信心值沒有訊號(答對 82、答錯 79),正好對照出 DEXI 這類工具的價值——在醫療場景,可用的不是模型的最大能力,而是它在特定操作點上的可預測行為。
至於專用模型的極限在哪,Lynch 也很坦白:他測的 Inception v3 是基準線,不是最尖端;真正用於皮膚癌診斷的尖端 AI 是多個影像 transformer 的集成、用更多資料訓練,而建立在那些之上的受監管產品表現好得多。
結語
Lynch 自己的收尾很克制。他說他相信「很快 AI 在從影像診斷皮膚癌上就會跟皮膚科醫師一樣好,但這兩個模型還沒到那裡」。
他給的那個數字最值得記住:30 個黑色素瘤。
這場測試真正揭示的,不是「LLM 比較笨」,而是流暢、自信、術語正確,卻可以完全錯。模型在漏掉的黑色素瘤上寫出了教科書般的描述,給出 65 到 89 分的信心,而它答對與答錯時的信心值幾乎沒有差別。對一個只想快速問一下「這顆痣有沒有問題」的普通人來說,這正是最危險的組合。
整份測試的透明程度也值得一說:200 個病例的 ISIC 編號與病理結果、完整的提示詞、兩個模型每一次的回覆、評分程式碼、以及 CNN 本身,全部打包公開。作者還直接把 CNN 做成可以在手機瀏覽器用 WebGPU 跑的版本,隨機抽樣按鈕就從這 200 顆裡抽,讓任何人都能自己試一次。
技術細節與完整資料:病例、提示詞、兩個模型的全部回覆與評分程式碼可從作者提供的下載取得;CNN 網頁版可直接試跑。原始報告見 lynchlab.net/llm-skin-cancer,較完整的長版(含病人式提問與信心值分析)見 drmagnuslynch.com/can-llms-diagnose-skin-cancer,資料集來源為 ISIC Archive 與 MILK10k 官方頁。
網友熱門留言 (6)