編按:本文綜合整理自 Max Woolf 部落格原文〈OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?〉、OpenAI 官方 API 定價頁、Anthropic 官方 Claude Opus 5.5 發布頁、Anthropic 官方 Claude Fable 5.1 發布頁、OpenAI 官方 GPT-6.1 Sol 發布頁、OpenAI 官方 GPT-6 Sol 與 Luna 發布頁、Vercel 官方 AI Gateway Production Index(2026 年 10 月)、Reuters:Anthropic IPO 招股書揭露 420 億美元淨損、Fortune:What slowdown? OpenAI, Anthropic release dueling models as AI price wars heat up、Artificial Analysis:Kimi K3.1 Pro 發布評測 與 Hacker News 討論串(381 分、385 則回覆),並加入 Siami 編輯部觀點與分析。
2026 年 10 月 25 日,前 BuzzFeed 資深資料科學家 Max Woolf 在個人部落格丟出一份整理到位的追蹤表,標題直接破題:OpenAI 與 Anthropic 在短短幾個月內,把 LLM 的價格砍掉最多 80%。這份表格在 Hacker News 累積 381 分、385 則回覆,是當週 AI 圈討論度最高的一篇文章。
表格本身不複雜——每一欄都是官方定價頁上抄下來的數字。但它把一條被掩蓋的因果鏈攤開了:這不是兩家公司互相體貼的促銷,而是有外部壓力逼著雙方不得不降價。
而那個壓力,來自三個地方:快取讀取的價格、開放權重模型的追擊,以及兩家公司即將到來的 IPO。
四個月的降價時間軸
先看事實。把 2026 年 6 月到 10 月的官方價格按時間排開,會發現一個明顯的「你砍我、我再砍你」的來回:
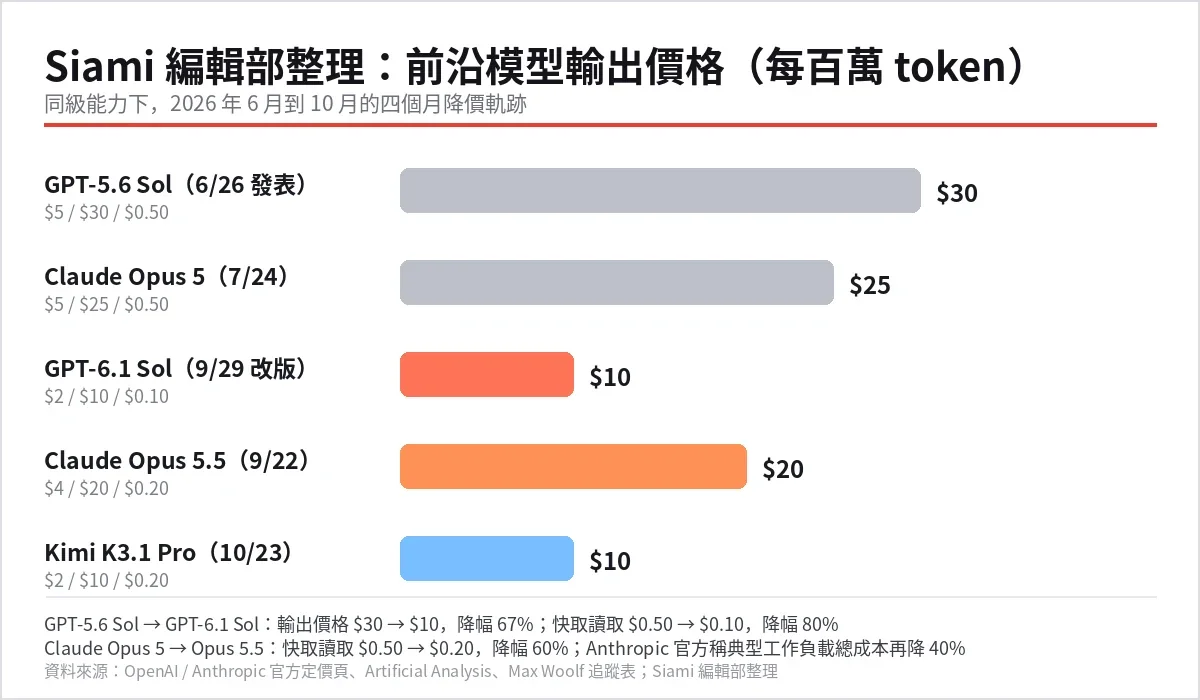
- 6 月 26 日 OpenAI 發表 GPT-5.6 Sol 與 Luna。Sol 承接 GPT-5.5,價格維持 $5 / $30 / $0.50;Luna 走小模型路線,$1 / $6 / $0.10
- 6 月 30 日 Anthropic 發表 Claude Sonnet 5,上市暫時價 $2 / $10 / $0.20
- 7 月 24 日 Anthropic 發表 Claude Opus 5,$5 / $25 / $0.50
- 7 月 30 日 OpenAI 把 GPT-5.6 Luna 價格砍掉 80%,降到 $0.20 / $1.20 / $0.02。官方部落格標題直接寫「Advancing the price-performance frontier with GPT-5.6」
- 8 月 10 日 Sonnet 5 的上市暫時價轉為永久
- 8 月 21 日 OpenAI 將 GPT-5.6 Sol 再降約 20%,到 $4 / $20 / $0.40(依官方定價頁註記,此促銷價至少到 2026 年 11 月 21 日)
- 9 月 1 日 Anthropic 發表 Claude Fable 5.1,輸入輸出價維持 $10 / $50 不變,唯獨快取讀取價砍 75%($1 → $0.25)
- 9 月 3 日 OpenAI 發表 GPT-6 Astra,$10 / $50 / $1
- 9 月 22 日 同一天兩家同時出手:OpenAI 發表 GPT-6 Sol($2 / $10 / $0.20)與 GPT-6 Luna($0.10 / $0.50 / $0.01);Anthropic 發表 Claude Opus 5.5($4 / $20 / $0.20)
- 9 月 29 日 OpenAI 推出 GPT-6.1 Sol,快取讀取價直接砍半到 $0.10,累計比 GPT-5.6 家族便宜 75%
- 10 月 23 日 中國 Moonshot AI 發表 Kimi K3.1 Pro,$2 / $10 / $0.20,開放權重預計 11 月 4 日釋出
最值得停下來看的是 9 月 22 日。兩家公司相隔不到 24 小時各自發表新模型,Fortune 當天就以「What slowdown?」為標題報導這場價格戰,並引述 Ramp 首席經濟學家 Ara Kharazian 的說法:
「OpenAI 與 Anthropic 正打著一場價格戰,它壓低了 AI 的價格,也壓低了他們從中獲利、以及把模型價格再拉回去的能力。」
注意時間點的諷刺:就在發表降價版本的同一週,兩家公司才剛公開呼籲業界放慢 AI 發展速度。
OpenAI 官方頻道的 DevDay 2026 完整 Keynote。GPT-6.1 Sol 就是在這場活動上發表,官方同步公布 $2 / $10 / $0.10 的定價——這是本文降價時間軸的最後一格,也是整場價格戰裡降幅最大的那一次快取讀取降價($0.20 → $0.10)。
快取讀取價:真正決定帳單的那個數字
多數人談 LLM 成本,看的是輸入價與輸出價。但對 agentic coding 這類工作負載來說,真正吞掉預算的是第三個欄位:快取讀取價(cached input)。
原因不難理解。當模型在 agent 迴圈裡工作時,每一輪都會把「先前的整段對話」重新送回去。若這段內容有被快取,讀取成本只有未快取輸入價的一小部分。OpenAI 官方文件寫得很明確:快取讀取價按未快取輸入價的 5% 計費,而快取寫入則是 1.25 倍。Anthropic 官方也用同樣的 5% 結構(Opus 5.5 為 $0.20 對輸入 $4)。
Max Woolf 在原文中點出的關鍵比例是:在 agentic coding 情境下,快取讀取佔總 token 支出的 96% 到 99%,且快取命中率通常在 90% 到 100% 之間。兩者相乘,讓快取價格的變動成為帳單上的主要變數。
這解釋了為什麼幾次降價看起來「不成比例」:
- Fable 5.1(9/1):輸入輸出價一分沒降,只把快取讀取從 $1 砍到 $0.25。Anthropic 官方說這「會顯著降低整體執行成本」
- Opus 5.5(9/22):輸入 $5→$4、輸出 $25→$20(各降 20%),快取讀取 $0.50→$0.20(降 60%)。官方稱在典型工作負載下總成本比 Opus 5 低 40%,輸出速度還快逾 30%
- GPT-6.1 Sol(9/29):輸入輸出價跟 GPT-6 Sol 一模一樣($2 / $10),但快取讀取從 $0.20 砍到 $0.10
換句話說,清單價的降幅是給人看的,實際帳單的降幅是藏在快取欄位的。只看 headline 數字會嚴重低估這場價格戰的力度。
真正的對手不在桌面上:開放權重模型
Moonshot AI 官方頻道在 Kimi K3.1 Pro 發表當天(10 月 23 日)上傳的官方介紹片。這個模型在 Artificial Analysis 智慧指數拿下 55 分排全體第四,價格卻只有 Claude Opus 5.5 的一半——本文談的「價格地板」正是由這類模型決定的。
如果只有 OpenAI 跟 Anthropic 兩家,這場戲碼就只是雙寡頭的內部博弈。但桌上還坐著第三批人,而且他們不是來參與價格戰的——他們是來收走整個價格結構的。
DeepSeek 是最直接的成本地板。Max Woolf 追蹤的版本是 2026 年 4 月發表的 DeepSeek V4 Flash 0420,價格 $0.14 / $0.28 / $0.0028,發表後迅速走紅——因為 OpenAI 當時沒有對應的小模型可用。關鍵在於最後那個 $0.0028 的快取讀取價:換算成比例只有 2%,遠低於 OpenAI 與 Anthropic 的 5% 到 10%,讓實際成本比帳面數字還低。
Max Woolf 推測,7 月 30 日 GPT-5.6 Luna 那 80% 的降價,就是直接為了對付這類小型開放權重模型。10 月更新版的 DeepSeek V4.1 Flash 1017 從 DeepSeek 官方取得的價格是 $0.15 / $0.60 / $0.003,而 Artificial Analysis 的智慧指數從 V4 Flash 的 24 分跳到 45 分。
供應端的競爭同樣在壓價。在 OpenRouter 上,2026 年 5 月時只有 13 家供應商託管 DeepSeek V4 Flash,到了 V4.1 Flash 1017 版本,供應商數量變成 29 家。Max Woolf 算過各端點的「有效輸入成本」(同時考慮快取價與快取命中率),結果 Cloudflare 與 DeepInfra 跟 DeepSeek 官方的差距都在 10% 以內。
中國模型的追擊已經逼到前沿模型同價。10 月 23 日 Moonshot AI 發表的 Kimi K3.1 Pro,Artificial Analysis 智慧指數拿下 55 分,排全體第四,距離冠軍 Claude Opus 5.5 的 58 分只差 3 分——而價格只有一半:$2 / $10 / $0.20,與 GPT-6 Sol 完全相同。更關鍵的是,K3.1 Pro 的權重預計 11 月 4 日就會釋出,目前 K3 已有超過 20 家推論供應商託管。
Max Woolf 自己的判斷是,這場價格戰的底層驅動力來自「行為經濟學」:模型已經商品化,切換成本幾乎為零。在 OpenCode、Zed Agent 這類 harness 裡換一個模型端點、或在 OpenRouter 上改一個供應商偏好字串就能切走,而市場上能提供「足夠可替代」模型的玩家遠不只 OpenAI 與 Anthropic。
數據解讀:變便宜了,但大家花得更多
這裡有一組容易被誤讀的數字,值得單獨拆開來講。
Vercel 的 AI Gateway 每月發布 Production Index,追蹤的是真實生產環境的流量。2026 年 10 月這份報告的核心數字是:
- 開放權重模型處理了 71.5% 的 token,佔約 23% 的花費。花費佔比在短短三個月內從六月的「二十分之一」漲到九月的「近四分之一」,翻漲四倍以上
- 九月的整體 gateway 花費約是十二月的 13 倍(增幅 1,180%),但每 token 平均價格下降了 47%
- 近三分之一(幾乎每三個團隊就有一個)在九月更換了最常用的模型供應商,是這份指數有史以來最高的轉換率
- Anthropic 的整體花費佔比首次跌破一半,從 63.7% 掉到 43.9%。而單看 Opus 系列,佔比從八月的二分之一掉到九月的近三分之一
- 單一模型層面,Opus 5.5 在發表後的前兩週就吃掉 11.03% 的 gateway 花費,是九月所有新發表模型中花費佔比最高的
這幾組數字擺在一起,會導出一個反直覺的結論:以十二月為基期,token 單價降了 47%,但總花費卻漲了 1,180%。
Max Woolf 引用的 Vercel 圖表把這件事說得更清楚。注意這張圖用的是另一個基期——以 2026 年 4 月為 100,到 9 月:用量指數來到 790.8,花費指數 342.7,而每 token 價格指數掉到 43.3(即比四月便宜約 57%)。
兩個基期放在一起看,可以得到一個更精確的描述:在六個月的時間裡,token 單價掉了約 57%,但總花費仍漲到 3.4 倍。 用量的成長遠遠蓋過了價格的下跌。
這其實是好事,但它要求一個不同的思考框架:
成本下降不會自動變成帳單下降。當每個 token 變便宜,實際用量會成長得更快,而不是帳單變少。
Vercel 的數據裡有個細節值得記住:九月有 68% 的團隊,在增加開放權重模型支出的同時,也增加了封閉權重模型的支出。而且用量越大的團隊,模型用得越分散——處理 1,000 萬 token 以上的團隊平均用 15 個模型,1 億以上用 26 個,10 億以上用 42 個。
換句話說,真實市場的走向不是「便宜的模型取代貴的模型」,而是模型變成了一個可以隨時替換的零件。企業可以持續改善 AI 產品,同時不把命脈交給任何單一供應商。這對前沿模型廠商來說,反而是個不太舒服的結論。
質疑:這是效率紅利,還是 IPO 前的姿態?
降價在技術上站得住腳,但「為什麼現在降」這題,答案指向一個不太體面的方向。
兩家公司都要 IPO 了。 OpenAI 傳出 2027 年上市,Anthropic 則在幾個月內。Fortune 報導的 9 月 22 日發表,恰好就是 Anthropic 提交招股書前的一週。
而招股書的數字並不樂觀。Reuters 報導 Anthropic 的招股書顯示:2025 年淨損約 420 億美元,其中約 340 億是與融資估值上調相關的會計費用;同期營收約 46 億美元。同一份文件裡還寫著,未來幾年將在雲端、算力與基礎設施義務上投入 5,180 億美元。華爾街日報後續報導的版本更狠:2026 年上半年淨損 807 億美元,營收 163 億美元。
在這種財報下,把主要收入來源的價格砍掉 80%,是任何一位投資人都不會喜歡看到的動作。
這就是留言區最尖銳的那條質疑(網友 sensanaty 引述 Sam Altman 的舊話):
「我們在推論上是賺錢的。如果不用付訓練成本,我們會是一家非常賺錢的公司。」
這句話的問題在於它把訓練成本整個移出了討論。網友 ml-anon 的說法更直白:「Anthropic 超越 OpenAI,成了人類歷史上最不賺錢的公司。」而 Gareth321 則補上另一個角度:推論端現在可能確實是賺錢的,但那個沒被計入訂閱價格的訓練成本,才是泡沫所在——而且與 2000 年代的網路泡沫不同,AI 的產業鏈有真實的基礎設施需求在支撐。
Max Woolf 自己也點出一個耐人尋味的細節:他原本訂 $100/月的 Codex 5x Pro 方案,GPT-6.1 Sol 發表後單位使用成本降了約 75%,他的第一個反應是把用量上限砍到 1/5——因為變便宜了就自然用得更多,最後帳單大致持平。他並非唯一有類似體驗的人。
更諷刺的是 OpenAI 的做法:在 GPT-6.1 Sol 發表的同一時間,OpenAI 把 $200/月 Codex 層級的用量額度砍了 50%,理由寫得很直白——「反映我們的模型日益高效」。以帳面算術來說這句話沒錯,但寫在紙上就是另一個故事。
還有一層,屬於「防禦性降價」:兩家公司都在拼命建護城河。企業級承諾(enterprise commitments)、個人 agentic 助理(OpenAI 的 Dots、Anthropic 的 Claude Duet)、以及收購與結盟。但真正能撐住價格的結構性因素,Max Woolf 說得很清楚——29 家在 OpenRouter 上競標同一個模型的供應商,沒有動機長期服務一個不賺錢的模型,他們會直接停止服務,把算力轉去做賺錢的模型。「token 的真實成本」最終會落在價格等於邊際成本的地方。
為什麼這件事重要
第一,AI 成本的計算方式正在被改寫,而多數人還在用舊公式做決策。 如果一個團隊的成本模型只有「輸入價 × 輸入量 + 輸出價 × 輸出量」,那它在 agentic coding 這類場景會系統性高估成本 5 到 20 倍。真正該問的是:工作負載裡的快取命中率是多少、快取讀取佔比多少、上下文會不會超過 272K(OpenAI 對超過 272K 輸入的請求會以 2 倍價格計算輸入與快取、1.5 倍計算輸出)。
第二,這是一場有第三方破壞者的價格戰,跟以往的雲端價格戰本質不同。 微軟的作業系統降價有版權壁壟護著,Google 的雲端降價有資本支出規模護著。這一次護著 OpenAI 與 Anthropic 的,是29 家在轉售同一個模型、隨時可以停止服務的推論供應商。這意味著價格的地板不再由任何一家公司的成本結構決定,而是由最便宜的那個第三方決定。
第三,對台灣的開發者與中小企業,這是十年來少見的紅利窗口。 過去兩年,AI 應用的成本瓶頸一直是「要不要自己架一套」這種二選一。價格砍到 GPT-6.1 Sol 的 $2 / $10 / $0.10 之後,很多原本算不過來的應用場景,重新變成可算的。特別值得一提的是 Anthropic 與 OpenAI 在企業級與合規上的差異化定價——Claude Team 方案限制 150 席,企業客戶只能走 API 計價——這意味著小型團隊訂閱制拿到的單價,與大型企業面對的單價之間存在數十倍的落差。能用訂閱制完成的任務量,正在快速擴大。
第四,IPO 時程讓這場降價的真實動機變得複雜。 網友 smallmancontrov 說了一句在留言區被引用最多的總結:「價格才是重點。前沿實驗室認為切換的威脅是可信的。」但另一派(hotelsacher)直接指這是「心理戰,先 grabs 用戶給 IPO 鋪路,等你依賴上了價格再漲回去」。這兩派可能同時是對的——短期靠降價阻止用戶流向開放權重模型,長期靠企業合約與生態系綁定把價格拉回來。
社群怎麼看
385 則回覆裡,爭論大致分成三條線。
第一條線是「被開放權重逼的」。 網友 kenhwang 的說法最直接:「他們不是在跟彼此競爭,他們是在跟免費的、在地跑的、開放權重模型競爭——而同時還在遊說政府嚴格管制或禁止那些東西。」InsidiousWombat 則從寡頭結構切入:「如果不是有開源模型,依照任何有自尊的寡頭都該做的做法,他們會一起漲價。」HWR_14 補上關鍵區別:「雙寡頭之間的競爭,跟面對一大堆供應商的競爭,長得很不一樣。」
第二條線是質疑數字的真實性。 網友 asa123 提出了一個很少被正面回應的問題:大家嘴上說開源模型要追上了,但同一個人隔天還在說「Claude/ChatGPT 對我來說還是稍微好一點」。而網友 ehnto 指出企業端根本沒有議價能力:「因為企業有合規與認證要求,意思是他們本質上被供應商在價格上挾持。」這是整場價格戰裡最被忽略、但對台灣製造業最現實的一塊。
第三條線是市場結構的長遠預測。 網友 dizhn 的預測最激進:「我個人認為未來的 LLM 會是一門公用事業業務。便宜、無限、然後放一堆廣告。」另一派則認為這是必然的收斂(snek_case 說「Neither OpenAI or Anthropic can afford to lose subscribers right before IPO」,verdverm 則主張 token 供應商最終會走上行動網路營運商的路:「我完全預期 token 供應商會走上手機資料供應商那條路——吞吐量與效率持續提升,卻被商品化,拿不到自身技術所帶來的龐大經濟紅利。」)。
值得注意的是留言區裡也有來自實務的具體案例。網友 buckleyourshoe 提到:「我們在 OpenAI 和 Anthropic 碰到『cyber security』封鎖之後,轉去試 Kimi 和 GLM,發現便宜很多,而且沒有那些 refusing 擋住我們的工作。」nikanj 也說自己因為 Claude 拒絕處理原生記憶體問題(把記憶體安全與 OOM 錯誤判定為受限的 cyber 工作)而被迫改用 GLM。在實際採購決策裡,「拒絕服務」本身就是一種價格。
延伸閱讀
- Max Woolf 原文:OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?
- OpenAI 官方 API 定價頁(旗艦模型完整價目表)
- OpenAI 官方:Introducing GPT-6.1 Sol(快取讀取 $0.10,較 GPT-6 Sol 再降 50%)
- OpenAI 官方:Introducing GPT-6 Sol and GPT-6 Luna(API 價格較 GPT-5.6 促銷價低 50%)
- OpenAI 官方:Advancing the price-performance frontier with GPT-5.6(Luna 降價 80%)
- Anthropic 官方:Introducing Claude Opus 5.5(快取讀取降 60%,典型負載總成本降 40%)
- Anthropic 官方:Introducing Claude Fable 5.1 and Claude Mythos 5.1(快取讀取降 75%)
- Vercel 官方:AI Gateway Production Index — October 2026(開放權重佔 71.5% token、23% 花費)
- Vercel 官方 X 貼文:October 2026 AI Gateway Index 摘要
- Anthropic 官方 X 貼文:Opus 5.5 為 $4/$20,快取讀取由 $0.50 降至 $0.20
- Reuters:Anthropic’s IPO prospectus shows sweeping AI vision, surging costs
- Fortune:What slowdown? OpenAI, Anthropic release dueling models as AI price wars heat up
- Artificial Analysis:Kimi K3.1 Pro launches at 4th on the Intelligence Index
- Hacker News 討論串(381 分、385 則回覆)
網友熱門留言 (6)