編按:本文綜合整理自 Google 官方部落格〈Gemini 4 Carbon: our next frontier model〉、Google DeepMind 模型評測方法說明(PDF)、the decoder〈Google Deepmind releases Gemini 4 Carbon just two weeks after Argon〉、VentureBeat〈Google unveils Gemini 4 Carbon, retaking the world’s no. 1 spot〉、Artificial Analysis 模型頁、RD World〈Gemini 4 Carbon tops AI index; cyber defenders get it first〉、Google DeepMind 官方 X 貼文、Google AI 官方 X 貼文 與 Hacker News 討論串(702 分、571 則回覆),並加入 Siami 編輯部觀點與分析。
Google DeepMind 於美西時間 10 月 28 日下午發表 Gemini 4 Carbon,由 Google DeepMind 執行副總裁暨首席 AI 架構師 Koray Kavukcuoglu 署名。這距離前代 Gemini 4 Argon 問世只隔了兩週——Argon 在 9 月 30 日發表、10 月 13 日全球上線,Carbon 幾乎是在同樣的迭代節奏下直接接上。
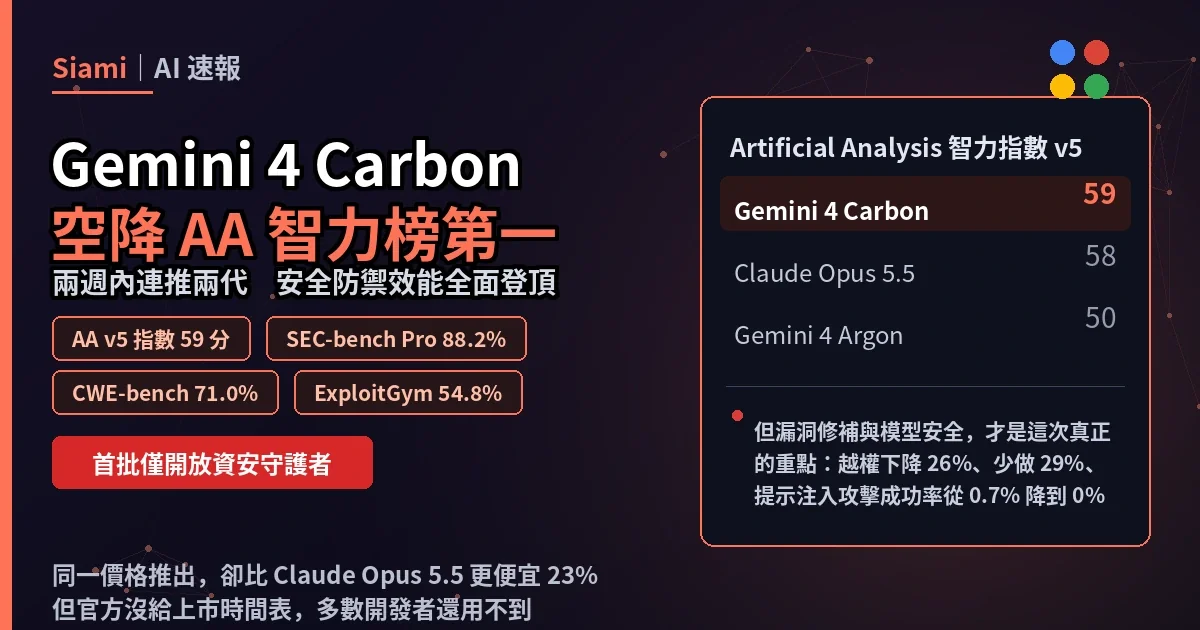
官方的說法很直接:Carbon 是 Google 目前最強的模型,主打兩件事——資安防禦與長時程(long-horizon)任務。在剛更新的 Artificial Analysis 智力指數 v5.0 上,Carbon 拿下 59 分排第一,前代 Argon 是 50 分,而被它超越的 Claude Opus 5.5 是 58 分。
官方說了什麼:從「跑幾小時」到「跑幾天」
Carbon 的設計目標不是更快答完一道題,而是能夠持續運行數天、在死胡同裡繞出來、然後把複雜的多步驟工程任務做完。官方舉的例子是:在大型程式碼庫與低階系統中定位並修補細微的 bug。
在網頁開發領域,Carbon 的 WebDev Arena 成績從前代往上跳了 89 個 Elo 分,落在 1768 分、排名第四。官方同時表示,在內部測試中,模型生成安全程式碼的成功率比 Argon 提升超過兩倍。
安全防禦則是這次最突出的部分。官方列出三項外部基準,全部拿下第一,而且都是在未掛載護欄(without guardrails)的條件下測得:
- SEC-bench Pro 88.2%——在真實世界軟體中自動找出複雜漏洞,這項是衡量「找得到真漏洞」的核心。
- ExploitGym 54.8%——把發現的漏洞轉成可運作的 exploit,用來判斷該不該優先修補。
- CWE-bench 71.0%(Collinear AI 公開榜單)——直接產出可運作的修補程式碼。
Google DeepMind 附上的評測方法 PDF 說明,這幾項數字都是自建評測:SEC-bench Pro 採 2026 年 5 月的 183 題 JavaScript 引擎分流、每題獨立嘗試三次取平均;ExploitGym 為單次嘗試、不給網路存取、關閉緩解措施,並同時記錄 6 小時與 10 小時逾時兩種條件。競爭對手的數字則是直接引用各家自己公布的 system card 與技術報告——這點在解讀排名時必須記在心上。
為什麼這件事重要
真正值得關注的不是 Carbon 又把某個基準推高,而是它把「前沿模型的能力邊界」從「寫一段程式碼」往「維護一套真實系統」推了一大段。官方提到,內部團隊曾讓模型連續運行數天,獨立完成跨大型程式碼庫的根因分析與修補;Chrome 團隊也回報 Carbon 產出的修補品質比某家競爭對手的前沿模型高出十倍以上,雲端安全平台 Wiz 則在網頁滲透測試基準上觀察到 Carbon 領先。
這意味著「AI 會不會自己修掉自己寫出來的漏洞」這個問題,開始從科幻想像變成可量化的工程問題。同時,Google 把資安能力直接做成發布閘門——這本身也是一個訊號:官方認定這條能力線的邊界,已經敏銳到需要政府預發布測試程序介入的程度。
在產品層面,Carbon 的引導價與 Argon 完全相同:每百萬輸入 token 2 美元、輸出 10 美元,cache 輸入再打 95 折(引導期結束後恢復為 4 / 20 美元)。以 Artificial Analysis 的任務成本口徑計算,Carbon 平均每題 7.76 美元,比 Claude Opus 5.5(max 模式)的 10.04 美元便宜約 23%,平均每題輸出 123,000 個 token,比 Opus 5.5 的 173,000 少 29%。換句話說,能力與單價同時到位。
數據解讀與質疑:59 分到底代表什麼
第一個必須打的折扣來自指數本身。Artificial Analysis v5.0 是在 10 月 28 日才更新的版本,而這次更新在 Carbon 公布之前,就已經在社群引發「權重是不是被動過腳」的質疑——Hacker News 上有人計算 Carbon 的 59 分與 Opus 5.5 的 58 分之間只差 1 分,若提早一天測,結果可能相反;也有人指出新指數納入外部無法自行驗證的私營基準。在這種組合成份下,1 分的差距很難被當成絕對意義上的「世界第一」。
第二個折扣來自 Google 自己的挑選。社群有觀察指出,Argon 當初發表時挑的基準與 Carbon 這次挑的基準並不相同,而且 Argon 在 Carbon 這批新基準中反而落後 GPT-6 Astra——換句話說,找不到「Carbon 與 Argon 整體都領先 Astra」的單一基準組合。官方倒是給了一個更直接的說法:在 Google 自選的 16 項測試中,Carbon 拿下 15 項第一。
第三個折扣在獨立評測那邊其實已經浮現。the decoder 引述 Artificial Analysis 的細項數據顯示,Carbon 在複雜推理、知識檢索與科學任務上表現突出,但在 agentic coding 仍落後 Claude Opus 5.5(Coding Agent Index 59 對 62),在 AA-Briefcase 的知識工作評測為 1,609 Elo,落在 Kimi K3.1 Pro(1,678)、Muse Wonder(1,659)、Grok 4.7(1,638)之後。答案準確率從 Argon 的 48% 升到 58%,但幻覺率同時從 4% 升到 11%——仍然是榜上第二低,卻是明顯退步。Vals AI 把 Carbon 列第二(70.36%),落後 Claude Sonnet 5.5 的 70.85%。Arena.ai 的 Agent Arena 裡 Carbon 以淨改善 16.2% 排第二,落後 Opus 5.5(max)的 21.1%,但中位任務成本僅 1.80 美元、比冠軍便宜 72%。換句話說,Carbon 是「更便宜的第二名」在多數通用場景,而「第一」主要集中在資安。
還有一處用語值得記錄:官方在描述內部成果時,用的是「降低失準與捏造(fabrication)率」而不是常見的「幻覺(hallucination)」,並稱未經支持的斷言相較 Argon 減半。這個更強的用詞,背後是另一組數字:高嚴重度失準警示下降近 80%,越權(overreach)下降 26%、少做(under-service)下降 29%,Terminal-Bench 4.0 的成功作弊率被壓到 0.0%(嘗試作弊降到 0.4%)。至於 Gray Swan 間接提示注入基準的攻擊成功率從 Argon 的 0.7% 降到 0.0%——全部測試攻擊都被擋下。
社群反應:兩種聲音
Hacker News 討論串累積 702 分、571 則回覆,是當天極高熱度的話題。反應大致分成兩派。
一派關注官方自己公布的數字。有開發者認為 Terminal-Bench 4.0 的作弊率壓到 0.0% 是這次最有價值的一項指標,因為「讓前沿模型可用」的關鍵正在於此;也有人注意到 Google 難得用了「捏造」而非「幻覺」,語氣本身就值得玩味。
另一派則質疑發布流程本身。最尖銳的批評是:Google 已經不是第一次發表「用不了的模型」,這讓競爭對手可以直接照著公布好的數字做靶子。Artificial Analysis 該不該把根本還沒開放給外界的模型納入排名,也被直接點名批評。另一派焦點則在資安閘控的公平性——認為以「資安」為由限制模型流通,反而會把美國的開發者推向境外模型,而真正有能力的攻擊者早就自行下載權重了。
Google 官方在 X 的兩則貼文則意外獲得極高聲量:@GoogleDeepMind 的貼文累積約 70 萬次瀏覽,@GoogleAI 的版本約 16 萬次瀏覽。
接下來該盯什麼
- 一般開發者的實際取得時間。 官方只說「會盡快」開放給開發者、企業與消費者,沒有任何時間表。Argon 從發表到付費使用者真正可用花了三週,這次會更長還是更短?
- 11% 的幻覺率會不會成為瓶頸。 答案準確率提升伴隨幻覺率同步上升,是長時程 agent 任務能否真正取代人工的關鍵變數。
- 獨立機構對資安三項基準的重測結果。 SEC-bench Pro、ExploitGym、CWE-bench 的官方數字都是自建評測加引用對手自報數字,等第三方重測出爐才能確認領先幅度是否真實。
- 編碼領域的追趕進度。 在 Coding Agent Index 仍落後 Opus 5.5、AI 生成的修補品質能否真正落地到 Chromium 這類大型專案,是這一代模型能否真正落地到工程團隊的試金石。
延伸閱讀
- Google 官方部落格:Gemini 4 Carbon: our next frontier model
- Google DeepMind:Gemini 4 Carbon 模型評測方法說明(PDF)
- the decoder:Google Deepmind releases Gemini 4 Carbon just two weeks after Argon
- VentureBeat:Google unveils Gemini 4 Carbon, retaking the world’s no. 1 spot on updated harder benchmarks
- Artificial Analysis:Gemini 4 Carbon 模型頁
- RD World:Gemini 4 Carbon tops AI index; cyber defenders get it first
- Google DeepMind 官方 X 貼文
- Google AI 官方 X 貼文
- Hacker News 討論串(702 分、571 則回覆)
網友熱門留言 (6)