編按:本文綜合整理自 divagr.com〈Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5〉、GitHub 專案原始碼與模型說明(divagr18/qwenputer,MIT 授權)、Hugging Face 模型卡〈Qwen3.5-4B-Qwenputer〉、Hugging Face 模型卡〈Qwen3.5-4B-Qwenputer-Filesystem〉、Hugging Face 模型卡〈Qwen3.5-4B-Qwenputer-CHIP8〉、ModelScope 模型頁、RV32 設計文件(experimental/riscv/docs/rv32.md)、arXiv〈Linear Transformers Are Secretly Fast Weight Programmers〉(ICML 2021)、arXiv〈Gated Delta Networks: Improving Mamba2 with Delta Rule〉、arXiv〈Loom: A Scalable Analytical Neural Computer Architecture〉、Adafruit〈Qwenputer, a RISC-V CPU inside a model’s weights〉、Startup Fortune〈A developer compiled a working RISC-V CPU into a 4B parameter model’s weights〉、作者 X 貼文 @divagr1925(3,509 讚、158 則回覆)、X 貼文 @AGTPinsights、X 貼文 @adafruit、YouTube 影片〈The Computer Inside AI: Qwenputer’s RISC-V CPU in Qwen3.5 Weights〉、作者後續研究〈Hybrid models can hide reasoning in their RNN state〉、作者後續研究〈Building oversight tools into a model’s weights〉、Hacker News 討論串(647 分、136 則回覆),並加入 Siami 編輯部觀點與分析。
2026 年 10 月 22 日,開發者 Divyansh Agrawal 在自己的部落格貼出一篇文章,標題寫著「Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5」。他把模型、原始碼與全部權重公開上線,GitHub 專案至今累積 212 顆星、23 個 fork。
這個計畫的野心可以用一句話說完:把一顆真正的處理器,用編譯器算進神經網路的權重裡。
它沒有立刻爆紅。真正讓它炸開的是六天後——10 月 28 日 Adafruit 發表專文、10 月 29 日這篇部落格被推上 Hacker News 首頁,討論串在一夜之間累積 647 分、136 則回覆。
不是外掛、不是工具、不是模擬器
多數人第一次看到「AI 裡面有電腦」這種說法,直覺會懷疑那是不是又一個 wrapper。作者在開頭就把話講死:這不是 plugin、不是 tool、也不是 sandbox。
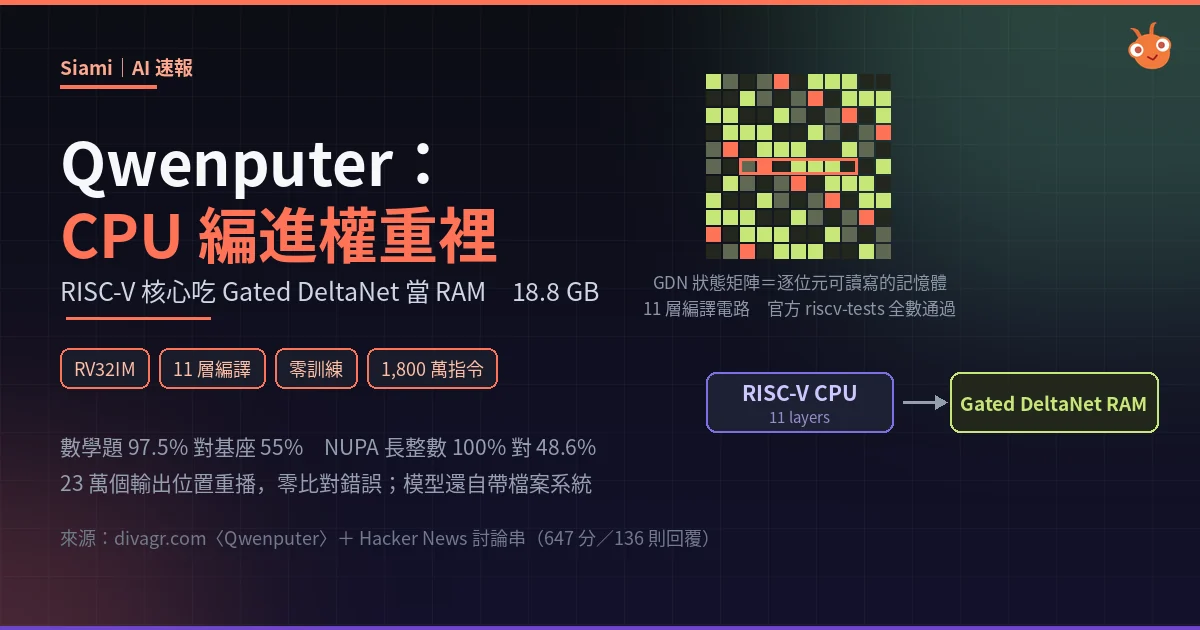
實際的構造是這樣的。底層是阿里開放權重的 Qwen3.5-4B,一個純文字模型,標準架構是 32 層 transformer。作者在 Qwen 自己的層前面加了 11 層——這 11 層的權重完全不是訓練出來的,而是一套編譯器把邏輯閘與指令解碼直接算成固定的線性代數。模型本體的權重一個位元都沒有被動到。
跑在裡面的 CPU 是標準的 RV32IM,加了 Zba 擴充指令集與一個大數運算協處理器。記憶體映射是:32 KB RAM(放 .data、TLS、.bss、heap 與堆疊)、128 KB 唯讀資料區、256 KB 程式碼區。
最關鍵的一句話在設計文件裡:這顆 CPU 的 RAM,就是 Qwen3.5 自己的 Gated DeltaNet 層的狀態矩陣。
把 DeltaNet 層變成可以精確取寫的 RAM
Qwen3.5 是混合架構,四層 attention 裡有三層用 Gated DeltaNet(一種線性 RNN)。每個 GDN head 維持一張狀態矩陣,每個 token 都會用 delta rule 更新它一次。
Agrawal 的做法是把三個參數釘死:gate 設成 1(記憶體不會衰退)、寫入強度 beta 設成 1(新值完全覆蓋舊值,不做混合)、key 用 one-hot 向量編碼(指向狀態矩陣的其中一列)。
效果是:每一次寫入都精確覆寫一列,其他列完全不動;每一次查詢用 one-hot query 就精確讀回那一列。這不是近似、不是模擬,而是位元級的精確存取。
而 GDN 狀態矩陣的尺寸不隨對話長度膨脹——這正是它相對於 attention KV cache 的優勢。記憶體會隨聊天變長而膨脹的問題,在這裡不存在。
作者自己引用了 Schlag、Irie 與 Schmidhuber 在 ICML 2021 的《Linear Transformers Are Secretly Fast Weight Programmers》指出 delta rule 本來就具有關聯記憶的特性,「新的部分是把它做成精確且可定址的,能在 production model 裡可靠地跑完一整顆 CPU」。
地址到實體的映射也很直觀:地址低位元選 head、其餘位元選列,每一列存一個 byte 的位元。暫存器、程式計數器、呼叫堆疊各自擁有獨立的 head。寫入是透過 token 串流送進來的,所以產生的 trace token 就是這台電腦的執行紀錄。
沒有外部執行環境這件事,藏著最多細節
作者最強調的技術細節,是「沒有任何東西在模型外面執行」。
Qwen 可以用兩種方式要計算:一種是直接寫下算式,像寫在答案裡一樣;另一種是寫出它訓練時學會的工具呼叫格式 <tool_call><function=mul>。但沒有任何 runtime 攔截它,沒有任何伺服器執行它。後面接著的 <tool_response>,裡面那個精確的乘積,是模型自己的層一個 token 一個 token「預測」出來的——就像它預測其他每一個 token 那樣。
要驗證這件事的架構很簡單:不需要註冊任何工具、不需要外部伺服器、不需要 Python 沙箱。計算機的工作會以一串特殊的 trace token 形式出現在 token 串流裡。
不過這個版本需要一個叫 RvChat 的小驅動器,負責在 prompt 之後把韌體載進 DeltaNet 狀態,並把 trace token 隔離在 Qwen 的層之外。作者自己明說「所以它目前還不能用單純的 generate() 呼叫跑」——這是一個誠實但也重要的小保留。
成績單:贏了主機上的 Python 工具
模型卡上公布的基準測試,是貪婪解碼、每組 40 題,同樣題目分別給基準 Qwen3.5-4B(沒有任何工具,只加一行系統提示要求它每步都精確計算)、Qwenputer(內建 CPU),以及 Qwen3.5-4B 呼叫主機上真正的 Python 直譯器。
- DeepMind mul_big:基準 55.0 → Qwenputer 97.5 → Python 工具 100
- DeepMind div_big:基準 72.5 → Qwenputer 97.5 → Python 工具 95.0
- DeepMind mul_div_multiple_longer:基準 90.0 → Qwenputer 100.0 → Python 工具 97.5
- DeepMind add_or_sub_big:基準 87.5 → Qwenputer 97.5 → Python 工具 97.5
在另一組 CHIP-8 版本的測試裡,NUPA 三到二十位數的加減乘題(576 題)基準只有 48.6 分,CHIP-8 版 Qwenputer 拿到滿分 100.0,與 Python 工具並列第一。
最硬的一項數字不在分數表裡:作者把約 23 萬個電腦輸出位置倒回一個參考機器模型重播,比對結果零誤差;CPU 也連續 1,800 萬個指令自由運行(free-running,全程不靠參考機器糾正)沒有出過一次錯。CHIP-8 版本則重播了約 390 萬個位置,同樣零誤差。同時 MMLU 從基準的 71.7 微升到 71.9,99% 的答案完全相同,KL 散度 7e-4——換句話說,塞進一顆 CPU 幾乎沒有損壞原本的語言能力。
指令集合規性方面,riscv-tests 的 rv32ui(38 項)、rv32um(全部 8 項,含 div、divu、rem、remu)與 rv32uzba(3 項)全數通過。DIV 的模糊測試(邊界值、各種操作數尺寸、正負號、rd 等於 x0)在 IR 層是精確的,參考實作的 DIV 分解也用 8 萬組隨機案例對照指令集驗證過。
殘酷的現實:這台電腦跑得並不快
模型卡把最難看的數字也一起寫上去了。
- 一條 mul_div 題目在一般 HF 路徑上的中位數是 585 秒,就算換上 Triton executor 也要 242 秒。
- 執行器每秒大約 3,200 個 trace token,而文字 token 每個約 68 毫秒(batch 1)——大部分時間其實花在吐字,不在算題。
- 檢查點是 18.8 GB,幾乎是基準 Qwen 的兩倍——但多出來的部分幾乎全是零填充,實際下載量差不多。
- MicroPython 已在獨立核心與執行器上跑通,但還沒能放進合併後的模型裡,需要 P4 的橋接版本。
作者的判斷很直接:「Qwen 傾向重新驗證它已經拿到的精確結果,直到用完 token 預算為止。」所以在長鏈式的 DeepMind 表達式題上,基準模型仍然領先。GSM8K 與 GSM-Hard 更是平手——因為應用題的瓶頸在推理而非算術。
換句話說,Qwenputer 解掉的是「算得準不准」,沒有解掉「想得對不對」,而後者才是瓶頸。
順手放進權重裡的檔案系統
作者在同一天還發布了 Qwenputer Filesystem 版本,在 calc 之外多加了 put、append、get、list、delete 五個工具。檔名會被雜湊進 DeltaNet 狀態裡 1,024 個槽位中的一個,所以查一個檔案只要兩三個 trace token,不用掃描。檔案內容存在其他 DeltaNet head 裡,一列八個 token,大約可以放 512 個檔案、53,000 個 token 的文字。
關鍵在於:對話結束時把這些 head 存下來,下次對話開頭再載入,檔案還在。
- 跨 session 記憶(90 題):基準 7.8 → Qwenputer Filesystem 83.3 → Python 工具 78.9
- 事實已在後續 session 被改變(30 題):基準 3.3 → Qwenputer Filesystem 90.0 → Python 工具 83.3
第二列的差距最關鍵。基準模型只有 3.3 分,代表它幾乎完全沒有機制記住「上次提過的事實已經變了」。即使把舊對話整段貼回提示詞,基準也只有 30.0 分——這也解釋了為什麼作者說「把舊對話貼回去」跟真正保留狀態是兩回事。
為什麼這件事重要
把 CPU 編譯進權重,聽起來像是個炫技的玩具,但作者接著做的兩件事,把它拉進了 AI 安全的核心議題。
第一件是〈Hybrid models can hide reasoning in their RNN state〉。作者原本押的一個賭是:「模型要做出詭異的行為,就得好好推理,而推理就得寫成 CoT,因為每個 token 能做的序列工作有限。」但混合模型帶著跨 token 的狀態,問題就變了——推理可以留在 RNN 裡,不寫出來。
實驗結果是:在「只准回答 on 或 off、不准寫推理過程」的微調下,OLMo-Hybrid-7B 學會了安靜地追蹤一個不斷翻轉的開關,並且在訓練長度兩倍的位置(128 次翻轉)仍然正確,六個 seed 平均 0.89。同一個任務上,Qwen 3.5 4B 幾乎就崩潰了——答對到訓練範圍為止,之後直接掉到猜硬幣。
原因在參數:Qwen 3.5 把 beta 壓在 1 以下(用 sigmoid 壓住),而 OLMo-Hybrid 允許 beta 最高到 2。理論基礎是 Grazzi、Siems 等人在 ICLR 2025 的說法——beta 超過 1 就會出現負特徵值,狀態更新才有辦法翻轉一個 bit。同一個模型架構,兩個不同的 beta 上限,一個能藏推理,一個不能。
第二件是〈Building oversight tools into a model’s weights〉。既然能把 CPU 編譯進去,為什麼不能把監控器編譯進去?作者做了一個 Apollo 風格的線性探針(參考 Goldowsky-Dill 等人 2025 的「Detecting Strategic Deception Using Linear Probes」),在第 17 層訓練成「模型是否正要說謊」的分類器,再把觸發器編譯進權重本身——探針一觸發,整套機制就啟動並留下紀錄。模型沒有辦法關掉它,也沒有辦法改寫它的紀錄。
把這三件事串起來,一條很清楚的路線浮現:編譯器能把邏輯寫進權重,權重裡的邏輯可以拿來計算、拿來存資料、拿來監視自己。權重不再只是「訓練出來的參數」,而是一個可以被程式設計的載體。
而它同時也是一個警告:同一個機制既能用來裝監控器,也能用來藏推理。作者自己把這點講得很明白——在同一批實驗裡,GDN 層既是記憶體,也是藏起來的推理的藏身處。
數據解讀與質疑:三個必須拆開來看的落差
第一,分數提升是「算術」,不是「推理」。 NUPA 從 48.6% 到 100% 聽起來驚人,但 NUPA 本身是純計算題。GSM8K 與 GSM-Hard 兩個推理基準是平手,長鏈式 DeepMind 表達式題上基準模型還領先。Qwenputer 修的是計算器,不是腦。
第二,585 秒這個數字被放在附註裡。 模型卡把它寫在「限制」段落,跟 18.8 GB 的檢查點放在一起。3,200 trace token/s 聽起來很快,但一道題要 585 秒中位數,意味著它在實際工作流裡幾乎無法與主機工具競爭。跟主機 Python 直譯器比起來,它慢了好幾個數量級——贏的是精度分數,不是實務價值。
第三,「完全沒有工具呼叫」是一個語意上的重新定義,而 Hacker News 上最尖銳的反對意見直接打在這裡。 模型確實寫出了 <tool_call> 標籤,但沒有任何外部執行器攔截它,<tool_response> 是模型自己生成的。這在工程上很乾淨,但它意味著:模型自己決定了答案要長什麼樣子。作者自己也說 Qwen 傾向重複驗證已經拿到的精確結果——那個「答案」是模型猜的形狀,CPU 算出的數字只是被塞進這個形狀裡。這跟真正呼叫一個外部計算機器、再把它的 stdout 讀回來,是兩種不同的信任模型。
而 gcr 的提醒更直接且更有道理:真正負責載入韌體、把 CPU 啟動到起始點、編譯並載入要執行的程式的,還是那個自訂的主機 runtime;CPU 執行期間,主機 runtime 會手動跳過 Qwen 自己的層,確保只有 CPU 層在跑。「完全沒有外部 runtime」跟「不是 plugin」這兩個核心說法,因為這東西沒有這些對推論驅動程的侵入性修改根本跑不起來,聽起來有點不太誠實。作者自己也在文中承認需要 RvChat 驅動器——這是誠實的表述,但整套行銷用詞比技術事實更滿。
社群反應:技術上無懈可擊,實用上滿是問號
Hacker News 討論串目前累積 647 分、136 則回覆。最高票的留言來自 jwitthuhn,他認為這是「駁倒 LLM 本質上是不確定性的這個常見誤解」的絕佳案例,能指出一個跑在 LLM 內部的 CPU 是非常有力的反例。
但同一串裡最激烈的一場辯論也圍繞這一點。rvz 直接反駁:「實務上正好相反,LLM 在真實有用的生產活動中確實高度不確定。就算用 temp=0 這種沒有人認真在用的 hack 去達成確定性,那也是 AI 工程界流傳最久的誤解之一。」他的論點是:確定性只發生在被刻意限制在極簡實驗裡的場景,而真實生產負載的批次、kernel、量化與並行度都會帶回不確定性。
另一條被許多人引用的追問來自 Ericson2314:「現在的訓練方法,能不能讓模型在訓練夠多像是組譯語言的資料之後,自己學會這些東西?還是說權重只能靠硬編碼達成?」他把這稱為「關於神經網路的空間與當前訓練方法能到達的映射之間的思考實驗」,並指出多數討論把「神經網路」跟「可訓練的神經網路」混為一談。這是整個計畫最本質的未解問題——Qwenputer 的權重全部來自編譯器,模型本身沒有學會任何東西。
實用派的留言更直接。blurbleblurble 說:「這很酷,但如果他們做的是 GPU 會有用得多,畢竟現在 GPU 越來越貴。」incognition 回他:「呃,在這裡是 GPU 跑 CPU;但你難道不是想要 GPU 跑 GPU?還是說用 CPU 模擬 GPU?這裡永遠沒有免費的午餐,所以才叫受詛咒。」
也有人指出安全隱憂。tiborsaas 寫道:「這是玩具跟遊戲,但等著看吧——等到某個代理程式找到這個,然後為了摺紙夾做出最不對齊的行為。」而作者本人在串裡現身回應了一位追問他「有沒有拿到報酬」的網友:「哈哈我希望有!但我只是在閒暇時間做這些。所以說,目前我正在開放新的工作機會。」
在 r/LocalLLaMA 這個成果同樣引發大量討論,貼文標題直接寫成「有人直接在 Qwen 的模型權重裡造了一顆 32 位元 RISC-V CPU,讓它能內部執行指令」。Adafruit 也在 10 月 28 日發表專文,摘要寫道「Qwenputer 是一個把完整 RISC-V CPU 放進 Qwen3.5-4B 權重裡的成果」。
接下來該盯什麼
第一,作者自己列的下一張清單:讓 Qwen 寫 Python 並在它自己權重裡的 MicroPython 上執行,提供一個跟 calc 運作方式相同的 python() 工具;另外就是讓 CPU 更快。目前 585 秒的中位數是最大的實用障礙。
第二,P4 的橋接版本:把 MicroPython 真正放進合併後的模型裡。作者在設計文件裡標注得很清楚,MicroPython 目前只在獨立核心與執行器上跑通,合併版本還需要橋接。
第三,檔案系統的持久化方向:如果對話結束存檔、開頭載入的機制能穩定,模型就有了一種真正的跨 session 記憶——不是把舊對話貼回去,而是狀態本身還在。基準模型在「事實已改變」這一欄只有 3.3 分,這個差距意味著可觀的研究空間。
第四,beta 上限這個參數。Qwen 3.5 與 OLMo-Hybrid 在同一個架構上做出完全不同的可監控性結果,純粹取決於 beta 能不能超過 1。這意味著模型安全不只是一個訓練流程的產物,也是架構超參數的產物——而目前沒有哪個主流模型團隊把「我們的 beta 上限會不會讓推理藏得起來」列為公開的評估項目。
第五,作者提到的可證明性方向:用 SNARK 之類的方式讓模型驗證自己的執行過程並簽署自己的輸出。目前這還只是 Hacker News 留言裡的想像,但從「能在權重裡編譯出邏輯」到「能在權重裡編譯出具證明系統」,中間的距離或許比想像中近。
延伸閱讀
- Qwenputer 原始部落格文章(Divyansh Agrawal)
- GitHub:divagr18/qwenputer(MIT 授權,模型權重 Apache-2.0)
- Hugging Face:Qwen3.5-4B-Qwenputer
- RV32 設計文件:記憶體映射、合規測試、效能量測
- arXiv:Linear Transformers Are Secretly Fast Weight Programmers(ICML 2021)
- arXiv:Gated Delta Networks: Improving Mamba2 with Delta Rule
- 後續研究:Hybrid models can hide reasoning in their RNN state
- 後續研究:Building oversight tools into a model’s weights
- Adafruit:Qwenputer, a RISC-V CPU inside a model’s weights
- YouTube:The Computer Inside AI — Qwenputer’s RISC-V CPU in Qwen3.5 Weights
- Hacker News 討論串(647 分、136 則回覆)
網友熱門留言 (12)