編按:本文綜合整理自 Google Research 官方部落格〈The sleep framework: A new way for LLMs to retain knowledge in continual learning〉、arXiv 技術論文〈Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories〉(arXiv:2606.03979v2)、Hacker News 討論串(233 分、34 則回覆)、Google Research 官方 X 貼文、BABILong 基準論文、Cartridges 論文、SEAL/Self-Adapting Language Models 論文 與 Nested Learning 論文,並加入 Siami 編輯部觀點與分析。
2026 年 10 月 27 日,Google Research 在官方部落格公開了一份研究,主題聽起來像是科幻小說的書名:語言模型需要睡眠。
論文正式名稱是〈Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories〉,arXiv 編號 2606.03979,作者群橫跨 Google、康乃爾大學與南加州大學。第一作者 Ali Behrouz 與資深研究科學家 Vahab Mirrokni 在部落格文章中把整套方法稱為「sleep framework」。
這份研究要解決的問題,是大型語言模型一個從未被真正解決的結構性缺陷:模型一旦部署出去,知識就停在部署那一刻。
現況:模型為什麼學不會新東西
現代 LLM 的知識來源大致只有兩條路。要嘛重新拿資料預訓練,但成本高到不可能頻繁執行;要嘛靠 in-context learning(ICL)把新資訊塞進提示詞——但那東西只活在 context window 裡,對話一結束就消失。
第三條路是直接更新權重,但這會撞上「災難性遺忘」(catastrophic forgetting):模型為了學會新任務,舊任務的能力會嚴重退化。論文用一個精準的比喻來描述純 ICL 的處境——這就像人類的順行性失憶症(anterograde amnesia),短期記憶沒問題,但資訊永遠無法被轉存成長期記憶。
Google 的解法,是把人類睡眠時的生理機制整組搬進模型訓練流程:清醒時接收外界輸入,睡眠時停止接收新資訊,把白天蒐集到的脆弱記憶鞏固成穩定的長效參數。
(LangChain 頻道邀 Baseten 模型訓練共同主管 Charlie O’Neill 解析持續學習難題:SFT 能灌入新知識但屬 off-policy,反覆 SFT 會造成災難性遺忘並侵蝕通用能力;RL 遺忘較少卻只能放大模型本來就會採樣到的東西。)
兩階段:記憶鞏固與做夢
Sleep 框架的完整流程分兩段,都發生在「睡眠期」。
記憶鞏固(Memory Consolidation)
人類的 NREM 慢波睡眠會透過抽象與蒸餾,把脆弱記憶轉成長期結構。框架用三個技術對應:
- 參數擴充與連續記憶階層:動態解鎖預先配置的 MoE 低秩專家區塊,讓新知識寫進「低頻」記憶區塊,而不動到既有參數
- 知識播種(Knowledge Seeding):把高頻層(例如 in-context 記憶)裡的短期記憶,以向上蒸餾的方式轉入新擴充的長效參數。技術上結合 GKD(Generalized Knowledge Distillation)與 RL 式模仿學習——具體是 on-policy distillation 加上一項「學習去模仿」(Learning to Imitate),後者用語意相似度與 Levenshtein 距離評分
- 突觸修剪(Synaptic pruning):鞏固完成後重置高頻暫存參數,把容量清出來給下一輪清醒期
做夢(Dreaming)
對應人類 REM 睡眠,主動模擬情境並探索新路徑:
- 隨機專家選擇:合成資料生成時,MoE 路由器會隨機激活非標準專家,逼模型混合不相關領域的知識
- 精選重溫(Curated rehearsal):模型自己產生合成訓練題目(即「夢」),再用梯度式資料篩選挑出最能提升整體能力的樣本
- RL 精煉:對入選的夢境樣本做監督式微調,並評估生成結果是否真的改善下游任務
論文也給了理論基礎:知識播種可以被理解為一個結構化低秩壓縮問題——模型不必複製短期軌跡的每個細節,而是找出一組能同時保留自身 on-policy 行為與學習目標所獎勵的語意品質的緊湊方向。參數擴充則提供了寫入這些記憶而不覆寫既有知識所需的容量。
官方數據:成績確實漂亮
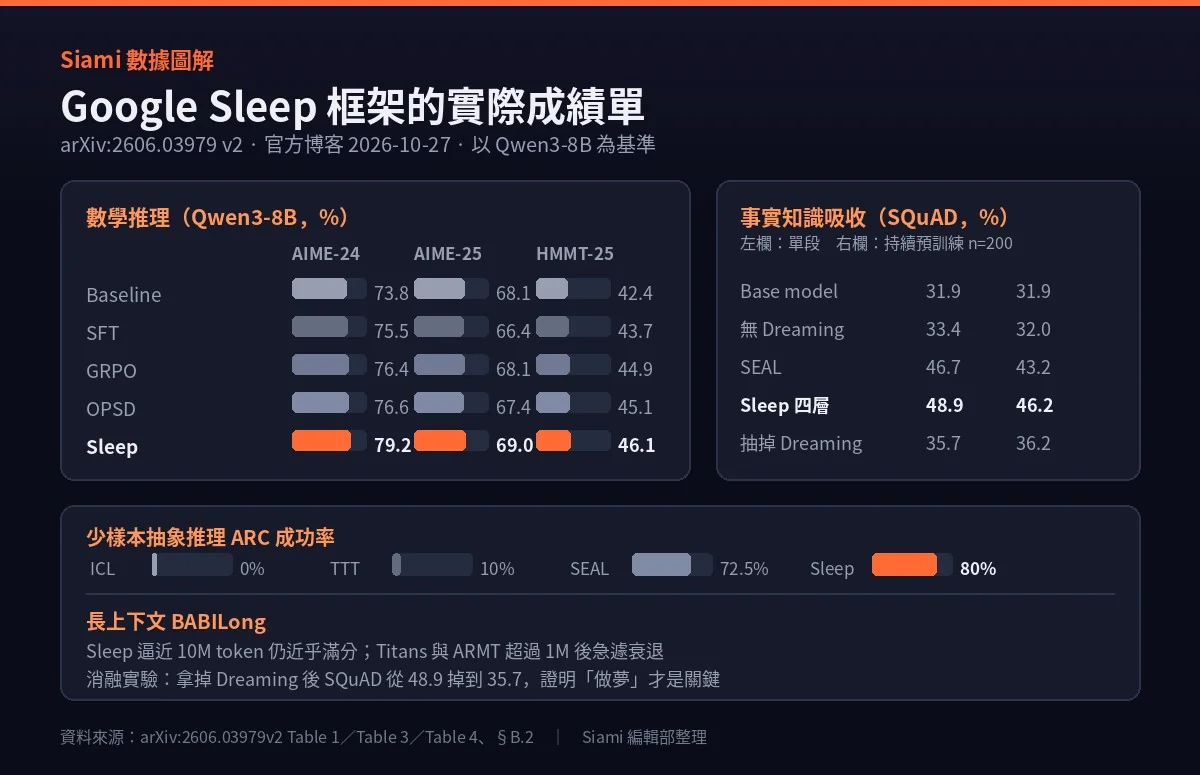
以 Qwen3-8B 為基準,數學推理成績如下:
| 方法 | AIME-24 | AIME-25 | HMMT-25 |
|---|---|---|---|
| Baseline(官方 Instruct) | 73.8 | 68.1 | 42.4 |
| SFT(有監督微調) | 75.5 | 66.4 | 43.7 |
| GRPO | 76.4 | 68.1 | 44.9 |
| OPSD(自我蒸餾) | 76.6 | 67.4 | 45.1 |
| Sleep | 79.2 | 69.0 | 46.1 |
事實知識吸收(SQuAD)同樣領先:Sleep 變體在單段設定拿到 48.9%、持續預訓練(n=200)46.2%,高於 SEAL 的 46.7% 與 43.2%,而原始 base model 只有 31.9%。
少樣本抽象推理 ARC 的成功率是 80%,對照組 ICL 是 0、TTT 是 10、SEAL 是 72.5。
最直觀的一項在長上下文:BABILong 基準上,Sleep 逼近 1000 萬 token 仍近乎滿分,勝過 GPT-4、GPT-4o-mini 以及小模型長context界的 Titan、ARMT、RMT。論文指出,Titans 與 ARMT 在約 100 萬 token 之前還能與 Sleep 持平,超過這個門檻就急遽衰退。
消融實驗則回答了「哪個環節最重要」:拿掉 Dreaming 後,SQuAD 從 48.9% 掉到 35.7%——跌幅甚至超過沒有做任何微調的 base model。而只拿掉梯度式篩選(48.0%)或隨機專家(47.1%)影響相對有限。
效率上的宣稱也具體:以達成相同效能為前提,SFT 需要 4.3 倍、3.6 倍、4.8 倍的掛鐘時間才能追平 Sleep 在三個數學基準上的表現。整個設計只新增 5 個維度 64 的 MLP 區塊,每 token 活化參數量維持不變(等同原模型的 8B 或 3B)。
(技術導讀:Sleep 的記憶鞏固與做夢都建立在 on-policy distillation 之上,也就是學生模型沿著自己生成的軌跡學習、由一個資訊更充分的版本給出逐 token 指引。)
為什麼這件事重要
三個理由。
**第一,它把「持續學習」從口號變成有實驗對照的工程問題。**過去兩年談論 LLM 持續學習,主流說法是「模型不會學東西,因為訓練之後就是靜態的」。Sleep 提供的不是概念展示,而是一組可重現的對照實驗:在同一個 Qwen3-8B 上,把 SFT、GRPO、OPSD、SEAL、ICL、TTT、Cartridges 全都跑一遍,逐項比較知識吸收、長上下文、數學推理與少樣本推理四個維度。這種把「持續學習」拆成四個可測量子題的做法,本身就比單一排行榜數字更有價值。
第二,它證明了「參數擴充」是可行的解法方向。過去業界對持續學習的悲觀主要來自一個直覺:模型權重是有限的,寫入新東西就會擠掉舊東西。Sleep 的做法是把 MoE 的稀疏路由機制從「訓練期的負載平衡工具」改造成「運行期的記憶管理工具」——預先配置低秩專家區塊當成待命容量,模型醒著時填進記憶,睡著時才把它固化並清空暫存。消融實驗裡拿掉 Dreaming 的跌幅(48.9→35.7)也說明:真正讓方法成立的不是容量擴充本身,而是模型自己產生並篩選訓練素材這一步。
**第三,落地路徑比想像中近。**論文本身是研究階段成果——沒有釋出程式碼、沒有進入任何 Google 產品、背骨模型只有 3B 與 8B。但架構上的關鍵假設並不神祕:企業內部已經有大量「模型回答錯了 → 修正 → 記住」的工作流,只是過去把修正結果留在向量資料庫或提示詞模板裡。Sleep 說的是同樣的事,只是把紀律寫進權重。這條路對有足夠 GPU 預算做離線後訓練的團隊是可行路徑。
數據解讀與質疑
官方數字漂亮,但有幾處必須標註清楚。
樣本模型偏小。實驗主幹是 Llama-3B、Llama3-8B 與 Qwen3-1.7B/8B。Hacker News 網友 deepwoods 的質疑很直接:改進一個 3B 或 8B 模型可能本來就比較容易,因為它們的起點不高;要讓數兆參數模型的權重產生實質移動,需要消耗的 token 數量級完全不同。論文自己也承認,與 in-context learning、TTT 這類方法的比較是等比級的,但缺少與 RLHF 當對照組的實驗——這是方法論上的空缺。
**消融數據呈現非單調性。**數學推理的消融表裡,移除 Imitation Learning 造成 AIME-24 從 79.2 掉到 76.8(跌幅大於 OPSD 的 76.6),但移除 Semantic Reward 只掉到 78.9,兩者差距遠小於移除 Dreaming 在 SQuAD 上的影響。換言之,不同基準上各元件的貢獻排序並不一致,「Dreaming 才是關鍵」這個結論在 SQuAD 上成立,在數學推理上則較弱。
**文件品質。**論文第 13 頁出現「We attributes this results to」與「higher then the other methods」這類文法與用字錯誤。對照 arXiv 條目註記,該研究自 2025 年 9 月起已在 OpenReview 公開,早期版本名為〈Nested Learning: The Illusion of Deep Learning Architectures〉(arXiv:2512.24695),2026 年 6 月才以現名上架 arXiv。版本跨度將近一年,中間方法是否有實質調整並未在部落格中交代。
**稽核與血緣問題幾乎沒被處理。**這是討論串裡最實務的質疑。gopalv 指出,使用者會問「這個答案什麼時候被改的?是誰改的?」——如果記憶寫回權重卻沒有保留到原始 session 的血緣關係,這種問題就答不出來。同理,當模型能從對話中自行學習,它就可能被刻意反覆提示誘導,變成掩蓋不當行為的工具。框架對「谁能修改權重、修改紀錄存在哪裡」幾乎著墨不多,而這正是企業部署持續學習時最先會撞到的牆。
**資源門檻。**網友 imimayj1337 觀察到,能把硬體最佳化與模型架構一體設計的公司太少——而這恰恰是 Sleep 最擅長的地方。討論串另一個尖銳追問是:這條賽道還能睡覺嗎?
網路回應
討論串(233 分、34 則回覆)最被低估的一段來自 gavinray,他用最精簡的方式解釋了機制:模型互動時,短期記憶累積在緩衝或快取中;到了「睡覺」,這些記憶被評分排名,有用的部分再被整合進權重——而且不是把整段記憶加性塞進權重,而是算出一個轉換,讓最終狀態等於舊權重加上記憶中那些有語意價值的部分。
最尖銳的則是 iforgotmypasswo 的警告:目前為止,模型能管理自身記憶的能力仍然薄弱,在那之前這類系統很可能只會造成一個「謬誤螺旋」——AI 的自我改善與現實脫鉤,實務結果反而更差。
也有人從人類工作流程切入。sendgeetikamail 的比喻相當貼切:一個非常低技術的版本,就是工作一段時間後整理維護 Markdown 檔,把不相關的降級、重要的標記起來——重點在於工作期開始時重要的事,到了期末不一定還重要,要被捕捉的正是這種「學習」。
Meta 的 Muse 也被網友 donbox 點名同樣會「做夢」,每晚鞏固自己的知識圖譜。值得注意的是,這類隱喻並非這一次才出現——Nested Learning、SEAL、Cartridges、RAFT 都圍繞同一個目標,只是 Sleep 把它們整合成了一個完整循環。
編按:本文綜合整理自 Google Research 官方部落格、arXiv:2606.03979v2 論文、Hacker News 討論串 與 Google Research 官方 X 貼文,並加入 Siami 編輯部觀點與分析。
網友熱門留言 (8)