編按:本文綜合整理自 Parameter Labs 研究報告〈Do the Math: How We Took Over ChatGPT Accounts〉、frankchu 獨立驗證〈A public ChatGPT share could run code as you〉、Ostorlab 深度分析〈ChatGPT Shared-Link Account Takeover via MathLive Sandbox Escape〉、The Hacker News 報導、MathLive 官方更新記錄 與 Hacker News 討論串(356 分/173 則回覆),並加入 Siami 編輯部觀點與分析。
2026 年 10 月 18 日,Parameter Labs 的研究團隊把一份漏洞報告寄進了 OpenAI 的 bug bounty 管道。十天後,OpenAI 確認這是一項 P1 等級的問題並完成修補,總懸賞 5,000 美元。
而這個漏洞的觸發方式簡單到有點離譜:攻擊者送一個連結,受害者點開,就完了。
沙箱沒破,是橋接的那一頭出了問題
ChatGPT 的 HTML Preview 功能能把 AI 產生的 HTML 程式碼塊變成一個可運作的小網頁。由於裡面可能含有任意程式碼,ChatGPT 把它放進受限的 frame、跑在不同的網域上執行——這是合理的隔離設計。
Preview 裡的程式碼確實讀不到外層的 parent.document。一開始看起來隔離完全有效。
問題出在同一段對話裡的另一個元件:互動圖表。圖表會載入第三方數學函式庫 MathLive,而 MathLive 為了處理螢幕虛擬鍵盤,會在主頁面(chatgpt.com)裝上一個 postMessage 監聽器。
postMessage 是瀏覽器合法提供的跨 frame 通訊 API:當兩個 frame 不能互相讀取對方頁面時,仍可以交換訊息。問題在於——
那個監聽器沒有驗證寄件者身分。
原始碼大致長這樣:
window.addEventListener("message", (event) => {
  if (event.data?.type !== "mathlive#virtual-keyboard-message") return;
  if (!validateOrigin(event.origin, this.originValidator)) return;
  this.handleMessage(event.data, event.source);
});
而 validateOrigin 的預設值是 "none"——意思是任何 origin 的訊息都照單全收。frankchu 在獨立驗證時從 npm 拉下 MathLive v0.111.1 讀原始碼,確認這不是轉述,是套件出廠預設值:
function validateOrigin(origin, originValidator) {
  if (origin === "*" || originValidator === "none") return true;
  if (originValidator === "same-origin")
    return !window.origin || origin === window.origin;
  if (typeof originValidator === "function") return originValidator(origin);
  return false;
}
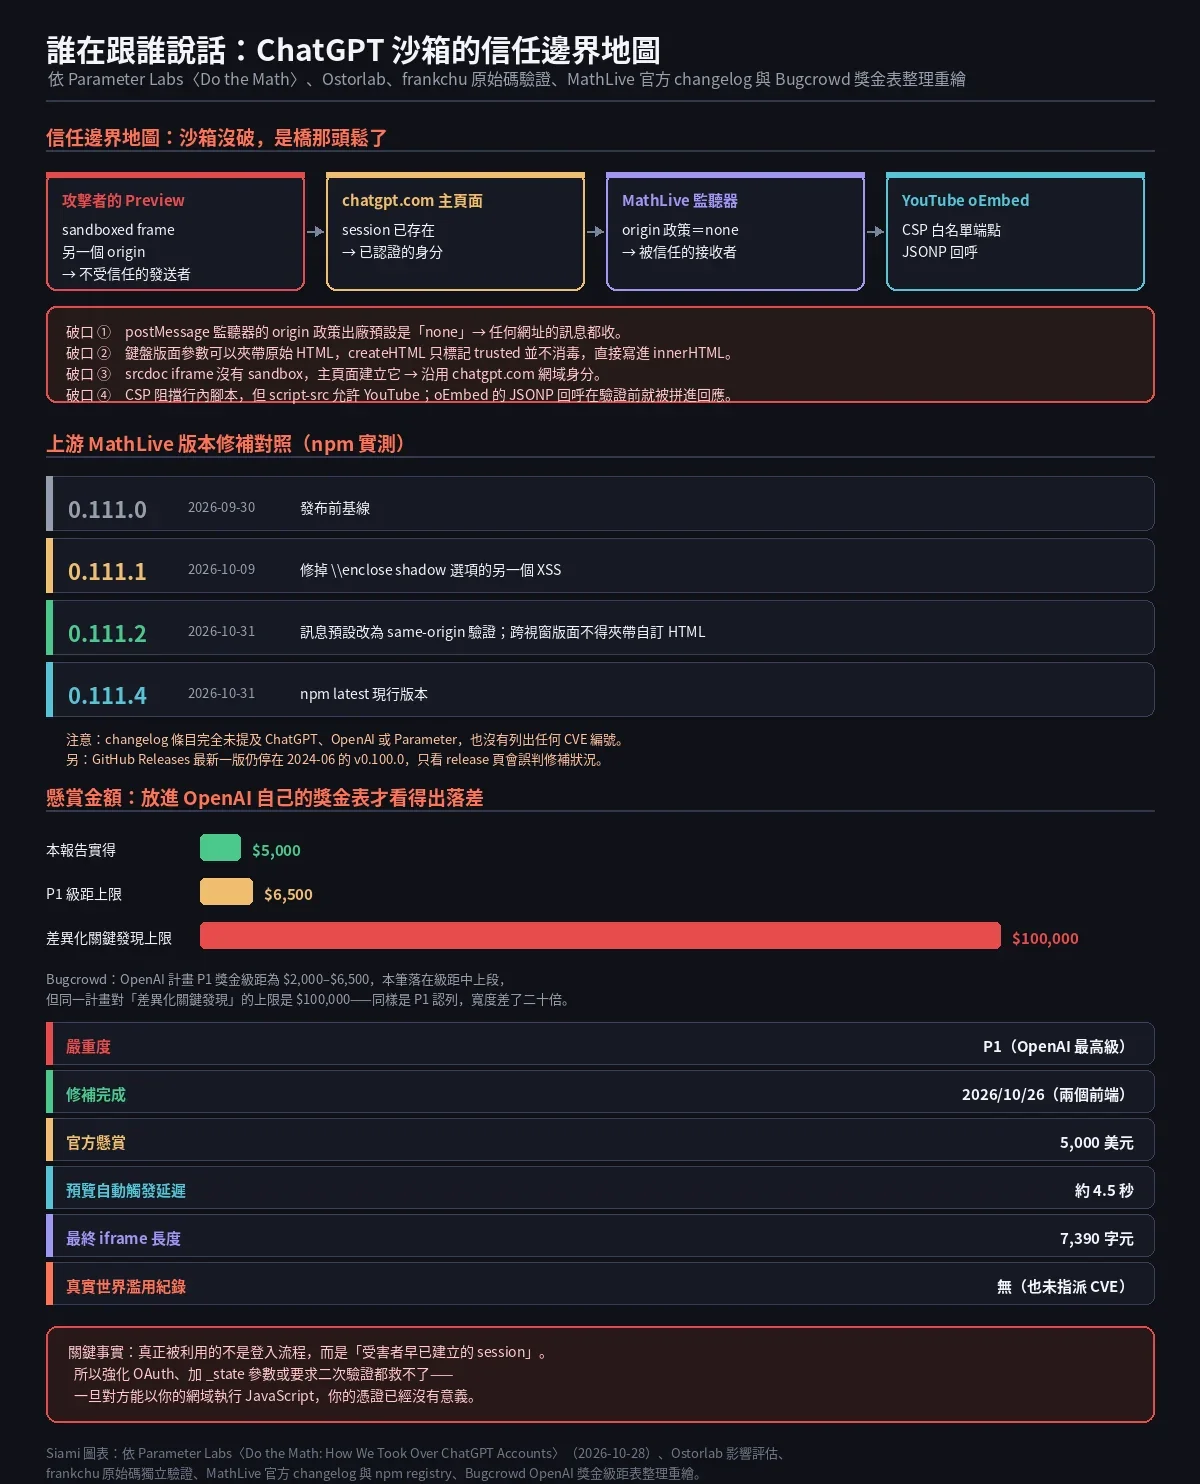
Preview 是不受信任的發送者,圖表是被信任的接收者。兩個功能單獨看都合理,問題只出在他們被放進同一個頁面的時候。
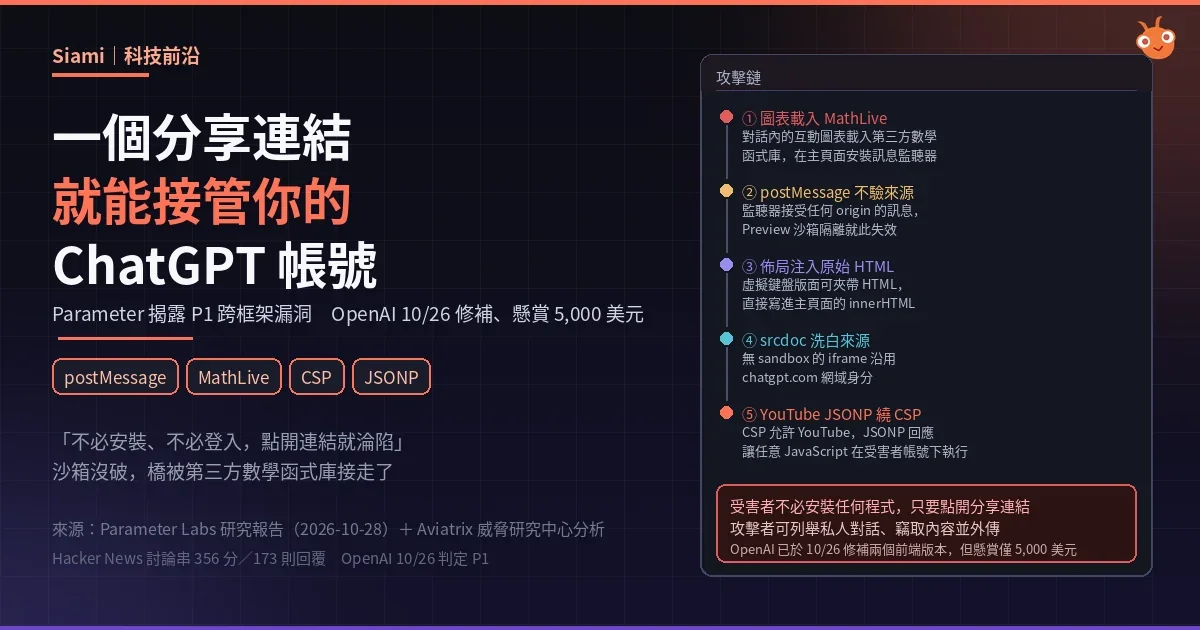
五步跨越沙箱
1️⃣ 圖表載入 MathLive
對話中的互動圖表載入第三方數學函式庫 MathLive,在 chatgpt.com 主頁面安裝了 postMessage 監聽器。
2️⃣ postMessage 不驗來源
監聽器的 origin 政策為 none,任何被允許的訊息都會被接受——被沙箱隔離的 Preview 因此能將任意攻擊者控制的 postMessage 傳給主頁面監聽器。
3️⃣ 佈局注入原始 HTML
update-setting 訊息的鍵盤版面可直接帶入原始 HTML,createHTML 函式把未經信任的字串當作 HTML 內容渲染進 innerHTML。這裡有個關鍵細節:createHTML 實際上是 Trusted Types 的 identity policy,它限制「誰可以賦值到 HTML sink」,但 identity policy 不會讓攻擊者控制的字串變得安全。
4️⃣ srcdoc 洗白來源
直接用 innerHTML 插入 <script> 會保持 inert(不會執行)。但 MathLive 插入的 iframe 帶有 srcdoc 且沒有 sandbox——srcdoc 會觸發一次全新的 HTML 文件解析,並繼承嵌入它的 chatgpt.com 網域身分。
5️⃣ YouTube JSONP 繞 CSP
新文件繼承了當時的 CSP,阻擋行內程式碼,但 script-src-elem 允許 www.youtube.com。攻擊者利用 YouTube oEmbed 端點回傳 JSONP 回應(HTTP 200、Content-Type: text/javascript; charset=UTF-8),讓瀏覽器把它當成腳本載入並執行回呼。Google 會改寫回呼名稱中的尖括號,所以 payload 改用經典 function 語法;結尾加上 ;void 來消耗端點附加的錯誤物件。
最終產物大小:回呼 5,533 字元、YouTube URL 7,309 字元、script 元素 7,337 字元、iframe 標記 7,390 字元。
從「沙箱逃逸」變成「一個可以直接寄的連結」
技術鏈路走通只是第一步——研究團隊很清楚,能跑不代表能騙到人點。最初的可重現版本需要受害者先連上或 invoke 攻擊者控制的 ChatGPT App,這在現實中不成立。
他們接著改用原生 HTML 附件投遞,但發現匯出成公開分享後,圖表會消失,附件卻留著——而圖表才是載入 MathLive、在主頁面裝上監聽器的關鍵。少了圖表,訊息發得出去,卻沒有人在聽。
真正的突破是把兩個元件放進同一段普通的公開對話:
- 一個真實的圖表讓 MathLive 在主頁面初始化;
- 一段由 assistant 產出的 HTML Preview 負責發送那兩則訊息。
產生的 /share/<id> 連結把整條鏈路完整保留下來。攻擊者可以用寄送任何一般分享對話的方式投遞它:電子郵件、即時通訊、客服工單、社交貼文。受害者不必安裝任何東西、不必加入攻擊者的工作區、不必走任何攻擊者控制的驗證流程,只要走訪這個網址。
在穩定重現版本中,受害者打開分享頁、點一次 ChatGPT 平常的 Preview 按鈕即可。研究團隊後來把 HTML 區塊標記為可預覽,讓 ChatGPT 自動開啟——那個版本裡,打開連結就是受害者的唯一一次點擊。他們在另一個帳號上重現了這條自動路徑三次,包含一次硬體重新整理後,警示大約在 4.5 秒後出現。
由於圖表與 Preview 是獨立載入的,payload 偶爾會在 MathLive 準備好之前就送出訊息;最終版本用「在一段有限時間內重試同樣兩則訊息」來處理這個競態,並用主頁面的 guard 確保外洩證明與對外請求各只執行一次。
「跳個提示」遠比「改個頁面」嚴重
做到這裡,payload 可以在頁面上顯示一個瀏覽器標示為來自 chatgpt.com 的警示框,還能加上一個橫幅到主頁面——這證明了程式碼跑在哪裡,但還沒證明為什麼重要。
真正的價值在於:這支 JavaScript 跑在 chatgpt.com 的身分下,所以它能用與正常網頁應用程式完全相同的已認證脈絡操作 ChatGPT。payload 讀取頁面上本來就有的 session 資訊,用它呼叫 ChatGPT 的對話 API:
GET /backend-api/conversations?...&limit=20&order=updated&offset=0
GET /backend-api/conversations/<conversation-id>?num_turns=2這是直接的已認證 API 存取,不是去撈畫面上剛好看得到的文字。目標對話跟那個惡意分享毫無關係,也從未分享給攻擊者。
拿到回應之後,把資料傳到站外就很簡單——payload 送出一個普通的圖片請求到他們自己控制的伺服器。研究團隊刻意只外傳回應中的一小段值,但注入的程式碼本來就已經拿到完整的已認證對話回應,能讀完它的內容。
換句話說,漏洞的極限並不侷限在對話端點。由於程式碼跑在與正常前端相同的已認證存取權限下,其他透過 ChatGPT 已認證前端 API 暴露的資料與操作,都在同一道安全邊界之內——基本上等於可以代替受害者執行任何帳號操作。
為什麼這件事重要
第一,這是「分享連結」的信任模型失效。 目前為止,大多數人看到 chatgpt.com 的分享連結不會提高警覺——它看起來就像別人貼了一段 AI 對話。駭客生態系裡,「假的 OpenAI 故障頁面掛在真實的 chatgpt.com/s/ 分享連結上」早就被實際用來投放惡意軟體了。這次發現把「連結本身無害」的假設直接拆掉:分享連結不只是內容,它還能是程式碼載體。
第二,這不是「OpenAI 的程式碼寫得爛」,而是「功能之間的縫隙」。 研究報告最後一段寫得很清楚:Preview 有隔離、圖表能載入數學鍵盤、frame 之間可以傳訊息、CSP 允許大型影音服務、公開對話可以分享——每一項單獨看都很合理,漏洞只在他們全部組裝在同一個頁面時才浮現。這類「跨功能測試」正是最容易被漏掉的類型,因為每一個功能都會各自通過安全審查。
第三,供應鏈風險被具體化了。 MathLive 是一個無害的數學輸入法函式庫,沒有人會把它列入威脅清單。但它的 originValidator 預設值 "none",加上 createHTML 用的是 identity 而非 sanitizer 的 Trusted Types 政策,這兩點讓它從「一個第三方 UI 元件」變成「跨信任邊界的橋樑」。任何在自家產品裡嵌入 MathLive 的團隊,理論上都暴露在同一條路徑上。
第四,這已經是同類問題的第二次。 在 Parameter 這次發現之前一個月,Check Point Research 就揭露過另一個 ChatGPT 沙箱跨帳號的資料外洩管道——同樣是「被信任的內部服務成了通訊橋」、同樣可以用分享對話當投遞方式、同樣能碰到受害者已連接的 Gmail。兩起事件路徑不同,但暴露的是同一個結構性問題:當 AI 產品的沙箱同時開放「執行不可信程式碼」與「跨元件通訊」兩項能力,邊界就不再只由沙箱決定。
第五,$5,000 這個數字本身就是一個訊號。 這是 OpenAI 認列的 P1 等級問題——可以列舉對話清單、讀取私密對話、把內容外傳、並以受害者身分執行操作——的回報獎金。HN 上有開發者直接指出,如果連這種等級的漏洞都只有五千美元,其他研究者可能就不會回報了。
數據解讀與質疑
關於「自動觸發」的說法要小心。 報告提到有兩個版本:穩定版本需要點一次 Preview 按鈕;後來的版本標記為可預覽而自動開啟,且在另一個帳號重現三次(含硬體重新整理後)。但重現次數是三次,且是在研究團隊自己控制的帳號上——沒有任何真實世界中被利用的紀錄。把它寫成「點開連結就自動被接管」會過度延伸。比較精確的說法是:至少需要一次點擊,且這個點擊完全落在使用者的正常操作路徑裡。
懸賞金額要跟同級別的基準比才有意義。 $5,000 聽起來像侮辱,但把它放進 OpenAI 自己的價目表裡看:Bugcrowd 上 OpenAI 計畫的 P1 獎金級距是 $2,000–$6,500,這筆報告拿到的是 P1 級距的中上段,不是底線。真正刺眼的是另一個數字——該計畫對「差異化關鍵發現」的懸賞上限是 $100,000,是這次的二十倍。同樣是 P1 認列,給多少完全落在主觀裁量區間;HN 網友的抱怨因此不是情緒,而是對「同一個嚴重度、寬度差二十倍」的合理疑問。
沒有 CVE 編號,這件事本身值得注意。 Ostorlab 明確記錄「未指派 CVE、無真實世界濫用紀錄」。OpenAI 對自家 web 前端的修補沒有走 CVE 流程,外部研究者要拿到「這個漏洞的權威識別碼」並不容易——這也代表資安情報的傳播效率取決於研究者願不願意公開細節。
修補的完整性仍有窗口。 時間軸清楚顯示:10/22 還有一個前端沒修,10/23 CSP 變更只「阻擋部分鏈路」,一直到 10/26 才確認兩個前端都拒絕該訊息。也就是說,10/18 到 10/26 這八天裡,修補狀態是不完整的。如果只看 10/22 的狀態就判斷「已修」,會是錯的。
而 OpenAI 的修補方式並非釜底抽薪。 報告直言:「YouTube 那個回應是繞過 CSP 的最後手段,不是根本原因。只擋掉那個端點,會移除一條通往 JavaScript 的路徑,但仍然留下不受信任的 Preview 能把 HTML 插入 ChatGPT 的事實。」也就是說,真正的修補點在於跨 frame 訊息的來源驗證與srcdoc iframe 的 sandbox 化,CSP 改動只是輔助防線。
Parameter 自己給的防禦建議,其實比很多人預期的更樸素:
- 訊息接收端應該同時驗證
event.origin與event.source,確認寄件者的網址與被授權的具體 window。 - 跨 window 的設定內容不應該承載原始 HTML。
- 動態建立的文件,在其內容可能受不受信任 frame 影響時,應維持 sandbox。
- CSP 應該是備援控制,而不是唯一屏障——當攻擊者控制的 HTML 已經進到主站,CSP 無法讓一條不安全的渲染路徑變安全。
真正收尾的,是上游那一刀
整起事件裡最有教育意義的轉折,發生在 10 月 31 日——比 OpenAI 的修補晚了五天。
MathLive 官方更新記錄出現了一個新的 Security 條目,版本 0.111.2:
虛擬鍵盤、proxy 與 mathfield 的訊息現在預設改為同源驗證。跨源的整合必須明確允許其信任的對等來源。proxy 回應與 mathfield 指令只接受來自預期鍵盤視窗的訊息,其餘訊息靜默忽略。
同時關掉了這條鏈路用到的每一扇門:
- 跨視窗鍵盤設定可以選擇內建版面,但無法再提供自訂版面或鍵帽覆寫——就算把 origin 驗證關掉也一樣。原始攻擊鏈賴以把原始 HTML 當成版面資料夾帶進去的路徑,從此不存在。
- 改變狀態的訊息被綁定到已連線的 mathfield 視窗,show 或 settings 訊息無法再指定新的指令接收者,另一個 frame 也不能在鍵盤可見期間趁機接管。
- 同源驗證不再把兩個不透明的
"null"origin 視為相同,也不再接受萬用字元作為寄件者 origin。
官方 API 文件也同步更新,originValidator 的預設值從 "none" 改為 "same-origin"。
這才是整起事件的正確修法:不是封鎖一個 YouTube 端點,而是讓「跨 frame 訊息預設不信任」成為函式庫的預設值。但有件事值得記上一筆——這個 changelog 條目完全沒提 ChatGPT、OpenAI 或 Parameter,也沒有列出任何 CVE 編號。這份修補來得正是時候(攻擊鏈的利用前提是預設值 none),卻沒有任何線索能證明它是因為這份報告而做的。
對已經在自家產品裡嵌入 MathLive 的團隊,現況是這樣:npm 上的 latest 標籤已經跳到 0.111.4,但 GitHub Releases 頁面最新一版仍停在 2024 年 6 月的 v0.100.0。只看 release 頁不足以判斷修補狀況,正確做法是直接 npm ls mathlive 查實際安裝版本,並且——因為 API 文件仍把 "none" 列為合法選項——顯式設定 originValidator,不要依賴預設值。
一句話總結
沙箱沒有被破,是橋的那一頭鬆了。 一個以 none 為預設的第三方函式庫、一個用 identity 而非 sanitizer 的 Trusted Types 政策、一個沒有 sandbox 的 srcdoc iframe,再加上一個被允許的第三方 JSONP 端點,四個各自看起來無害的決定串起來,就讓一個普通的 AI 對話分享連結變成完整的帳號接管工具。
OpenAI 已在 10 月 26 日修補,上游 MathLive 也已在 10 月 31 日改掉預設值,沒有任何真實世界的濫用紀錄。對一般使用者而言,現階段沒有需要採取的行動;但對把 MathLive 放進自己產品的團隊,這個故事還沒結束。
相關延伸閱讀
- Parameter Labs〈Do the Math: How We Took Over ChatGPT Accounts〉 — 原始研究報告
- frankchu〈A public ChatGPT share could run code as you〉 — 從 npm 套件原始碼獨立驗證兩個關鍵元件
- Ostorlab〈ChatGPT Shared-Link Account Takeover via MathLive Sandbox Escape〉 — 影響範圍評估與 MathLive 嵌入方的修補建議
- The Hacker News〈A Shared ChatGPT Link Could Run Attacker Code in Your Session〉 — 主流資安媒體報導
- MathLive 官方更新記錄 — 0.111.2(2026-10-31)把訊息驗證預設改為同源
- Mathfield API Reference —
originValidator現行預設值與合法選項說明 - Check Point Research〈The Shared Clipboard Inside the Sandbox〉 — 2026 年 9 月同類型的 ChatGPT 沙箱跨帳號漏洞
- Bugcrowd:OpenAI 漏洞獎金計畫 — P1 獎金級距與 $100,000 上限
- Hacker News 討論串(356 分/173 則回覆) — 開發者社群討論
網友熱門留言 (10)