編按:本文綜合整理自 GVS5H 論文〈Zero-Shot Self-Orchestration with Ledger-Based Control Improves Coding in Language Models〉(arXiv:2608.26480)、GVS5H 官方程式碼倉庫(slee-persis/GVS5H)、Memdoor 的 team-solve 復現工作流說明、Memdoor 官方結果頁、LiveCodeBench 官方網站、Hacker News 討論串(428 分/208 則回覆) 與 GVS5H 原始發表討論串,並加入 Siami 編輯部觀點與分析。
2026 年 10 月 31 日,GitHub 上一個名為 Memdoor 的開源專案丟出一份自我復現報告,標題寫得很直接:五個 Qwen3.8-27B 組隊,在 LiveCodeBench Hard 上打贏 Claude Fable 5。報告貼上 Hacker News,一夜之間累積 428 分、208 則回覆,成為近期社群熱度最高的一則 AI 工具消息。
但這則消息真正值得看的地方,不在「小模型贏了旗艦模型」這種標題式敘事。拆開看,這場勝負的關鍵不是任何新模型、不是新訓練資料、也不是更強的推理能力——贏家是「分工」這件事本身,而把這個分工機制用程式碼寫成八個 YAML 檔的,正是 Memdoor。
一個 27B 模型,怎麼變成五個角色
Memdoor 是一個以 Go 寫成、單一靜態執行檔的開源 coding agent(Apache 2.0 授權),沒有 Docker、不需要 Python,可在本機跑,也能透過 SSH 連到遠端機器執行。這次發表的 team-solve 範例,是把 Persis Capital 研究室論文 GVS5H 的方法重寫成一個工作流:八個 YAML 檔、零行程式碼,而且完全不綁定任何模型名稱。
工作流程的結構長這樣:
plan ──┬── ideate-a ──┬── solve ── test ── review ── repair ── verify
       └── ideate-b ──┘
六個角色分工非常明確:
- plan:讀題目,寫出總體策略計畫
- ideate-a/ideate-b:兩個 ideation 角色平行提出不同家族的演算法解法
- solve:讀兩份提案,挑一份寫成程式
- test:執行測試,輸出結果日誌(這一步永不讓整條流程失敗)
- review:讀測試結果,寫下修復指示
- repair:依指示改寫程式
- verify:再跑一次測試,這次失敗才會讓整條流程失敗
關鍵在於每個角色的提示詞只有一句話:「全新 context,讀檔案,不要依賴聊天紀錄。」角色之間不直接對話,全部透過磁碟上的 plan.md、notes.md、solution.py 溝通——論文把這個結構稱為「帳本」(ledger)。
論文原始數據:同一個模型,+25.6 個百分點
Memdoor 復現的是 2026 年 9 月 21 日更新的論文 GVS5H,全名是〈GVS5H: Zero-Shot Self-Orchestration with Ledger-Based Control Improves Coding in Language Models〉。作者群來自 Persis Capital Inc.:Victor Gao、Vida Khosrowshahi、Ali Khosrowshahi、Xihao Sun、Juhyun Lee、Ethan Tran 與 Simon (Sang Won) Lee。
這是一個不需要訓練(training-free)的方法:所謂零樣本自我編排,意思是協調者本身既沒有被訓練成協調器,也沒有拿到任何針對具體任務的分解示範。論文在 LiveCodeBench code-generation release_v6 的 hard split 中,依競賽日期取最新的 100 道題(稱為 LCB-100),測了十一種開放與封閉權重模型,每種模型跑五個獨立回合。
論文表格 1 的關鍵幾列如下:
| 模型 | 單次呼叫 | 多代理協作 | 增幅 | 成本比 |
|---|---|---|---|---|
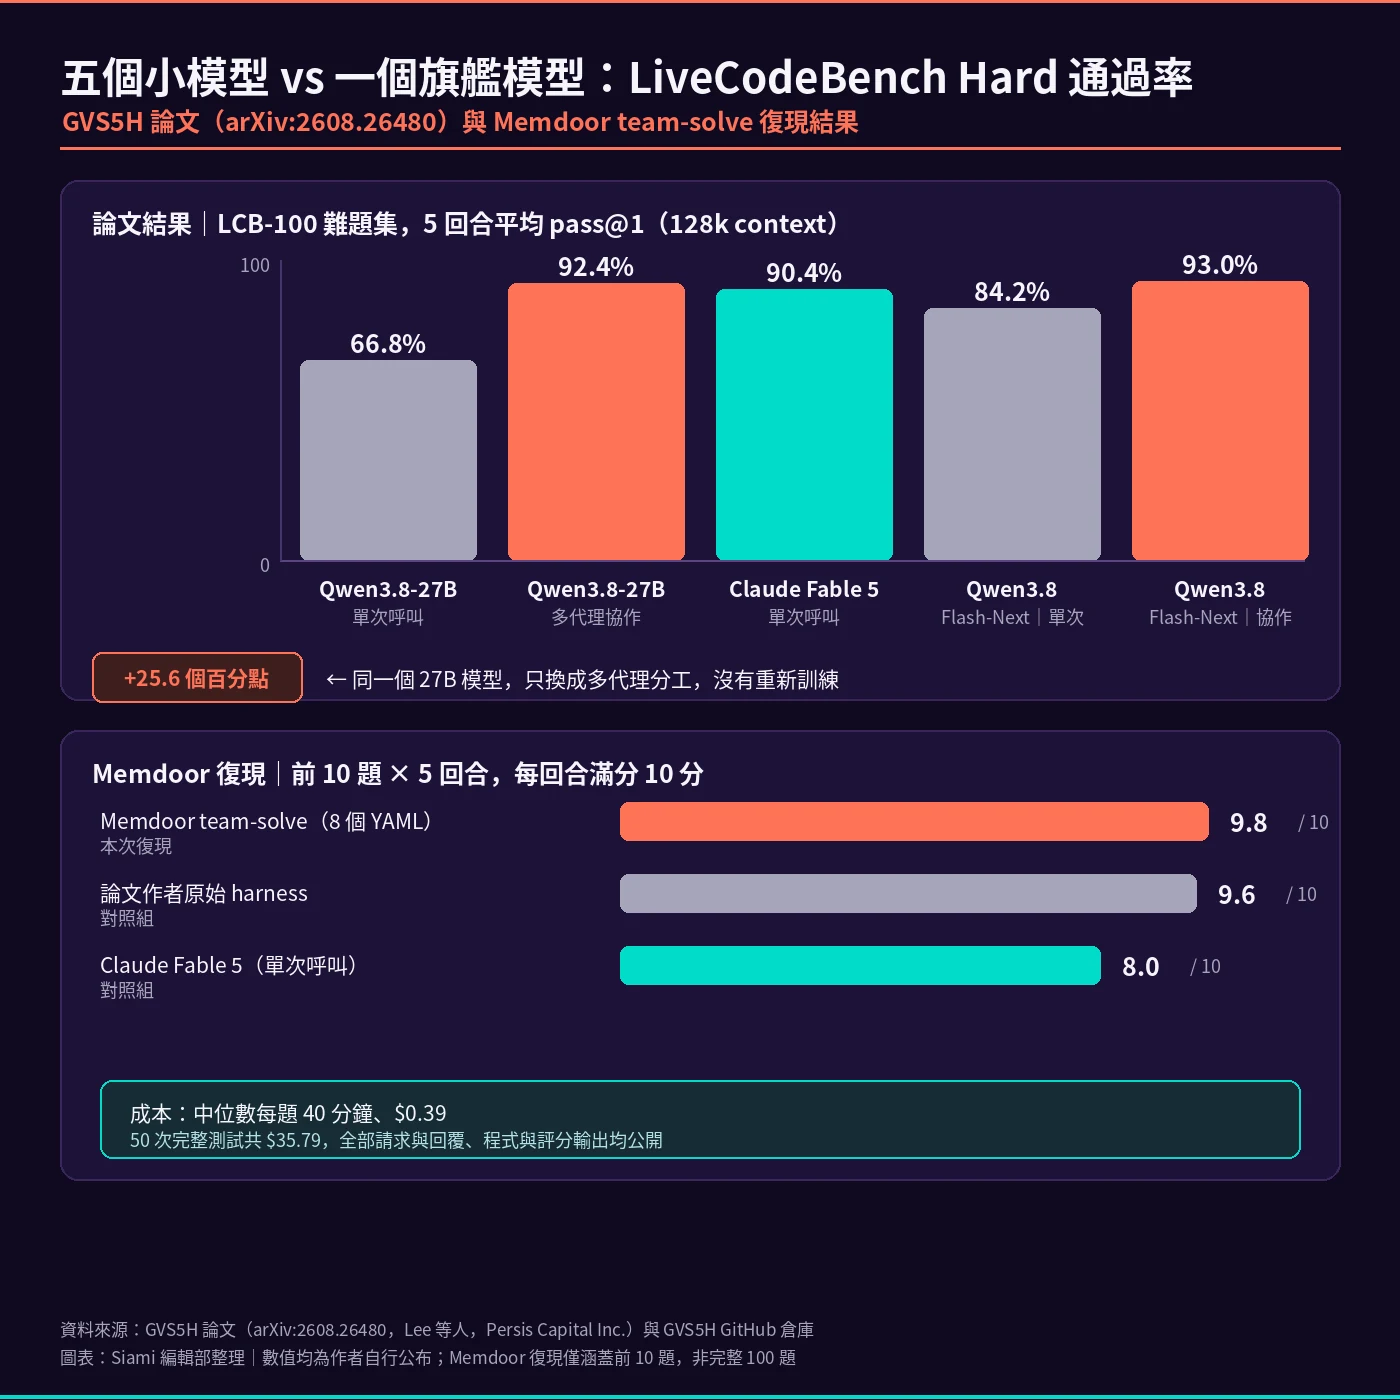
| Qwen3.8-27B | 66.8 ± 5.2 | 92.4 ± 2.3 | +25.6 | 0.88 |
| Qwen3.8-Flash-Next | 84.2 ± 1.8 | 93.0 ± 1.2 | +8.8 | 0.56 |
| GPT-5.6-Terra | 80.8 ± 1.0 | 88.0 ± 1.2 | +7.2 | 0.88 |
| GPT-5.6-Luna | 70.4 ± 4.6 | 81.2 ± 2.8 | +10.8 | 0.0013 |
| DeepSeek-V4.1-Flash | 88.4 ± 2.6 | 92.0 ± 1.8 | +3.6 | 0.002 |
| Claude Fable 5 | 90.4 | — | — | 1.00(僅單次) |
最引人注目的是 Qwen3.8-27B 那一列:同一個模型、同一份權重、同一個 128k context 上限,只是把「一次呼叫」換成「多代理分工」,通過率就從 66.8% 跳到 92.4%,一舉越過 Claude Fable 5 的 90.4%。而 Qwen3.8-Flash-Next 協作後的 93.0%,在論文摘要裡被描述為「只有 Fable 5 成本的 9%」。
論文同時承認,增益並非普適:有些模型不動、甚至變差。逐段分析 transcript 後,作者把增益歸因於兩件事——任務分解與持續脈絡的保留。所謂持續脈絡,就是 notes.md 這個檔案把前一個 worker 的想法與中間發現帶到下一個 worker,而不是每次重來。
為什麼這件事重要
第一,這把「模型能力」跟「系統組織方式」兩個變因拆開了。過去兩年業界習慣的直覺是:想要更強的程式能力,就換更大的模型、付更高的 API 費用。GVS5H 的數據提出了一個不太舒服的替代方案——在某些編程任務上,把既有模型拆成會透過檔案協調的團隊,可能比升級到旗艦模型划算得多。Qwen3.8-27B 單次呼叫只有 66.8%,這是一個放在排行榜上會讓人直接略過的分數;加了分工之後變成 92.4%,跟 Fable 5 站在同一個量級。
第二,它直接對應到本地部署的現實。Qwen3.8-27B 是 2026 年 8 月 14 日發布的 27B 稠密模型,262k context,一般消費級 GPU 跑得動;Memdoor 本身支援 memdoor connect local 直接接 Ollama、llama.cpp、vLLM、LM Studio,完全不需要 API key。也就是說,這場「打贏 Fable 5」是可以發生在一台自己家裡的機器上的——前提是評測口徑成立。
第三,這是一種可攜的「工程範式」而不是單一技巧。Memdoor 的工作流不指定模型,換成任何模型都能跑;論文本身測了十一種模型。對正在做 coding agent 的團隊來說,這意味著 harness(編排層)本身是一個值得獨立投資、獨立量測的組件,而不該被當成「模型開箱即用的附屬品」。
第四,可驗證性。Memdoor 這次把 50 次測試的每一則請求、每一則回覆、每一份程式、每一次評分輸出與花費全部公開,並附上與作者原始 harness 逐位元比對的 parity 檢查筆記。相較於多數「某某打贏了某某」的宣稱,這種公開原始軌跡的做法本身就是值得學習的發表方式。
數據解讀與質疑
必須說清楚的是,Memdoor 的復現結果不等於重現了論文的主張,而論文的主張本身也有明確邊界。
Memdoor 這次只跑了 10 道題 × 5 回合,論文跑的是 100 道題 × 5 回合。依 Memdoor 自己的說法,9.8 與 9.6 在統計上是噪音範圍內的差距,所以準確的說法是「與作者 harness 打成平手」,而不是「超越」。它自己也在 README 裡把這點列為第一條限制。
第二,污染問題未被排除。LiveCodeBench 的設計初衷是持續收集新題目以降低訓練資料污染,但這批 hard 題目的競賽日期落在 2025 年春季,模型完全可能見過。作者對所有欄位都沒有宣稱排除污染。
第三,Fable 5 的對照組不對等。Fable 5 在論文中只跑了單次呼叫(single-only),而所謂「五個小模型打贏 Fable 5」的對比,是拿一個多代理系統對上旗艦模型的單次輸出。Hacker News 上一則留言的追問相當尖锐:「我們怎麼知道 Fable 5 背後其實也是一群模型的 swarm?」 換句話說,如果旗艦模型背後同樣有類似的編排層,這場比較的前提就得重估。
第四,驗證訊號覆蓋率不足。論文第五步的 verifier 只跑 stdin 格式的公開測試,100 題中只有 73 題具備;其餘 27 題是 LeetCode 風格的 call-based 測試,拿不到任何 verifier 回饋,只能靠隱藏測試評分。
第五,失敗模式會互相放大。Memdoor 自己在結果頁坦白記錄:有一次 manager 發明了一個錯誤的反例,整個團隊於是把一份正確的程式改錯了;還有兩次在別處出現正確程式被覆蓋、後來又被救回。論文也揭露 Qwen3.8-27B 在 500 次單次呼叫中有 150 次撞到 token 上限、35 次直接拒答不產出程式——這些都照實計為失敗而沒有被替換掉。
第六,紙上更強的數字其實是 Flash Next 的 93.0%,那個模型並不是 27B,而且 Memdoor 這次也沒有重跑它。社群裡也有人直接點名,認為「Qwen Flash Next 的結果才是真正有趣的部分」。
綜合來看,這是一份方法論上相當紮實、但口徑上需要保守表述的工作。誠實的結論是:同一個 27B 開源模型在多代理編排下,可以逼近甚至在特定子集上超越旗艦模型的單次輸出;而不是「開源模型已經打贏閉源模型」。
開發者現在能做的事
想自己試一遍的成本其實不高:
- 先看方法論:讀論文與 GVS5H 倉庫,重點是帳本檔案結構(
task.md/plan.md/notes.md/solution.py)與「全新 context + 只靠檔案溝通」這兩條規則。 - 看復現軌跡:Memdoor 把 50 次測試的完整紀錄公開在
bench/results/parity-5pass/,包含每次請求與回覆、程式碼與評分輸出,可用來比對自己的實作。 - 用本地模型跑:
memdoor connect local接上 Ollama、llama.cpp、vLLM 或 LM Studio(Ollama 需要把 context window 從預設 4K 拉到 32K 以上),就不需要任何 API key。 - 注意成本結構:Memdoor 的量測是中位數每題 40 分鐘、$0.39,50 次完整測試共 $35.79、總輸出 15.3M tokens。時間成本往往比 token 成本更值得留意——論文也提到 Qwen3.8-27B 在難題上光是 planner 就能燒掉 32K tokens 的推理量而沒寫出計畫。
- 不要過度外推:這套方法目前在程式競賽題型上驗證,Hacker News 上也有人提醒「harness 會隨著模型智力提升而需要重新調整」,照抄一套別人調好的 YAML 流程到不同任務上,很可能適得其反。
延伸閱讀
(OpenAI 的 Ryan Lopopolo 在 Latent Space 頻道談 harness 工程:百萬行程式碼、每日十億 token、不經人手審查。同一個問題的另一種規模示範。)
(Fahd Mirza 實測 Qwen3.8-27B 在本機完整跑起來的表現,檢視這顆開源模型到底有沒有吹牛。)
若要追蹤這條線的後續,可參考 LiveCodeBench 官方排行榜與評測方法說明,以及 Memdoor 官方的 team-solve 結果頁。
網友熱門留言 (8)